LLM Course:大语言模型全栈学习指南
想象你刚接手一个使用大语言模型的客服项目,产品经理要求你在两周内把模型从 GPT-3.5 切换到开源方案,同时优化推理成本。你打开搜索引擎,输入"如何微调Llama",扑面而来的文章有讲 PyTorch 梯度的、有讲分布式训练的、有讲量化压缩的——方向太多,根本不知道从哪开始。LLM Course 就是为这种"站在交叉路口"的开发者设计的:它把大语言模型的学习路径整理成一张完整的地图,从数学基础到模型训练、从微调技术到部署上线,一站式覆盖。
项目背景与作者
LLM Course 由 Maxime Labonne(现任 Liquid AI 后训练负责人)创建和维护。Liquid AI 是由前 MIT 教授创立的新型 AI 公司,专注于高效神经网络架构。Labonne 同时是 Hugging Face 社区的知名贡献者,个人页面拥有 6800+ 粉丝,著有《LLM Engineer's Handbook》一书(由 Packt 出版),在 GitHub 上还维护着 LLM Datasets、llm-autoeval 等多个热门工具库。
这个项目诞生于 2023 年 ChatGPT 爆发后的学习热潮中——彼时市面上大模型相关的教程碎片化严重,没有一套系统化、覆盖"从理论到工程"完整链条的学习资源。LLM Course 填补了这个空白,短短两年时间 star 数突破 79,000,成为 GitHub 上最受欢迎的 LLM 学习项目之一。
核心内容:三阶段学习路径
LLM Course 将 LLM 学习划分为三个递进阶段,每一阶段都有明确的学习目标和资源推荐:
🧩 第一阶段:LLM Fundamentals(基础准备)
这是整个课程的"热身区",覆盖机器学习所需的数学和编程基础。如果你是数学或 Python 科班出身,可以跳过;如果你来自非技术背景,这里提供了系统性的补习路径:
- 数学基础:线性代数(向量、矩阵、特征值)、微积分(导数、梯度、积分)、概率统计(贝叶斯推断、最大似然估计)。推荐资源包括 3Blue1Brown 的线性代数视频系列和 Khan Academy 的互动课程。
- Python 技能:掌握 Python 基础语法后,重点学习 NumPy、Pandas、Matplotlib、Seaborn 等数据科学库,以及 Scikit-learn 中的经典 ML 算法(线性回归、决策树、K-means 等)。
- 神经网络基础:理解 MLP(全连接网络)的构建、训练流程、反向传播、梯度下降优化器(Adam、SGD),并用 PyTorch 从零实现一个多层感知机。
- NLP 入门:学习文本预处理、TF-IDF、词嵌入(Word2Vec、GloVe)、RNN/LSTM/GRU 等序列模型基础。
🧑🔬 第二阶段:The LLM Scientist(模型科学家)
这一阶段聚焦于如何训练和优化大语言模型本身,是课程的技术核心:
- LLM 架构:深入理解从 Encoder-Decoder Transformer 到 Decoder-Only GPT 的演进路径;掌握 Tokenization(Tiktoken、SentencePiece)、Attention 机制(Self-Attention、Multi-Head)、采样策略(Greedy、Beam Search、Nucleus Sampling)。
- 预训练:虽然完整预训练需要海量算力,但课程讲解了数据准备(FineWeb 15T token 数据集)、分布式训练策略(Data/Pipeline/Tensor Parallelism)、混合精度训练等概念,并推荐了 OLMo2、LLM360 等开源训练框架。
- 后训练数据集:重点讲解 SFT(监督微调)和 RLHF/DPO(偏好对齐)所需数据集的构建方法:合成数据生成、数据增强、质量过滤(MinHash 去重、Reward Model 排序)。
- 微调技术:详细覆盖 QLoRA(最流行的消费级 GPU 微调方法)、ORPO(单阶段对齐训练)、DPO(直接偏好优化)、Axolotl(主流微调工具)等前沿技术,每个技术都配有 Colab Notebook 演示。
- 模型量化:讲解 GPTQ、GGUF、AWQ、EXL2、HQQ 等主流量化格式的原理和实践,帮助将大模型压缩到能在本地消费级显卡上运行。
- 模型合并:使用 MergeKit 将多个微调模型合并成新的混合模型(如 Phi-3 + OpenChat 合并),创造性能超越父模型的新变体。
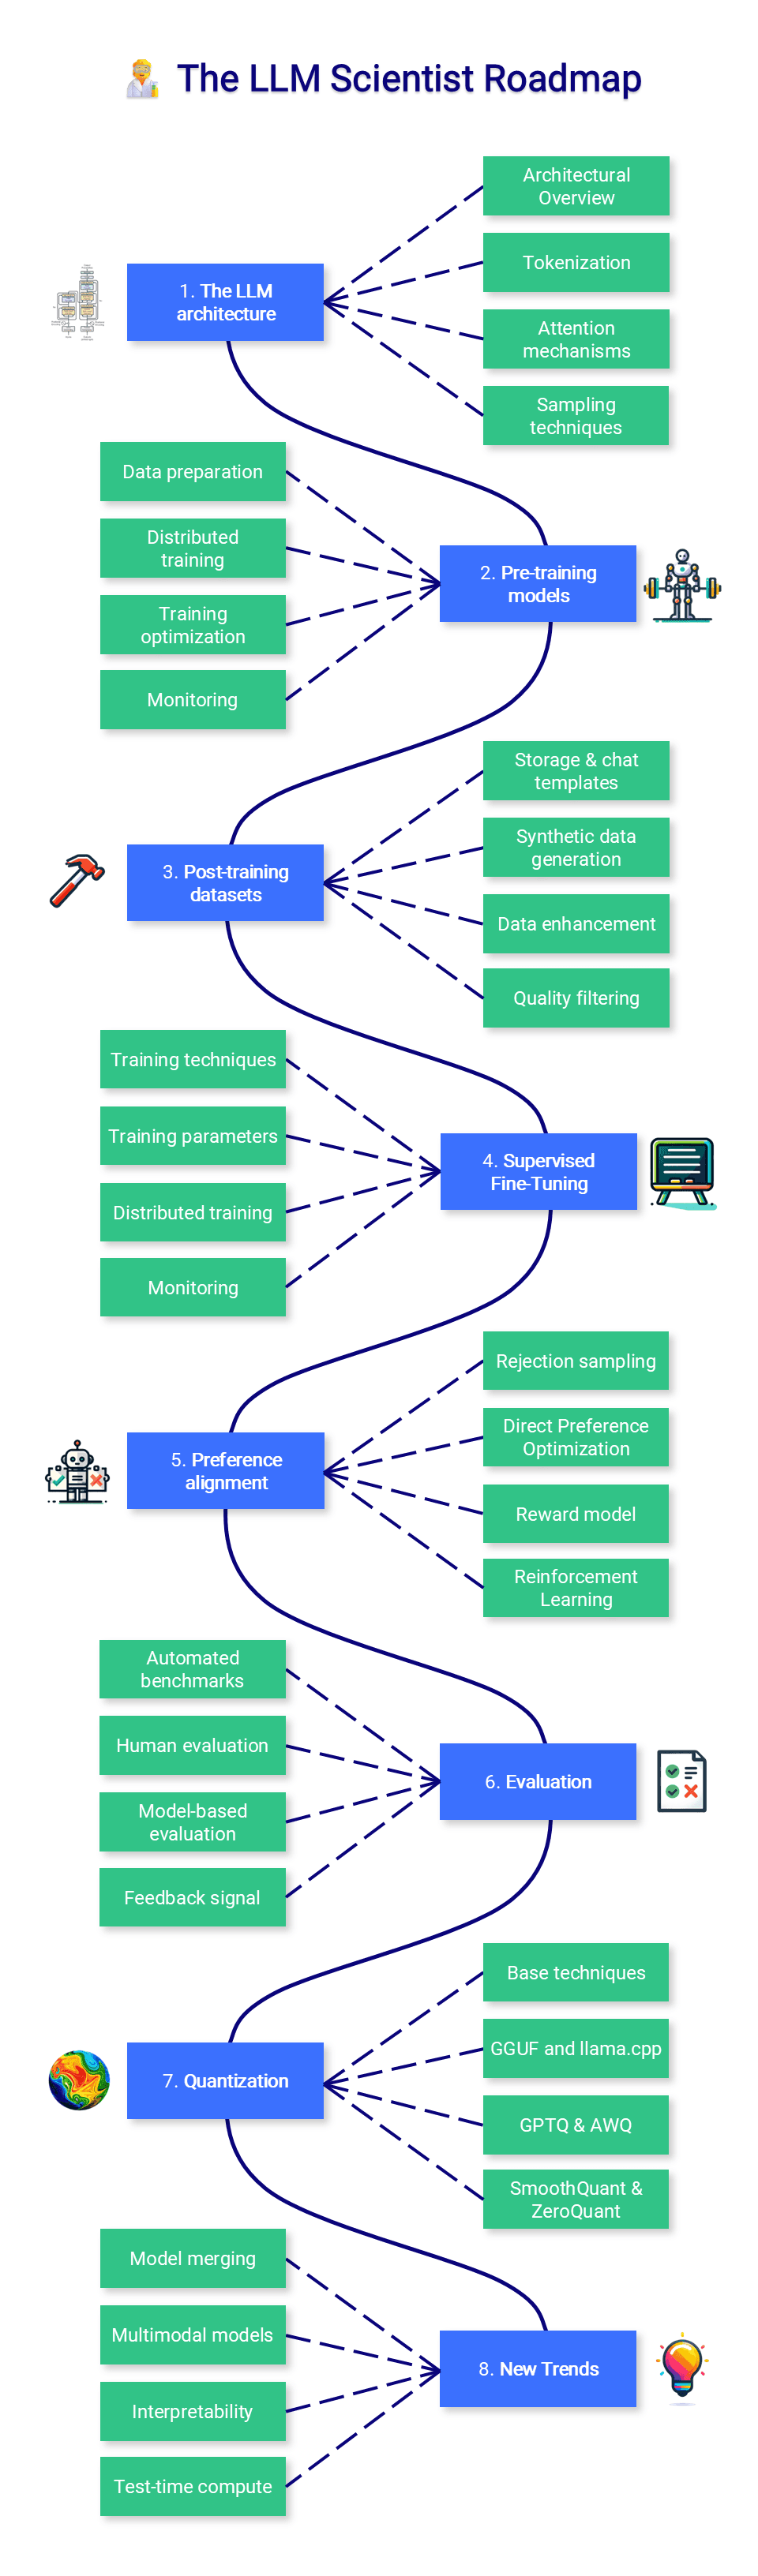
图1:The LLM Scientist 完整学习路线图,涵盖从模型架构到合并量化的全链条
👷 第三阶段:The LLM Engineer(应用工程师)
这一阶段转向如何基于 LLM 构建实用应用:
- 运行推理:使用 Ollama、llama.cpp、GPT4All 等工具在本地运行量化模型。
- RAG(检索增强生成):构建知识库、实现向量检索(FAISS、ChromaDB)、优化检索策略。
- Agent 系统:构建自主 Agent、工具调用、多步骤推理链。
- 监控与安全:LLM 可观测性、日志记录、提示注入防护。
特色工具库:把教程变成生产力
LLM Course 不只是文字教程,每个知识点都配有可直接运行的 Colab Notebook,作者还开源了配套工具库:
| 工具 | 功能 | 访问方式 |
|---|
| LLM AutoEval | 自动评估模型性能,发布到排行榜 | Colab 一键运行 |
| LazyMergekit | 一键合并模型 | Colab 一键运行 |
| LazyAxolotl | 云端微调模型 | Colab 一键运行 |
| AutoQuant | 量化模型(GGUF/GPTQ/AWQ/HQQ) | Colab 一键运行 |
| AutoAbliteration | 模型去抑制(移除安全限制) | Colab 一键运行 |
| ZeroSpace | 免费 Gradio 部署 | Colab 一键运行 |
这些工具的核心理念是**"一键化"**——将原本需要配置环境、安装依赖、写脚本的复杂流程,封装成单个 Colab 链接,点击即可运行。对于没有高端 GPU 的学习者来说,这种设计大幅降低了实践门槛。
技术架构分析
从代码角度看,LLM Course 的"产品形态"非常特殊:它本质上是一个高度结构化的 Markdown 文档仓库,而非传统意义上的代码项目。
- 内容组织:使用 Markdown + 表格 + details/summary HTML 标签 构建可折叠的学习大纲,兼顾信息密度和阅读体验。
- 技术栈:虽然项目本身是纯文档,但关联内容涉及 Python(数据处理、微调)、PyTorch(模型训练),覆盖了 LLM 全栈技术栈。
- AI 框架:项目涉及几乎所有主流 LLM 框架,包括 Hugging Face Transformers/TRL、Axolotl、MergeKit、llama.cpp、Ollama、VLLM 等,代表了当前开源 LLM 生态的核心工具链。
- 数据隐私:作为纯学习资源,无任何用户数据收集或云端通信,纯本地使用。
上手指南
对于 AI 爱好者,建议按以下顺序学习:
- 先通读 README 了解整体结构
- 根据自身背景选择入口:零基础从 Fundamentals 起步,有 ML 基础可直接进入 Scientist 阶段
- 每个章节配合 Colab Notebook 亲手实践
- 完成后可购买《LLM Engineer's Handbook》深入扩展
对于 AI 开发者,可以将这个项目作为技术雷达:定期查看更新,快速了解 LLM 领域的最新进展(如新量化方法、新微调算法),节省自己搜集信息的时间。
局限与争议
坦诚地说,LLM Course 也存在一些局限:
- 内容深度:作为入门到中级教程,某些高级主题(如分布式预训练的工程细节)只能点到为止,需要配合论文和源码继续深挖。
- 内容时效性:LLM 领域发展极快,课程中某些推荐工具可能已被新框架取代,需要读者自行关注最新动态。
- 硬件门槛:虽然 Colab 提供了免费 GPU,但部分 Notebook(如大模型量化合并)仍然需要高端消费级显卡才能流畅运行。
行业意义
LLM Course 的成功折射出一个更大的趋势:随着开源大模型能力的快速提升,"如何用好 LLM"正在成为比"如何训练 LLM"更重要的技能缺口。这个项目恰好填补了这个缺口——它不是教你训练一个 GPT-4,而是告诉你如何在实际工作中驾驭开源模型、构建应用、优化性能。
从增长曲线看,该项目从 0 到 79K star 的背后,是整个开源 LLM 生态从"技术探索期"走向"工程落地期"的缩影。随着更多企业级 LLM 应用落地,这类实操型学习资源的需求只会越来越大。

