
superbenchmark
microsoft/superbenchmark加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2020 年底,Azure 的 A100 集群里出现了一个很折磨人的现象:机器没有报错,任务没有崩溃,但同样的训练任务,跑得越来越慢。运维团队排查到凌晨也找不到坏件——因为坏的并不是某一个部件,而是部件的性能在缓慢劣化。
微软研究院把这类现象称为 gray failure(灰色故障)。它的成因恰恰来自云基础设施最引以为傲的冗余设计:GPU 集群里每台机器都有多卡、多路互联、多层硬件冗余,任何一路降级都不会立刻中断服务,系统会静默地切换到冗余路径继续跑。冗余把「显性故障」变成了「隐性劣化」——集群看起来 100% 健康,实际可用算力却一直在流失。
SuperBench 就是为解决这个问题而生:在 GPU 集群交付给用户之前,主动跑一轮基准,把灰度劣化的节点筛出来。
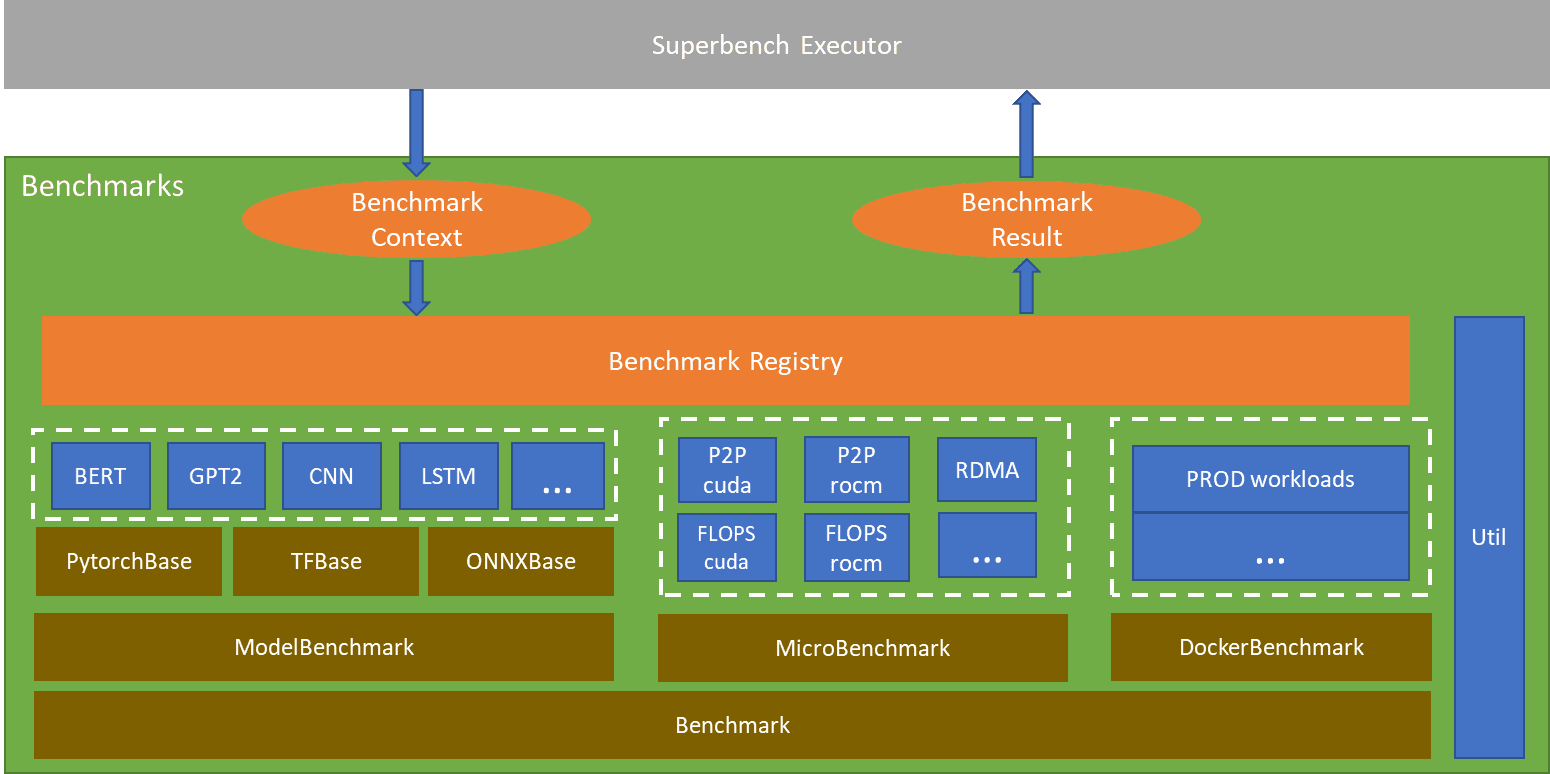
图:SuperBench 的三层基准体系——微基准、模型基准、分布式基准
SuperBench 的定位是「AI 基础设施的验证与剖析工具」(A validation and profiling tool for AI infrastructure),它不训练模型,而是回答一个更底层的问题:这块硬件和这套软件栈,现在到底还剩多少真实性能?
论文发表在 USENIX ATC '24 并获最佳论文奖,核心机制由两个模块构成:
在 Azure 生产环境实测:这套机制识别出 10.36% 的节点存在缺陷,把平均故障间隔(MTBI)提升 22.61 倍,同时把校验时间成本压低了 92.07%。整套基准已经在 Azure 上跑了两年多,累计校验了数十万张 GPU。
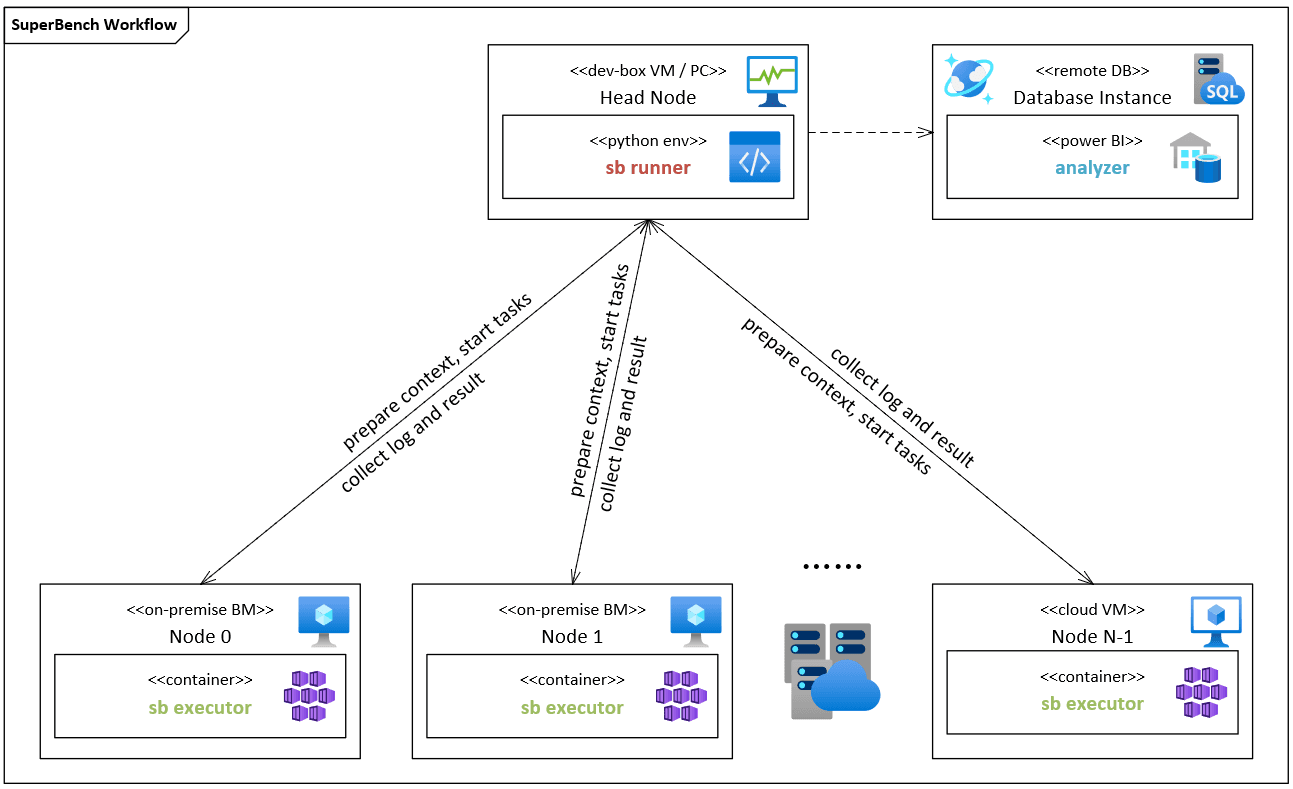
图:SuperBench 的执行链路,从节点选择到基准分发再到结果回传
如果把 GPU 集群比作一支车队,SuperBench 就是一套出车前体检制度:不是等车在半路抛锚了才修,而是在每次发车前跑一遍体检,把那些「刹车片磨薄了但还能跑」的车辆先撤下来保养。
它的基准套件分三层:
一句话概括:微基准负责「定位哪个部件坏了」,模型基准负责「证明对用户到底影响多少」。
SuperBench 本身是个 Python CLI(sb 命令),安装很简单:
pip install superbench
但真正的门槛在环境。仓库里的 dockerfile/ 目录准备了 CUDA 11.1.1 / 12.2 / 12.4 / 12.8 / 12.9 / 13.0 / 13.4、ROCm 5.0~6.4 以及 DirectX 12 等十余种镜像定义,全部基于 nvcr.io/nvidia/pytorch:24.03-py3,内置了 MLNX_OFED、Mellanox HPC-X、OpenMPI、Ansible 等重型依赖。
它的运行模型是控制节点 + 受管节点:控制节点上跑 sb deploy 把环境分发到所有受管节点,再由 sb run 触发基准执行;多机场景通过 Ansible Playbook 编排,需要准备 SSH 免密和节点清单。
对于没有 GPU 的团队,仓库 examples/benchmarks/ 下的 CPU 侧基准(CPU HPL、内存带宽、磁盘性能)也可以单机跑通——但那样就失去了这个工具最有价值的部分。
setup.py 与 pyproject.toml 并存、CI 里还有 y apf 这类已并入 Ruff 的旧工具链痕迹,长期维护下去有历史包袱积累的风险。SuperBench 代表的趋势很清楚:AI 基础设施的竞争,正在从「堆多少卡」转向「每张卡真正贡献多少有效算力」。当 GPU 供给紧张、算力成本高企时,一家云厂商真正的差异化不再是卡的数量,而是这些卡在交付给客户之前被验证得有多干净。
这也是为什么它的基准被硬件厂商广泛采纳为出厂验收标准——因为它定义了一套关于「什么算健康」的公共语言。
微软在 MIT 协议下开源了全部基准与诊断规则代码,任何团队都可以拿它来给自家的 GPU 集群做一轮交付前体检;如果你的团队正被「机器没报错但训练变慢」的问题折磨,这个项目值得认真试一次。
项目维护方:Microsoft
