
hve-core
microsoft/hve-core加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
打开 microsoft/hve-core 的第一反应通常是"这又是哪路 AI 框架"。但翻完目录你会发现,它里面几乎没有传统意义上的"代码":3081 个文件里有 1205 个是 Markdown,272 个 PowerShell 脚本,剩下的是 YAML 和少量 TypeScript。它不训练模型,不提供 API,也不跑一个常驻服务。
那它是什么?
它是微软开源的一套 智能体化软件生命周期(agentic SDLC)框架——说人话,就是"教 GitHub Copilot 怎么像一个有规矩的资深工程师那样干活"。仓库的核心命题写在其 README 首页:"AI carries the rules, humans keep the judgment."(AI 负责携带规则,人类保留判断力。)
截至分析时,它已经积累了 1605 Star、353 Fork、约 104 位贡献者、1150 次提交,MIT 协议,且仍在高频更新(最近一次推送就在分析当天)。这个体量说明一件事:企业真正缺的从来不是更强的模型,而是把组织规范变成 AI 可执行的流程。
过去两年,团队用 AI 写代码的痛点已经从"AI 不会写"变成"AI 写得不对但看起来很像对的"。于是行业出现了两条应对路线:一条是堆更长的系统提示词,一条是干脆放弃 Copilot、自建 Agent 平台。HVE Core 选了第三条路——不改模型,改模型的工作环境。
它的做法是把企业里那些平时散落在 wiki、Confluence、评审清单、规范文档里的知识,拆解成三种 AI 原生资产:
| 资产类型 | 作用 | 仓库中规模 |
|---|---|---|
Agents(.github/agents/) | 面向具体角色的专用智能体,如代码评审、安全规划、无障碍审查、架构评审 | 182 个文件、约 60 个 Agent 定义 |
Instructions(.github/instructions/) | 按语言/技术栈自动生效的编码规范,如 C#、Rust、Terraform、Bicep、Python 测试 | 81 个指令文件 |
Skills(.github/skills/) | 可复用工作流,带斜杠命令入口(/rpi-research、/rpi-plan、/hve-builder 等) | 14 个技能包、近 1500 个文件 |
其中最核心的是 RPI 工作流——Research(研究)、Plan(计划)、Implement(实现)、Review(评审)。设计理念相当精巧:它不追求"每一步都跑全",而是先做证据就绪度评估,证据充分时直接复用并记录"为何跳过",只有出现真实缺口时才激活研究阶段。
RPI 还给每个任务发一个稳定 ID(Pxx 阶段、Pxx-Txx 任务),并在文档里嵌入 <!-- rpi:... --> 标记,使计划与代码变更之间保持可追溯。计划产物落在 .copilot-tracking/plans/{日期}/{任务}-plan.md,评审产物落在 .copilot-tracking/reviews/...。
如果把 AI 编程助手比作一个聪明但没有入职培训的新人,那么大多数团队的做法是给他一份自由发挥的空间,然后靠 code review 兜底。HVE Core 的做法更像制造业的作业指导书(SOP)体系:每道工序有标准动作、检查表、异常处理路径,关键工序必须由持证人员签字。
而且它非常强调"人保留判断力"这条边界,规则层面直接写死:Agent 永远不得勾选人工评审复选框(- [ ] Reviewed and validated by a qualified human reviewer),只能由人把 [ ] 改成 [x]。这类约束说明作者非常清楚 AI 自治的边界在哪里。
这个仓库真正的工程含量藏在治理层,而非 Agent 定义里:
zizmor(GitHub Actions 静态分析)、CodeQL 门禁、action-pin-provenance(校验 Action 固定版本的来源可信度)、dependency-pinning(依赖未固定即失败)、poutine(IaC 安全扫描)、gitleaks、syft(SBOM)、audit-ci(npm 审计)、pip-audit(Python 依赖审计)lint:ai-artifacts 校验 Agent/技能产出的制品完整性,lint:models 维护模型引用目录,lint:design-intent 校验设计意图声明——这是把"AI 写的规划文档"本身当作需要评审的制品lint:version-consistency、lint:tool-version-consistency、lint:adr-consistency(架构决策记录一致性)、lint:frontmatter(带 JSON Schema 强校验)evals/ 目录包含 7 套基于 @microsoft/vally-cli 的评测规范,覆盖技能质量、Agent 行为、多轮一致性、脚本验证、基线等价性等,甚至有专门检查"定制后是否偏离模型基线行为"的等价性套件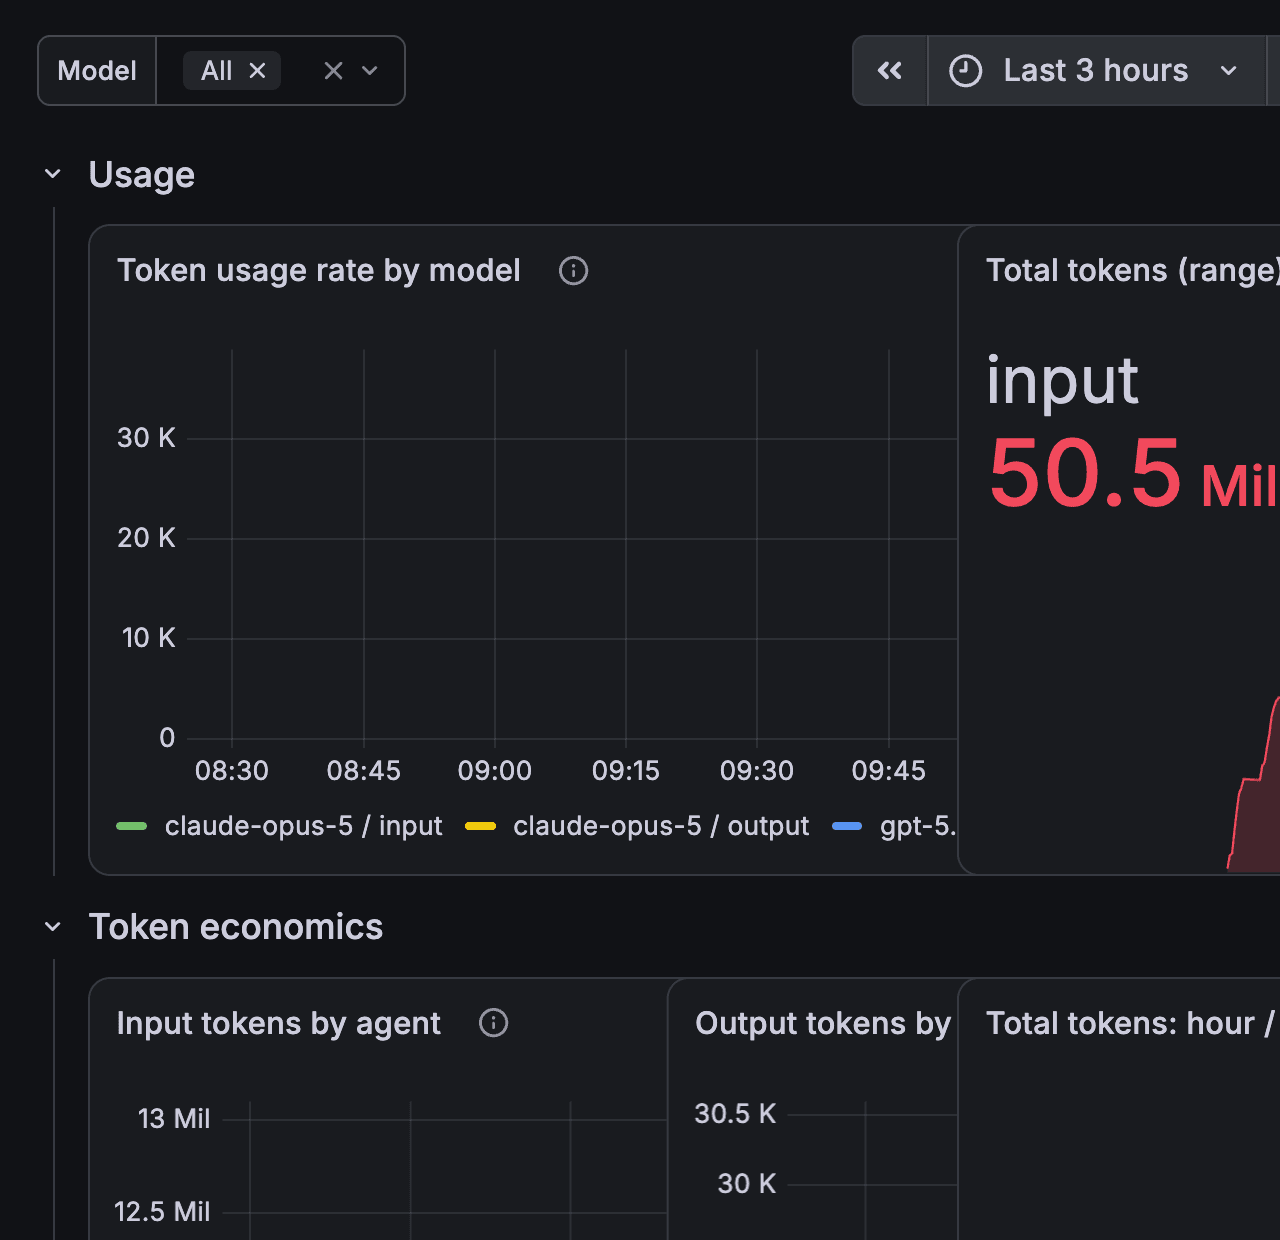
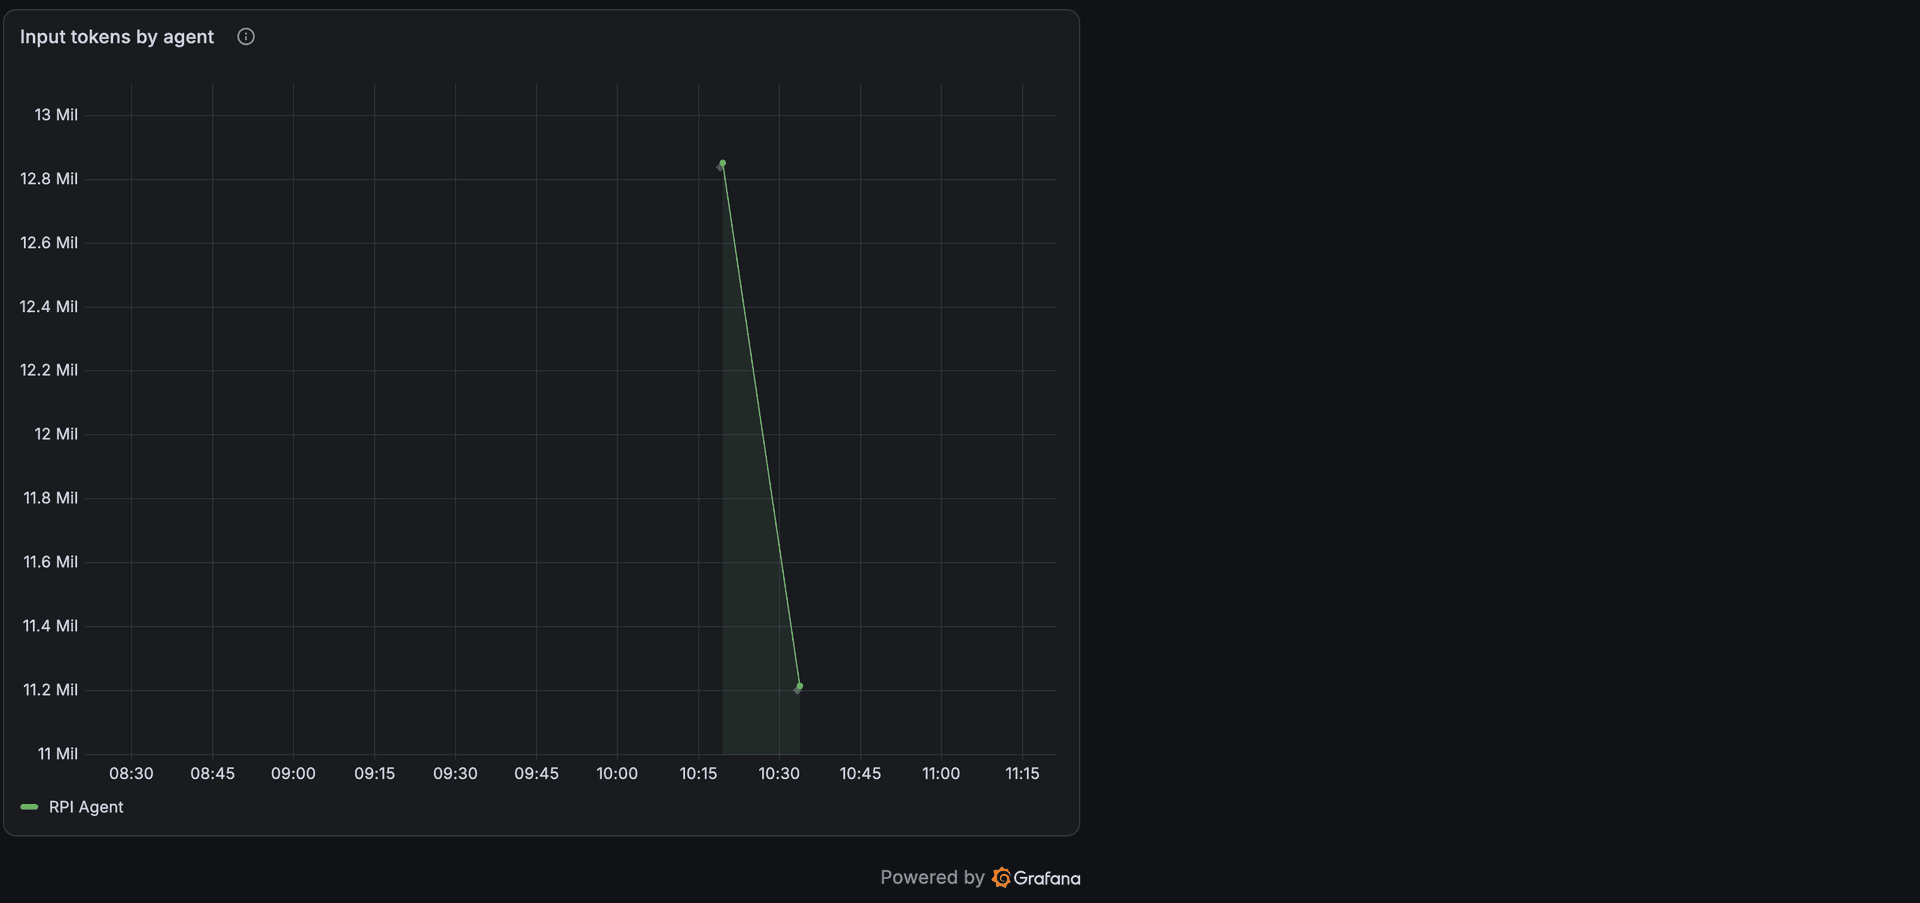
值得一提的是 experimental 目录里的 copilot-otel-metrics 技能:它能引导用户开启 GitHub Copilot 的 OpenTelemetry 导出,生成本地 Grafana 栈(Docker Compose)或 Azure 组织级采集方案,用来量化 AI 辅助编码的实际效果。这是把"AI 提效"从口号变成可观测指标的做法。
部署这个项目的方式和其他 AI 项目截然不同——它不需要部署。
| 路径 | 操作 | 适用场景 |
|---|---|---|
| Copilot CLI 插件 | copilot plugin marketplace add microsoft/hve-core → copilot plugin install hve-core@hve-core | 终端工作流、CI 场景 |
| VS Code 扩展 | 从 Marketplace 安装 ise-hve-essentials.hve-core | 团队日常开发,但指令不一定注入 Copilot 会话,且无 canvas |
| 仓库直接采用 | 把 .github/agents、instructions、skills 复制进自己的仓库 | 想自己掌控并演进的团队 |
硬性前置条件很少:一个 GitHub Copilot 订阅(或 Copilot CLI)、Git、VS Code 或终端;仅当你要跑仓库自带校验脚本时才需要 PowerShell 7 和 Node.js 20+。仓库提供了 .devcontainer/Dockerfile(基于 mcr.microsoft.com/devcontainers/base 并按 manifest digest 固定),可用于容器化开发环境。
上手后建议按官方路线走:先跟 Agent 聊一次(1 分钟)→ 在自己代码库跑 /rpi-research(5 分钟)→ 完整跑一轮 RPI(15 分钟)→ 再逐步过渡到独立使用。
需要明确指出的问题:
CAUTION 警示框,承认这是"高度主观、快速演进"的框架,工作流、接口与推荐实践可能发生不向后兼容的变更。项目建议把它当作"模式与学习素材",而非稳定的平台或生产依赖。validate:local 一键聚合命令来缓解,但仍需理解取舍。HVE Core 标志着一个明确的趋势转折:AI 编程的竞争焦点正从"模型能力"转向"上下文与流程治理"。
当基础模型能力趋于同质,差异化就转移到组织层面:谁能把安全要求、合规流程、架构评审惯例沉淀成 AI 可执行的载体,谁就能真正获得"AI 提效",而不只是"AI 写代码更快"。
它还代表一种务实立场——不试图做"无人值守的自动开发平台",而是承认人类判断不可替代,于是把 AI 的角色精准定位在"携带规则的执行者"。这种克制,反而让框架更容易在受监管的企业环境中落地。
对团队而言,它提供的最有价值的不是某个 Agent,而是一种组织知识的资产化范式:把散落的规范变成可版本化、可评测、可评审的 AI 制品。
microsoft/hve-core 不是又一个 Agent 框架,它更像微软给企业准备的一份"AI 时代的工程规章模板"。它的价值在于把上下文管理、治理、可复用组织知识三件事做成了可安装、可评测、可演进的工程产物;它的风险在于强观点、快速演进与深度生态绑定。
如果你正在推进团队 AI 编码落地,这套 RPI 方法论与资产化思路值得作为参考样板;如果你的团队已有成熟规范体系,则更适合借鉴其表达方式与评测体系(Vally evals、baseline-equivalence),而非照搬其内容。
