
SkillOpt
microsoft/SkillOpt加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你花了一整个下午,手写了一份 2000 字的 prompt 规范,告诉 AI Agent 怎么处理订单投诉。你觉得这次应该稳了。结果第二天测试,同一类问题它答得挺好,另一类却完全跑偏——prompt 里的"当用户说 XX 时应该 YY"根本不管用。你开始怀疑:是不是 prompt 太复杂了?是不是例子不够?是不是模型太笨?
都不是。问题的根源在于:prompt 本质上是静态的,而我们面对的任务是动态的。一个手写的 prompt 只能覆盖已知场景,遇上没见过的输入就失效。你每次改 prompt,本质上是在"盲调",靠猜测而不是数据。
微软研究院 2026 年 5 月发布的 SkillOpt 就是来解决这个问题的。它的核心想法很反直觉:与其训练模型,不如训练 prompt 本身。
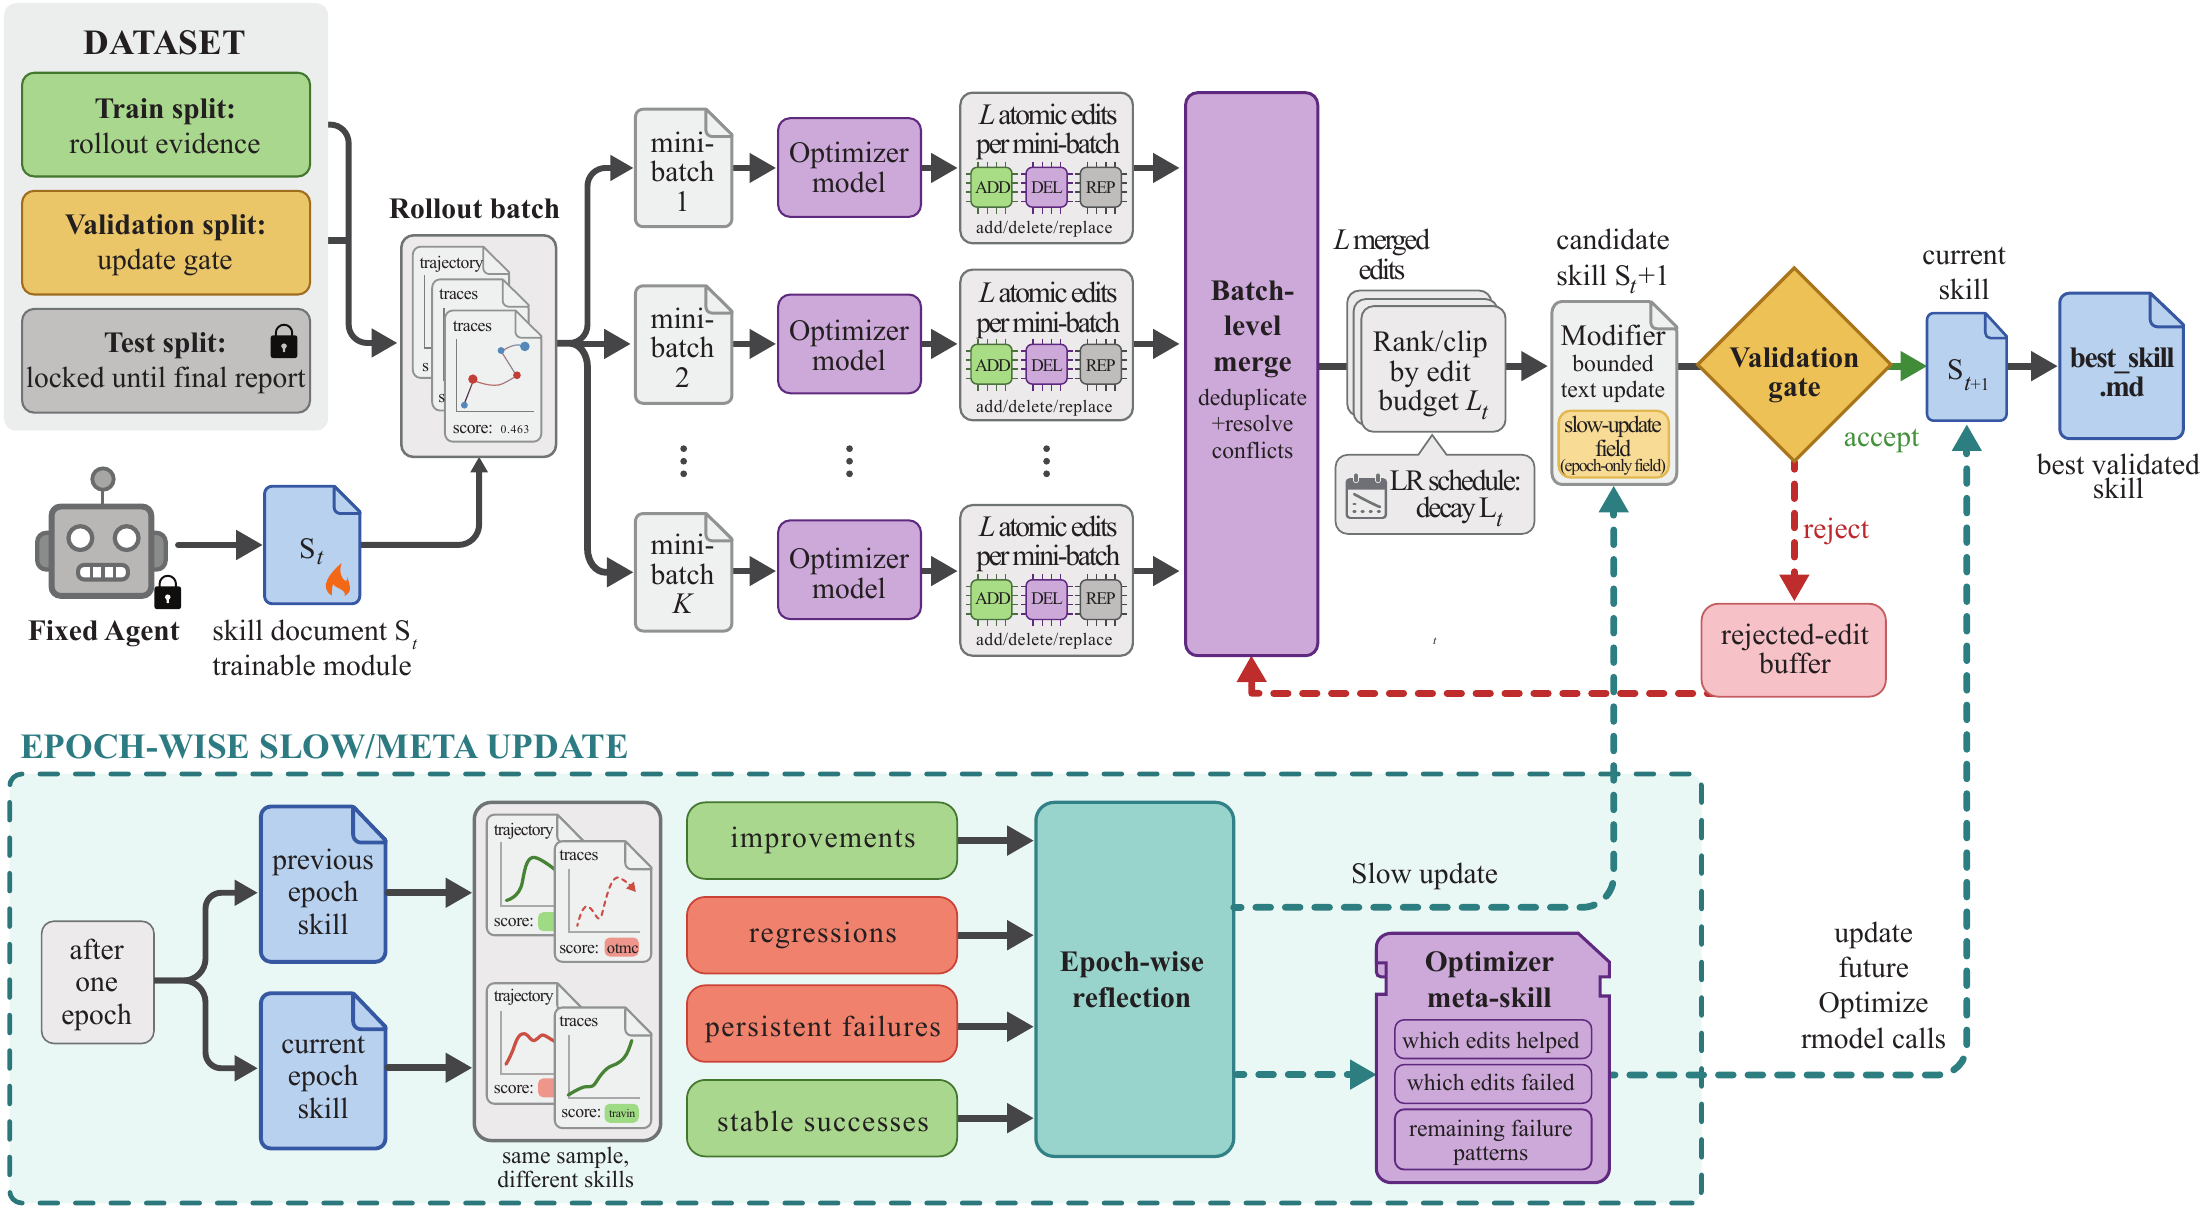
SkillOpt 训练循环:rollout → reflect → edit → validate → 导出 best_skill.md
当前 AI Agent 的技能来源主要有三种:
第一种:专家手写。优点是可解释,缺点是成本高、扩展性差——每个任务的 prompt 都要人工维护,随着任务变多,维护成本指数增长。
第二种:让大模型一次生成。快,但质量不稳定。生成出来的 prompt 可能在测试集上表现不错,换个场景就崩了,因为缺乏系统性的优化过程。
第三种:Agent 自我修正。让 Agent 执行后自己反思改进,看起来很智能,但实际上是"自己改自己"——没有独立的评估标准,修正方向可能跑偏,收敛性差。
这三种方法有一个共同问题:它们不像一个深度学习优化器,更像是手动调参。而 SkillOpt 的核心创新,就是把神经网络的训练流程搬到了文本空间。
SkillOpt 的思路可以概括为三个关键词:冻结模型、训练技能、验证门控。
冻结模型:目标模型(比如 GPT-5.5)的参数完全不变。模型只是在执行任务,产生"轨迹数据"(trajectory)——也就是模型一步步思考和行动的记录。
训练技能:训练的对象是 best_skill.md——一个普通的 Markdown 文件,里面写着技能的操作规范、工具使用指南和少量示例。把这个文件当作模型的"外部权重",通过修改它的内容来提升模型表现。
验证门控(Validation Gate):这是最关键的设计。每一次对 skill.md 的修改(增、删、改),都不是直接采纳的——必须先在独立的验证集上测试。只有当新版本的得分严格高于当前版本,才会被接受。这就像神经网络里反向传播的梯度裁剪,只不过作用在文本上。
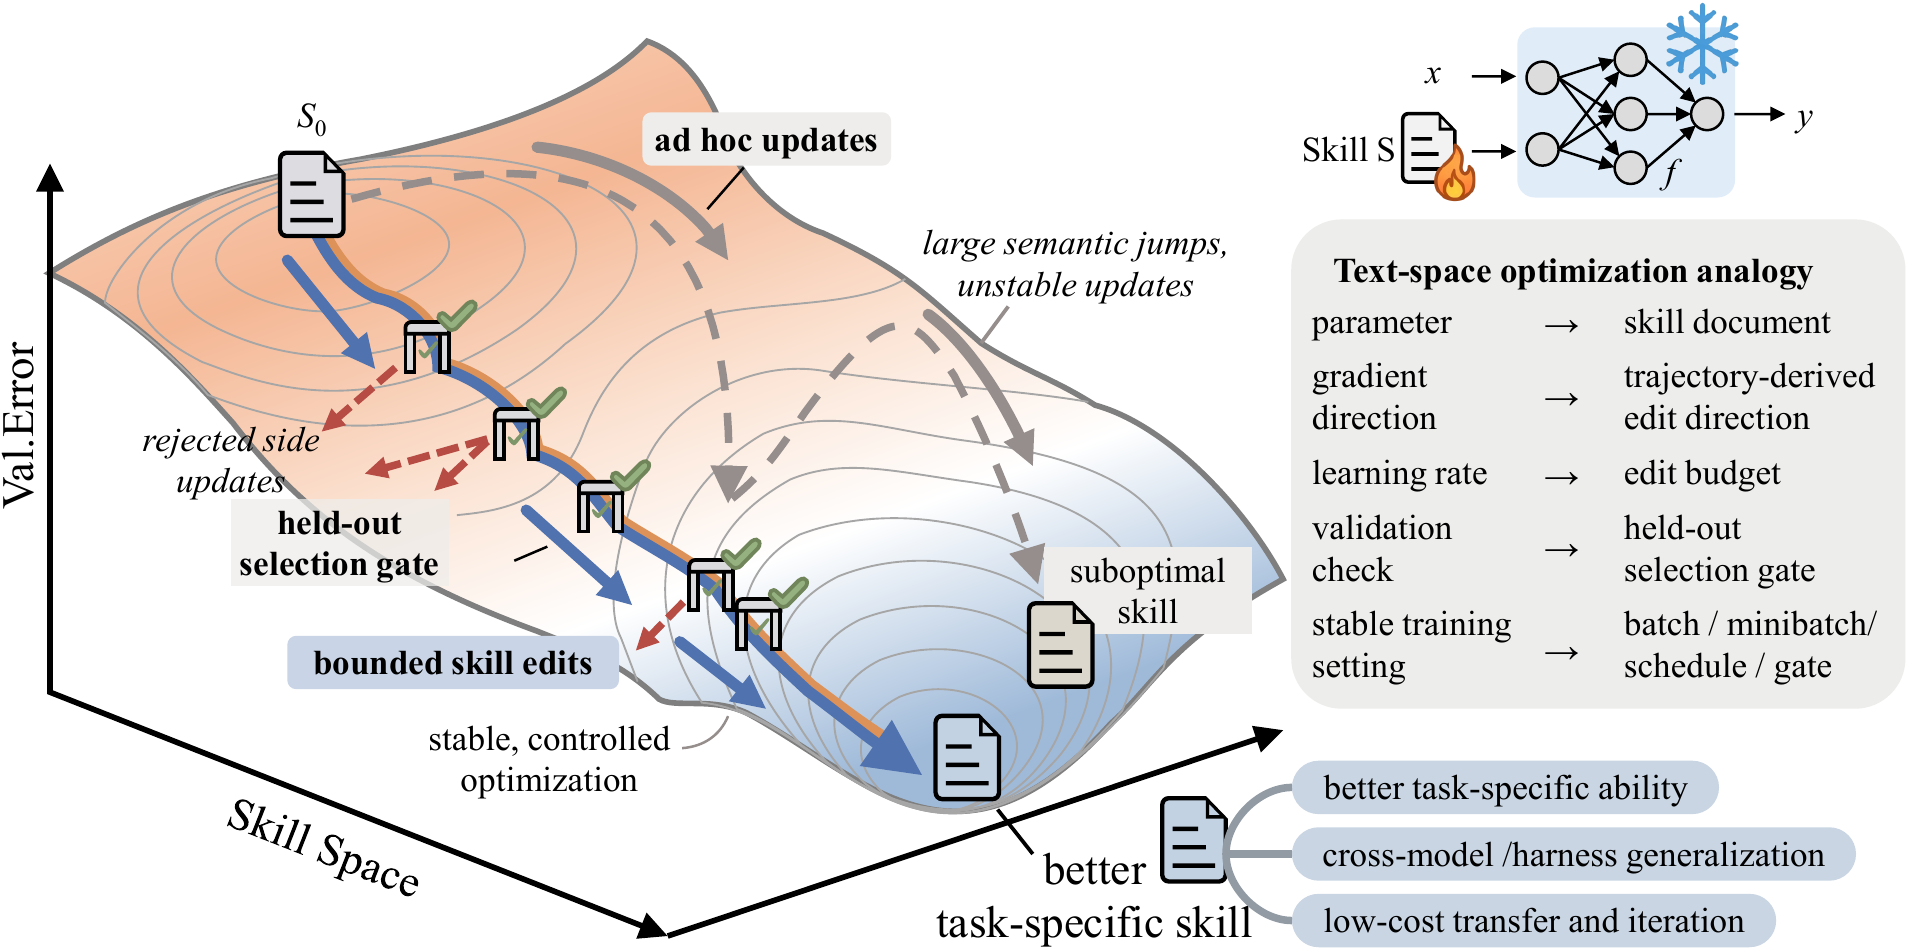
SkillOpt 将自然语言技能视为可训练的外部状态,用验证门控确保每次更新都是正向的
SkillOpt 的完整训练流程分为四个阶段:
1. Rollout(展开):用当前的 skill.md 让目标模型执行一批训练任务,收集执行轨迹。比如你要训练"客服投诉处理"技能,就让模型处理 32 个投诉案例,记录每一步的思考和行动。
2. Reflect(反思):一个独立的"优化器模型"(默认是 GPT-5.5)读取所有轨迹。成功的轨迹中提取值得保留的模式,失败的轨迹中找出需要修正的问题。这是整个流程里唯一真正调用大模型的地方。
3. Edit(编辑):优化器模型基于反思结果,提出对 skill.md 的修改建议。每次修改都是小步的——最多改几句话中的一个词、一个段落,而不是重写整个文件。SkillOpt 把这个"步长"类比为神经网络的"学习率",叫做"文本学习率"。
4. Validate(验证):这是最核心的环节。新版本的 skill.md 必须在验证集上通过严格测试——只有得分比当前版本严格更高,才会被接受。如果验证失败,这个修改进入"拒绝缓冲区",作为后续优化的负样本。
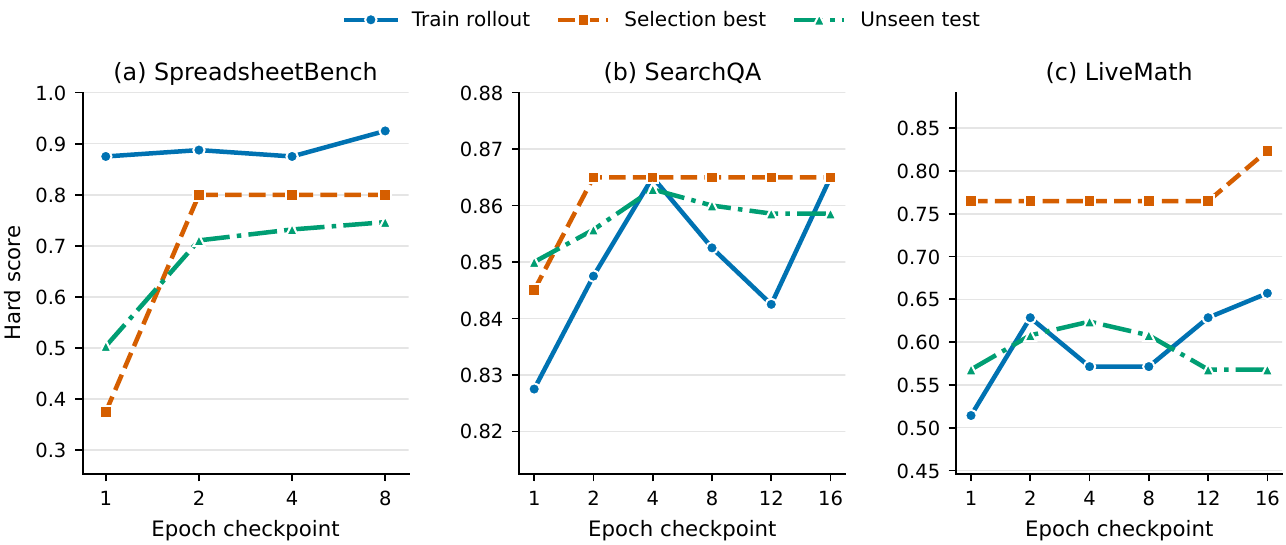
训练过程中的 epoch 曲线:验证集得分随训练步数的提升,展示了 SkillOpt 在多个基准上的稳定收敛性
SkillOpt 的代码库分为几个核心模块:
skillopt/optimizer/:优化器核心,实现 rollout-reflect-edit-validate 的完整循环skillopt/engine/:执行引擎,管理任务调度和轨迹收集skillopt/envs/:环境适配器,目前支持 SearchQA、SpreadsheetBench、OfficeQA、DocVQA、LiveMathematicianBench、ALFWorld 等 6 个基准skillopt/model/:多后端支持,包括 OpenAI Chat、Azure OpenAI、Claude、MiniMax、本地 Qwen(vLLM)等skillopt_sleep/:SkillOpt-Sleep 插件,夜间离线自我进化模式,支持 Claude Code / Codex / Copilot 等本地编码 AgentSkillOpt 在 6 个基准、7 个目标模型、3 种执行模式(直接对话、Codex CLI、Claude Code CLI)下进行了全面评估。在 52 个评估单元中,SkillOpt 全部达到最佳或并列最佳。
最令人印象深刻的是 GPT-5.5 上的数字:在直接对话模式下,平均准确率从不使用技能的基线提升了 +23.5 分,在 Codex Agent 循环中提升 +24.8 分,在 Claude Code 中提升 +19.1 分。
更值得关注的是跨模型迁移能力:一个为 GPT-5.4 优化的技能,直接迁移到 GPT-5.4-mini 和 GPT-5.4-nano 上依然有正向提升,说明 SkillOpt 学到的是可复用的工作流程,而不是特定模型的"小聪明"。
SkillOpt 并非万能。它的局限主要在以下几个方面:
1. 计算成本:每次优化器调用都需要额外的 LLM API 费用。在论文的实验规模下,训练一个技能的 GPU 成本不高,但 API 调用成本不容忽视。
2. 数据格式要求:SkillOpt 需要结构化的训练数据和验证数据。对于没有现成数据集的自定义任务,前期的数据准备工作量不小。
3. 超参敏感:文本学习率、epoch 数、batch size 等超参对结果影响较大。论文里有详细的消融实验,但对于新任务,用户需要一定的调参经验。
4. 评估基准的局限:现有基准集中在结构化问答、表格操作等任务,对于开放式创意任务(如写文案、头脑风暴)SkillOpt 的适用性尚未被充分验证。
SkillOpt 最有价值的地方,是提出了一种系统性的技能优化方法论——用验证驱动的闭环替代随机的手动调优。这套方法论不依赖任何特定模型,可以迁移到任何支持 API 调用的 LLM 系统。
从更宏观的视角看,SkillOpt 代表了一个趋势:从"训练模型"到"训练技能"的认知转变。当模型的推理能力足够强,瓶颈就从"模型够不够聪明"转移到了"技能定义够不够好"。SkillOpt 正是瞄准了这个新的瓶颈。
2026 年 7 月 2 日发布的 v0.2.0 版本还加入了 SkillOpt-Sleep——一个夜间离线自我进化插件,让编码 Agent(Claude Code、Codex、Copilot)在用户休息时自动回顾会话、提炼经验、改进技能,无需人工干预。这是将 SkillOpt 从实验室推向实际工作流的重要一步。
