
PII-Detection
mddunlap924/PII-Detection加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
mddunlap924/PII-Detection — 用合成数据解锁高精度个人隐私信息检测
2024年,全球最大的数据科学竞赛平台 Kaggle 上线了一道让无数 NLP 工程师头疼的赛题:The Learning Agency Lab - PII Data Detection。任务是从教育文本中识别、分类并遮蔽个人可识别信息(PII)——姓名、邮箱、电话、社保号、家庭住址……这些散落在海量文档里的敏感碎片,稍有遗漌便是合规风险。
竞赛结束后,开发者 Myles Dunlap(Kaggle ID: dunlap0924)将竞赛期间打磨出的完整技术方案开源,发布为 PII-Detection 仓库。他用这套方案在竞赛中拿到了 Top 1% 的成绩。而更值得关注的是:这不是一个简单的模型调参项目,而是一套从零构建合成训练数据、到模型微调、再到生产级推理的完整 pipeline。
个人隐私信息检测(Personal Identifiable Information Detection,简称 PII 检测)是命名实体识别(NER)的一个垂直子领域。但它比通用 NER 要役么多:
第一,类别极度不均衡。 在一段正常文本里,"O"(非实体)标签的出现频率可能是某个具体 PII 类型的几千倍。模型会"偷懒"——永远预测"O"也能获得很高的准确率,但实际一个无检测能力。
第二,高质量标注数据极难获取。 PII 涉及真实个人信息,数据隐私法规限制了公开数据集的流通;人工标注成本高,且标注质量参差不齐。
第三,跨领域泛化困难。 医疗记录中的 PII 格式与教育文本中的完全不同,一个通用模型很难在所有场景都保持高召回率。
PII-Detection 仓库的核心贡献,正是围绕这三个痛点展开的。
传统方法要么直接用真实 PII 数据(法律风险),要么让 LLM 直接生成含 PII 的文本(LLM容易"自作聪明"地把电话改一位数字)。该项目创新性地设计了一个三步解耦合成流程,将 PII 数据与领域文本分开生成,再动态拼接:
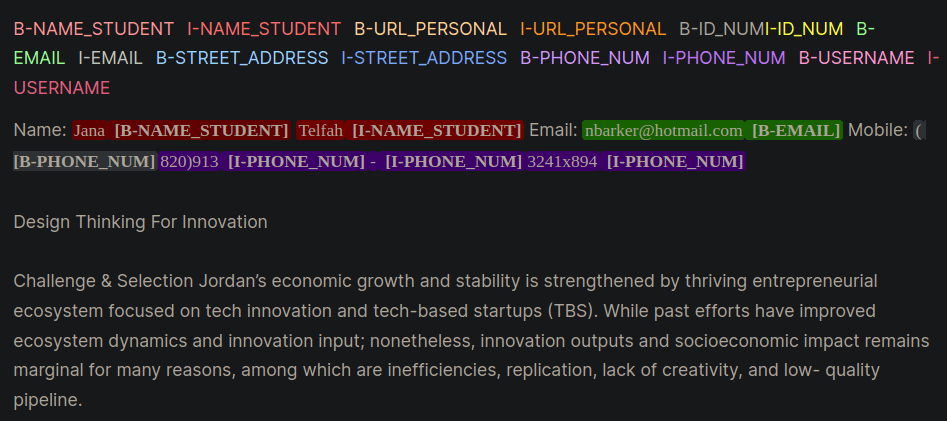
图注:IOB(B-Inside, O, B-Begin)格式是命名实体识别中的标准标注方式,"B-"表示实体的开始 token,"I-"表示延续。上图展示了姓名、邮箱、电话、用户名等不同类型 PII 实体在文本中的标注方式。
第一步:Faker 生成 PII 骨架。 借助 Python 库 Faker,批量生成虚假但格式真实的姓名、邮箱、电话、地址等实体数据。这一步不依赖任何真实个人信息,完全合规。
第二步:Llama3 生成占位符文本。 开发者发现:直接让 Llama3 写入 PII 数据时,模型经常"手滑"——把电话号码写错一位数字,或者偷偷加上没被要求生成的邮箱。最关键的是,某些 LLM 会因为安全策略直接拒绝生成含 PII 的文本。
(他们的解决方案是:)先让 Llama3 生成“占位符”**(placeholder)**而非真实 PII。例如让模型输出“我的名字是{FULL_NAME},联系电话{PHONE_NUM}”,然后在第三步用 Faker 生成的假数据做替换。
第三步:占位符替换,生成最终训练语料。 用正则匹配占位符,将其替换为 Faker 生成的假数据,获得一份完整的、带 IOB 标注的合成训练集。
这三步解耦的核心价值在于:你可以独立替换 PII 数据或领域文本,快速构建不同行业、不同语种的合成数据集。
检测模型选用的是微软的 DeBERTa-v3-large,这是一个 Encoder 架构的预训练语言模型,在 NER、问答、分类等序列标注任务上长期霸榜。
但 DeBERTa 并非开箱即用。项目作者针对 PII 检测做了三项关键优化:
针对严重的类别不均衡问题,项目实现了自定义 Trainer,在标准交叉熵损失基础上引入 Focal Loss(alpha=5, gamma=2)和类别权重机制:让模型在少数类(各类 PII 实体)上的预测错误受到更重的惩罚。
核心代码如下,继承 HuggingFace Trainer,覆盖 compute_loss 方法,根据配置动态切换 Focal Loss 和带权重的交叉熵:
class CustomTrainer(Trainer):
    def compute_loss(self, model, inputs, return_outputs=False):
        labels = inputs.pop("labels")
        outputs = model(**inputs)
        logits = outputs.logits
        if self.focal_loss_info.apply:
            loss_fct = FocalLoss(alpha=5, gamma=2, reduction='mean')
            loss = loss_fct(logits.view(-1, self.model.config.num_labels), labels.view(-1))
        else:
            loss_fct = CrossEntropyLoss(weight=self.class_weights)
            loss = loss_fct(logits.view(-1, self.model.config.num_labels), labels.view(-1))
        return (loss, outputs) if return_outputs else loss
DeBERTa 在通用语料上预训练,但在教育/医疗等垂直领域可能"词不达意"。项目在微调前增加了 MLM 领域适应阶段:冻结 NER 头,继续在目标领域无标注语料上做语言建模,让模型先“学会说这个领域的语言”。这种从通用 checkpoint 开始、用领域数据继续预训练再微调的方式,通常比直接微调效果更好。
项目提供了三种训练模式,覆盖从低显存到高显存的全部场景:
| 模式 | 适用场景 | 显存需求 | 技术手段 |
|---|---|---|---|
| 单卡 + Chunk + Stride | 常规 token 长度(12~1024) | 中等 | 文本分块 + 重叠滑动窗口(stride 16/32/128) |
| 单卡 + 长上下文 | |||
| token 长度 > 5K | 较高 | 梯度检查点(Gradient Checkpointing)防显存溢出 | |
| 双卡并行 | 大 batch + 长上下文 | 高 | 模型分片(Model Sharding)跨 GPU |
仓库中对应三个脚本:train_chunks_cib.py、train_single_large.py、train_dual_gpu.py,配合 Bash 脚本一键启动,无需手动改代码。
项目全面集成 W&B 实验追踪,记录每次训练的 loss 曲线、验证集 F1 分数、学习率调度等信息。Kaggle 竞赛选手 Darek Kteczek 还专门录制了一期 YouTube 教程,演示如何在 PII 检测场景下接入 W&B,将 wandb logging 嵌入训练循环。
此外,仓库 docs/ 目录包含多个 Jupyter Notebook(竞赛数据分析、实验结果可视化等),是复现和迭代的重要参考。
謙恭地说,PII-Detection 不是一个开箱即用的工具,它更像是一个经过竞赛验证的参考实现。核心特点:
适合人群: 有 NLP 基础的算法工程师、数据科学家,需要在特定领域构建 PII 检测系统。
不适合: 非技术用户,或需要快速原型验证的产品经理。
| 项目 | 技术路线 | 合成数据 | 竞赛成绩 | 部署难度 |
|---|---|---|---|---|
| PII-Detection | DeBERTa-v3 + Focal Loss | 三步合成流程 | Top 1% | 高 |
| Microsoft Presidio | 规则 + spaCy | 无 | 无 | 低(有 Docker) |
| spaCy NER | 通用 NER | 无 | 无 | 中 |
| Stanza | 多语言 NER pipeline | 无 | 无 | 低 |
相比微软官方的 Presidio,PII-Detection 的优势在于深度定制能力和竞赛级别的精度;劣势在于缺乏开箱即用的便利性。
主力技术栈:
microsoft/deberta-v3-large — 预训练模型transformers (HuggingFace) — 模型加载与微调PyTorch — 深度学习框架Faker — 合成 PII 数据生成Weights & Biases — 实验追踪Meta-Llama-3-8B-Instruct — 合成文本生成(API 调用)项目目录结构:
mddunlap924/PII-Detection/
├── src/              # 数据加载、预处理、指标计算
├── training/         # 三种 GPU 训练模式
│   ├── mlm-training.py          # 领域适应 MLM
│   ├── train_chunks_cib.py     # 单卡 Chunk 模式
│   ├── train_single_large.py   # 单卡长上下文模式
│   └── train_dual_gpu.py       # 双卡并行模式
├── gen-data/         # 合成数据生成 pipeline
│   ├── pii-syn-data.py                  # Faker 生成 PII 骨架
│   ├── ai-gen-llama3.py                 # Llama3 生成占位符文本
│   ├── finalize-placeholder-data-llama3.py  # 替换拼接
│   └── prompt-templates/                 # 提示词模板
├── cfgs/             # YAML 训练配置
├── scripts/           # 一键训练 Bash 脚本
└── docs/             # 竞赛分析 Notebook + PDF
PII-Detection 的最大启发,不在于 DeBERTa 调参本身,而在于它验证了一条合成数据驱动垂直领域 AI 的可行路径。
当真实标注数据难以获取时,用 LLM + 规则引擎构建大规模合成语料,再用合成语料微调专用模型 —— 这条路径在 Kaggle 竞赛中已经被证明能带来 Top 1% 的效果。它对于医疗、法律、金融等高敏感度领域的 NLP 应用,具有重要的参考价值。
需注意: 该项目 License 为 None(非标准开源授权),商业使用前请确认授权条款。
