
secure-xgboost
mc2-project/secure-xgboost加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:全国有数十家三甲医院,每家医院都积累了数以万计的癌症患者影像数据。但由于《个人信息保护法》和《数据安全法》的严格限制,没有任何一家医院敢把这些数据上传到云端共享给其他机构——因为一旦泄露,医院将面临巨额罚款甚至刑事责任。结果呢?每家医院只能基于自己的小样本训练 AI 模型,准确率迟迟上不去。这就是医疗 AI 领域最典型的"数据孤岛"问题。
Secure XGBoost 正是为解决这类问题而生的。它是 UC Berkeley RISE Lab 推出的 MC²(Multiparty Collaboration and Coopetition)研究计划的一部分,专门用于在数据不出域的前提下,实现多方联合训练和推理。简单来说:数据加密存储在本地,模型训练过程在"可信飞地"(Secure Enclave)内完成,即使服务器本身也无法窥探任何一方的原始数据。
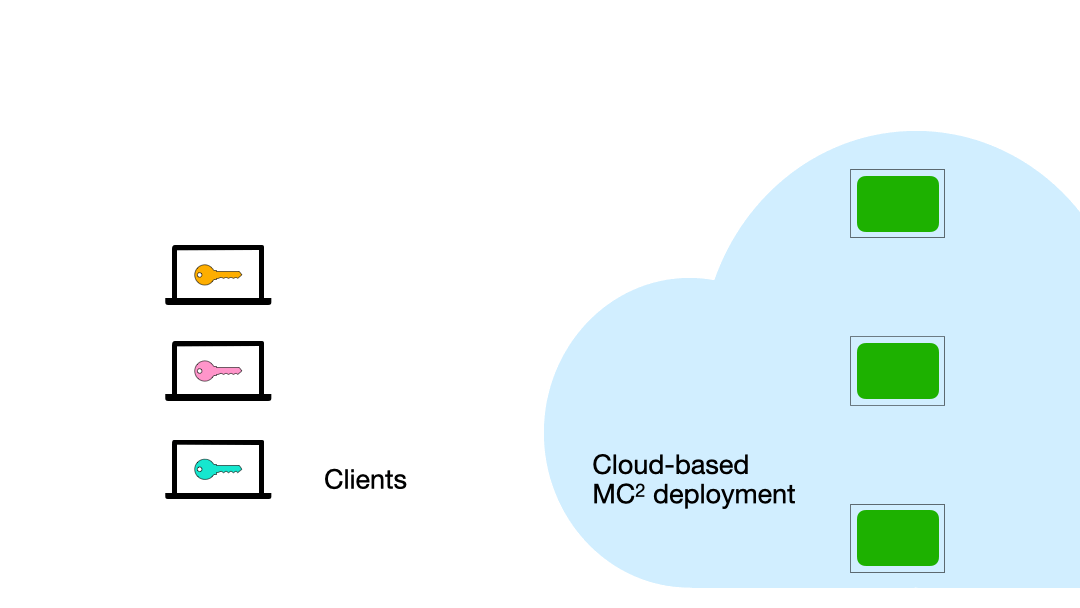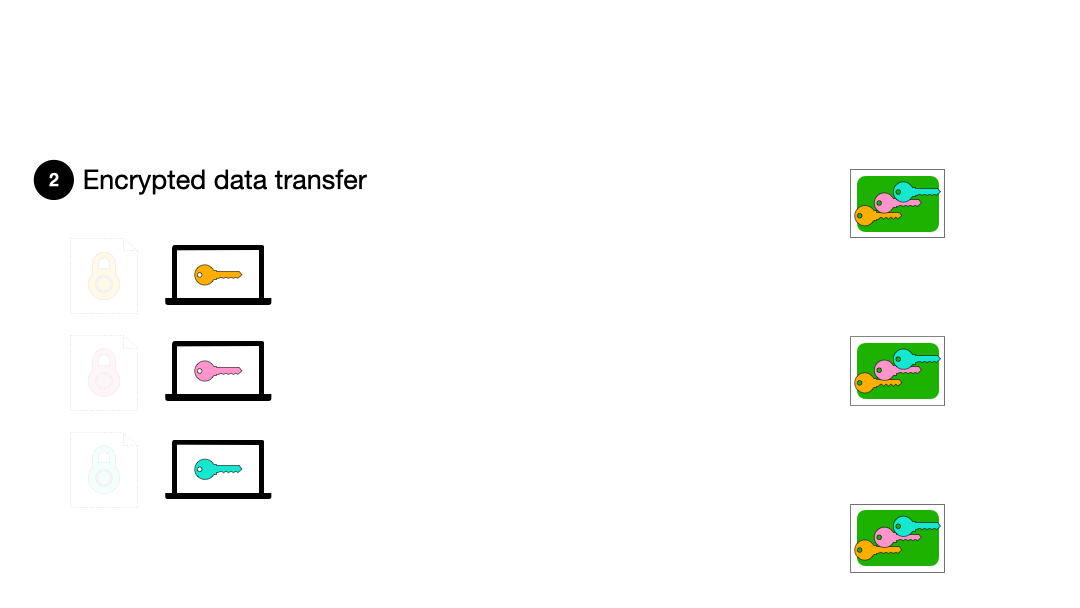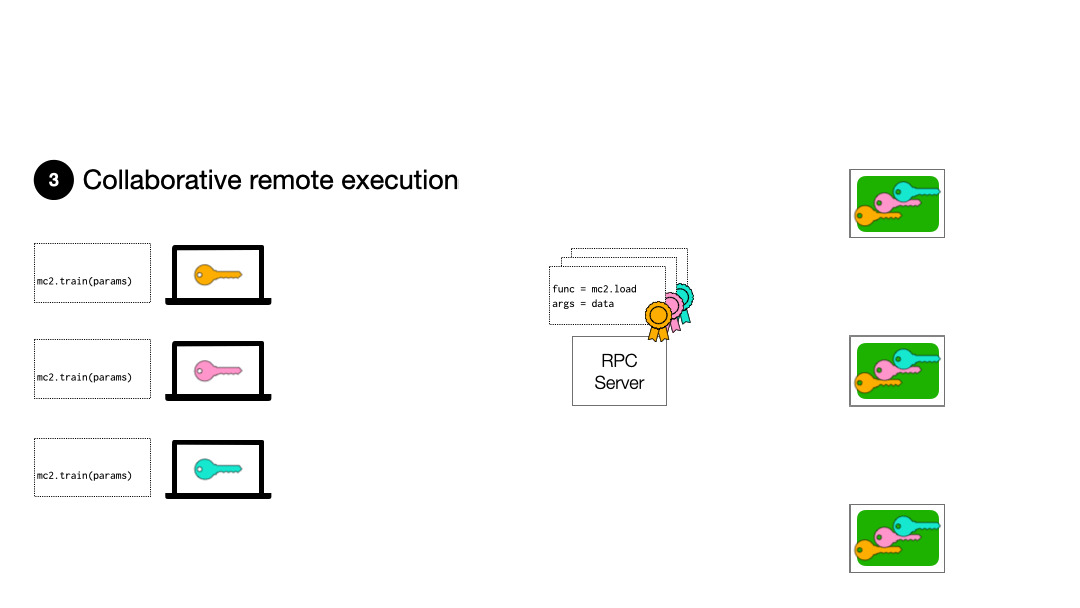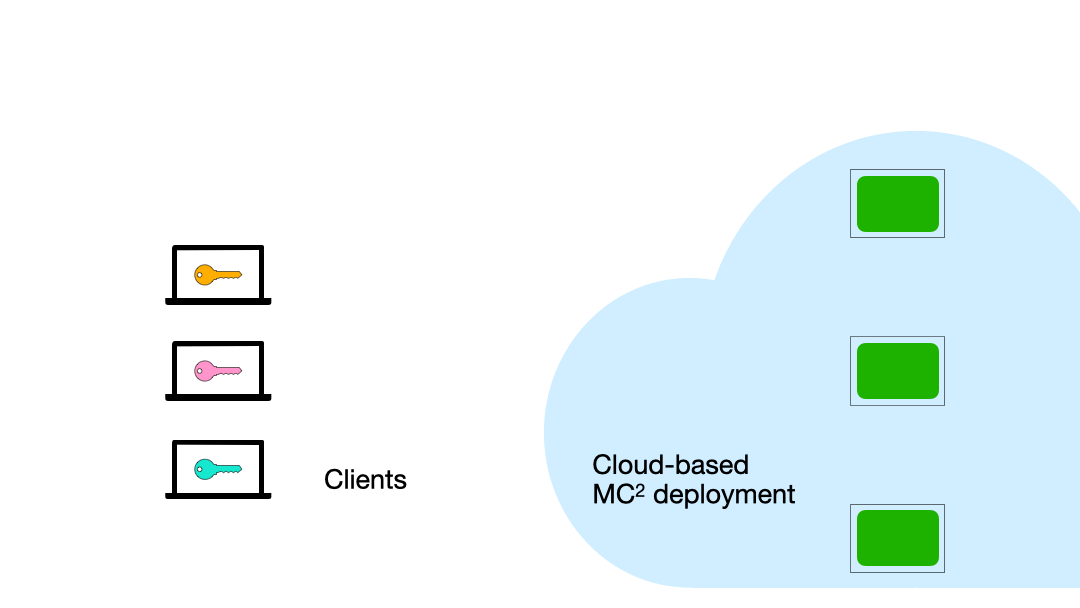
多数据持有方通过远程认证与服务端 enclave 交互,完成加密数据上的 XGBoost 训练与推理。
Secure XGBoost 的底层技术栈包含两大核心模块:
可信执行环境(Trusted Execution Environment, TEE)
项目基于 Intel SGX(Software Guard Extensions)实现。SGX 是现代 Intel 处理器提供的一组 CPU 指令集,可以在内存中划分出一个受硬件保护的"飞地"(Enclave)区域。即使攻击者拥有管理员权限、甚至攻破了整个操作系统,也无法读取飞地内的数据。Secure XGBoost 使用 Open Enclave SDK 作为跨平台抽象层,将 XGBoost 的核心训练逻辑封装在 enclave 内部。训练数据在传输前由客户端用对称密钥加密,只有飞地内部才能解密——服务端永远看不到明文。
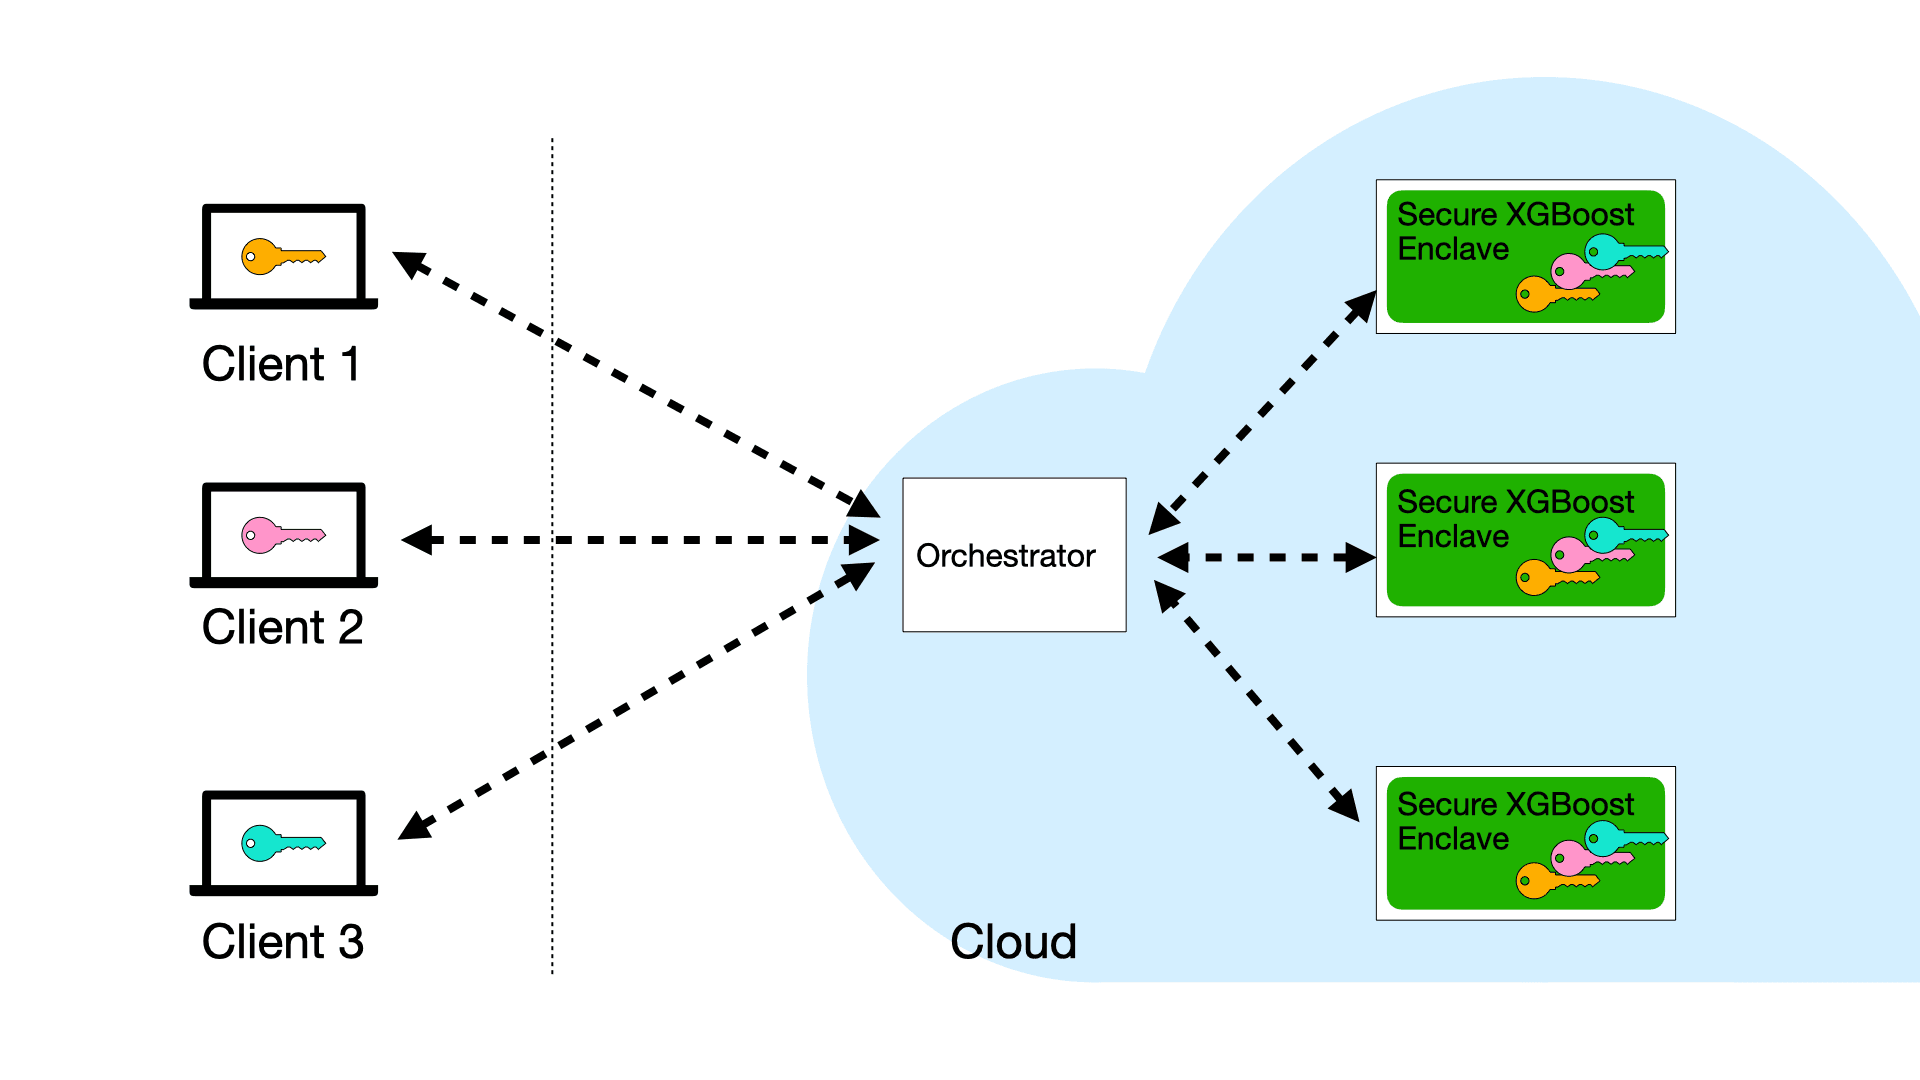
Secure XGBoost 系统架构:enclave 侧运行核心 ML 逻辑,host 侧处理 gRPC 通信和密钥管理。
数据遗忘(Data-Oblivious)算法
这是该项目最有趣的技术细节之一。除了加密保护之外,Secure XGBoost 还实现了"数据遗忘"训练——即通过精心设计的内存访问模式,使得即便攻击者能观察到程序的运行时行为(分支预测、缓存状态等),也无法推断出训练数据的内容。例如,XGBoost 的树构建过程中,对特征的比较操作不再依赖真实数值大小,而是通过等价的恒定时间算法完成。该项目支持可选的 OBLIVIOUS 编译选项,开启后即进入数据遗忘模式。
如果用生活场景来类比:每个医院院长手里有一把私人钥匙,数据以加密形式存放在医院的"保险箱"里。AI 训练的任务被外包给一个"智能工厂"(远程服务器),工厂有自己的工人和机器(XGBoost 模型)。院长把加密的保险箱寄到工厂,工厂的工人在完全密封、无监控的车间(SGX Enclave)里打开保险箱进行加工。整个过程中,工人既看不到保险箱里原本装的是什么,工厂老板也无法从工人的操作记录中推断出任何原始数据信息。工厂只能看到最终的成品(模型权重),无法拿走原材料。
Secure XGBoost 提供了一套完整的 Python API,封装在 securexgboost 包中,使用体验与原生 XGBoost 高度一致:
import securexgboost as xgb

# 1. 生成客户端密钥并加密数据
xgb.generate_client_key("key.txt")
xgb.encrypt_file("data/train.csv", "data/train.enc", "key.txt")

# 2. 客户端初始化并连接远程 Enclave
xgb.init_client(user_name="hospital_A", sym_key_file="key.txt")
xgb.attest(verify=True)  # 远程认证,验证 Enclave 真实性

# 3. 在 Enclave 内创建加密数据矩阵并训练
dtrain = xgb.DMatrix("data/train.enc")
params = {"objective": "binary:logistic", "max_depth": 6}
bst = xgb.train(params, dtrain, num_boost_round=100)

# 4. 推理阶段同样在 Enclave 内完成
dtest = xgb.DMatrix("data/test.enc")
predictions = bst.predict(dtest)
项目还支持多数据方协作训练(Multi-Party Training),通过 Rabit(Reliable AllReduce Interface Toolkit)实现参数服务器架构下的梯度同步。多个数据方可以各自持有部分数据,共同参与一个模型的训练,而彼此之间不暴露任何明文数据。
Secure XGBoost 显然不是一个开箱即用的工具。它的安装过程相当繁琐:必须使用 Ubuntu 18.04,需要手动安装 Open Enclave SDK 0.17.1(这本身就包含 Intel SGX 驱动、DCAP 库等一堆依赖),然后从源码编译 CMake 项目。没有 Dockerfile 和 docker-compose 支持,唯一可用的 Docker 镜像 mc2project/ubuntu-oe0.9:v1 仅支持模拟模式(SIMULATE=ON),不支持真实的远程认证。
对于普通 AI 开发者来说,这个门槛几乎是不可逾越的——你需要熟悉 Linux 系统编程、理解 SGX 硬件机制、能处理编译错误,还要有支持 SGX 的硬件服务器。但对于安全研究团队、隐私计算平台开发者、以及有合规需求的企业而言,这是一个值得深入研究的技术原型。
1. 性能开销巨大。 在 SGX Enclave 内运行 XGBoost 带来了显著的性能损耗。Enclave 的内存受到 EPC(Enclave Page Cache)大小限制,跨 Enclave 边界的函数调用(ECALL/OCALL)也有额外开销。数据遗忘模式进一步放大了这一开销,因为它用恒定时间的等效算法替换了原本高效的分支操作。
2. 依赖特定硬件。 SGX Enclave 仅在特定型号的 Intel CPU 上可用(Skylake 及更新架构),且在云端支持有限。虽然 AWS EC2 提供了支持 SGX 的实例类型(如 c5.large-sg14),但选择面很窄且成本较高。
3. 研究原型,非生产级代码。 项目 README 明确声明:"Secure XGBoost 是一个研究原型,尚未经过独立代码审查。" 这意味着它缺乏生产环境所需的安全审计、压力测试和稳定性保障。
Secure XGBoost 代表了隐私计算领域的一条重要技术路线——基于 TEE 的机密计算(Confidential Computing)。与同态加密(HE)和联邦学习(FL)相比,TEE 路线在计算性能上有明显优势(因为大部分计算在明文下进行,仅关键数据在 Enclave 内处理),但安全边界依赖于硬件信任假设。
从更大的视角看,随着全球数据隐私法规(GDPR、中国 PIPL、欧盟 AI Act)日趋严格,能在不泄露原始数据的前提下完成机器学习训练和推理的技术方案,将变得越来越重要。Secure XGBoost 作为这一方向的开创性开源实践,即使暂时无法直接用于生产,也为零信任机器学习系统的设计提供了宝贵的参考。
MC² 计划所设想的"合作竞争"(Coopetition)场景:多家机构在保护各自数据隐私的同时,共同构建更强大的 AI 模型。
