
RAG-Boilerplate
mburaksayici/RAG-Boilerplate加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下这个场景:你是一个法律顾问,需要 AI 系统帮你快速查阅海量法规条文。你把文档全部喂给 GPT,但模型经常"一本正经地胡说八道"——这不是它不想好好回答,而是纯粹的大语言模型根本没有"记住"那些法律文本,它只能靠训练时的记忆来猜。
检索增强生成(Retrieval-Augmented Generation, RAG) 就是来解决这个问题的:让 AI 在回答前,先从你的专属文档库中检索出最相关的参考资料,再基于这些资料来生成答案。从法律合同审查到企业内部知识库,RAG 几乎成了 AI 应用落地的标配基础设施。
今天要介绍的项目 RAG-Boilerplate,正是这样一个功能高度模块化、设计思路清晰的 RAG 系统脚手架,由独立开发者 mburaksayici 开发维护。它不只是"跑起来 demo",而是覆盖了从文档解析、分块(Chunking)、向量化检索、重排序、查询增强到评估反馈的完整闭环。

构建一个完整的 RAG 系统并不简单。你需要解决一系列环环相扣的技术问题:PDF/Word 文档如何解析?文本如何切分才能保留语义完整性?向量数据库选哪个?BM25 稀疏检索和向量相似度检索各有什么优劣?如何让检索结果更准确地排序?用户问"关于XX公司的最新规定"时,如何理解"最新"的含义并扩展查询?
这些组件在学术界和工业界都有各自的最佳实践,但要把它们串联起来、配置调优、对接成一个可用系统,往往需要数周甚至数月的踩坑积累。RAG-Boilerplate 的出现,正是为了大幅降低这个门槛——作者把所有这些组件"焊接"好了,你只需要配置 API Key 和数据,就能快速启动一个生产级别的 RAG 系统。
作者 mburaksayici 在博客(mburaksayici.com/blog)上分享了大量 RAG 相关的深度技术文章,这个项目就是他的技术理念的代码化呈现。
项目使用 Docling 作为核心文档解析引擎,支持 PDF、DOCX、PPTX 等多种格式的自动解析和文本提取,还集成了 OCR 能力(通过 EasyOCR 和 RapidOCR)处理扫描件或图片中的文字。解析结果通过 Celery 分布式任务队列异步写入 MongoDB,为后续的分块和向量化做好准备。
进度追踪机制完善,支持实时查看文档解析、Chunk 生成和 embedding 向量化的各阶段指标。
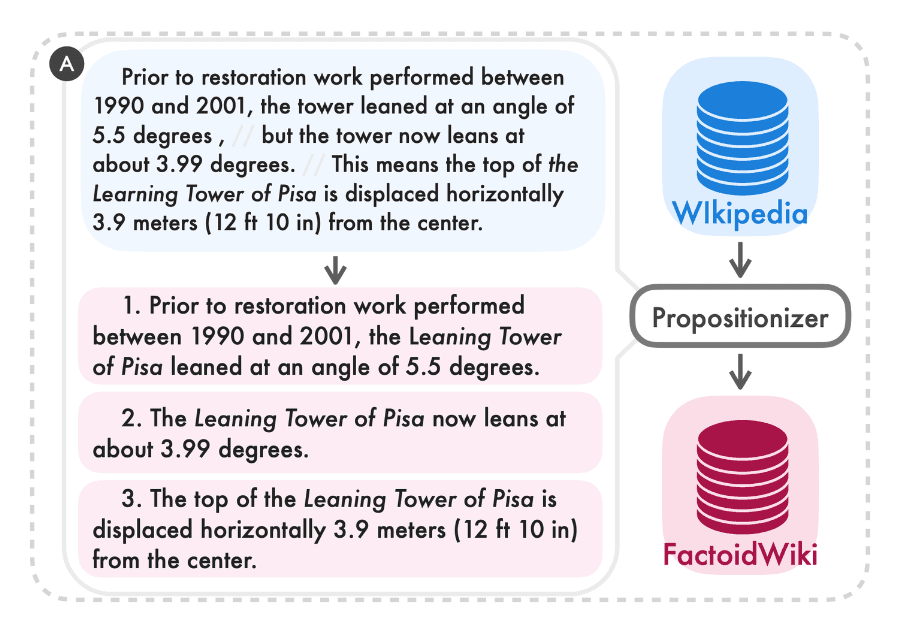
分块(Chunking)是 RAG 系统中最关键的数据处理环节,切得太大会引入过多噪声,切得太小又会丢失上下文。项目实现了三层递进的分块策略:
项目使用 Qdrant 作为向量数据库,支持 BM25 稀疏检索和稠密向量检索的混合模式(Hybrid Search)。稀疏检索擅长精确关键词匹配,稠密检索擅长语义相似度匹配,两者结合能显著提升检索的召回率和准确性。
此外,项目还集成了 ChromaDB 作为备选向量存储方案。
检索到的候选文档并不直接喂给 LLM,而是通过一个重排序(Re-ranking)Agent用 LLM 重新排序,挑选出最相关的 Top-K 结果。同时,系统还引入了 CrewAI 编排的查询增强 Agent,能够自动解析用户的查询意图,进行查询扩展(Query Expansion)和多角度改写,进一步提升检索质量。
RAG 系统的效果一直是工程难点——如何衡量"检索到了该检索的东西"?项目内置了 Hit-Rate(命中率)和 MRR(平均倒数排名)两大核心指标,并支持配置不同的检索策略(有无重排序、有无查询增强等)进行横向对比,让优化有据可依。
系统采用 FastAPI 作为后端 API 网关,Gradio 提供轻量级 Web 界面,Redis 负责会话缓存和 Celery 消息队列,MongoDB 作为冷存储保存原始文档和评估数据,Qdrant 提供向量检索服务。
整个架构设计遵循**缓存即旁路(Cache-Aside)**模式:热数据缓存于 Redis,历史会话和文档持久化于 MongoDB,向量索引由 Qdrant 加速。
项目提供了 Gradio 图形界面,可以直接在浏览器中上传文档、提问和查看会话历史。这比纯 API 调用友好得多,适合快速验证。
不过初始配置有一定复杂度:需要填写 .env 中的 OpenAI API Key(用于 embedding 和 LLM),并通过 docker-compose up 启动所有依赖服务。作者贴心地提供了 .env.example 模板,但 MongoDB 的用户名密码、Qdrant 连接参数等需要对照 README 仔细填写,对新手来说有一点点门槛。
好在 Dockerfile 和 docker-compose.yml 覆盖了所有依赖,一行命令即可拉起完整服务栈——这是项目最大的工程亮点之一。
License 缺失是首要问题:项目目前没有明确的许可证声明,这在使用和二次开发时存在法律风险。在将本项目代码用于商业产品前,务必联系作者确认授权方式。
其次,RAG 评估模块(Hit-Rate / MRR)需要人工准备 Ground-Truth 评估数据,自动化程度有限;Gradio UI 虽然可用,但功能相对基础,没有文件管理、对话历史导出等进阶功能。
此外,整个系统依赖 OpenAI API,在网络受限环境下需要额外配置代理或替换为本地 LLM(如 Ollama),这会带来一定的改造工作量。
RAG-Boilerplate 虽然 star 数不高(75),但它的代码质量和架构完整性远超平均水平。尤其是三层分块策略和CrewAI 查询增强的实现,在同类开源项目中非常少见,体现了作者对 RAG 核心痛点的深刻理解。
对于想要系统学习 RAG 工程的开发者,这个项目是一个极佳的参考范本:每个模块都可以单独拎出来研究,docker-compose 结构清晰,CrewAI 的 Agent 编排方式也值得借鉴。
如果你正在从零搭建 RAG 系统或需要快速验证某个技术方案,RAG-Boilerplate 值得 clone 下来跑一跑。
分析基于 GitHub 仓库 mburaksayici/RAG-Boilerplate(75★, Python, 无 License),由 Hermes Agent 自动生成。
