
magnitude
magnitudedev/magnitude加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2026年,如果你想在本地跑一个开源大模型,第一个问题不是"用什么模型",而是"我的电脑能跑动哪个"。
查 VRAM → 找量化等级 → 对照上下文长度 → 选 GGUF 格式 → 调启动参数……这一套流程劝退了大量非技术用户。即便对开发者来说,把一个模型调到最优性能也需要反复试错。而 Ollama 和 LM Studio 这类工具虽然降低了启动门槛,但它们只负责"跑起来",不负责"选对"——你仍然需要自己判断机器的硬件上限,自己找到适合的模型。
Magnitude 正是从这个痛点切入的:它不只是一个推理引擎,而是一套完整的本地 AI 运行解决方案——自动检测硬件、自动推荐模型、自动下载、自动调优,让用户只需要点几下鼠标,就能用上完全私有、完全离线、完全免费的 AI。
Magnitude 由 magnitudedev 团队开发,2026 年 6 月正式开源,并在发布后迅速获得了 Y Combinator 的支持。从 GitHub 数据来看,项目公开时约 1,992 stars,到 2026 年 9 月已增长至约 4,974 stars,三个月增幅超过 150%,增速在同类开源项目中属于第一梯队。
值得注意的是,Magnitude 的推理引擎采用 Rust 从头编写(而非基于 llama.cpp 或 Ollama 的二次封装),这是它与其他本地推理工具最大的技术差异——引擎层完全自研,针对消费级硬件做了深度优化。
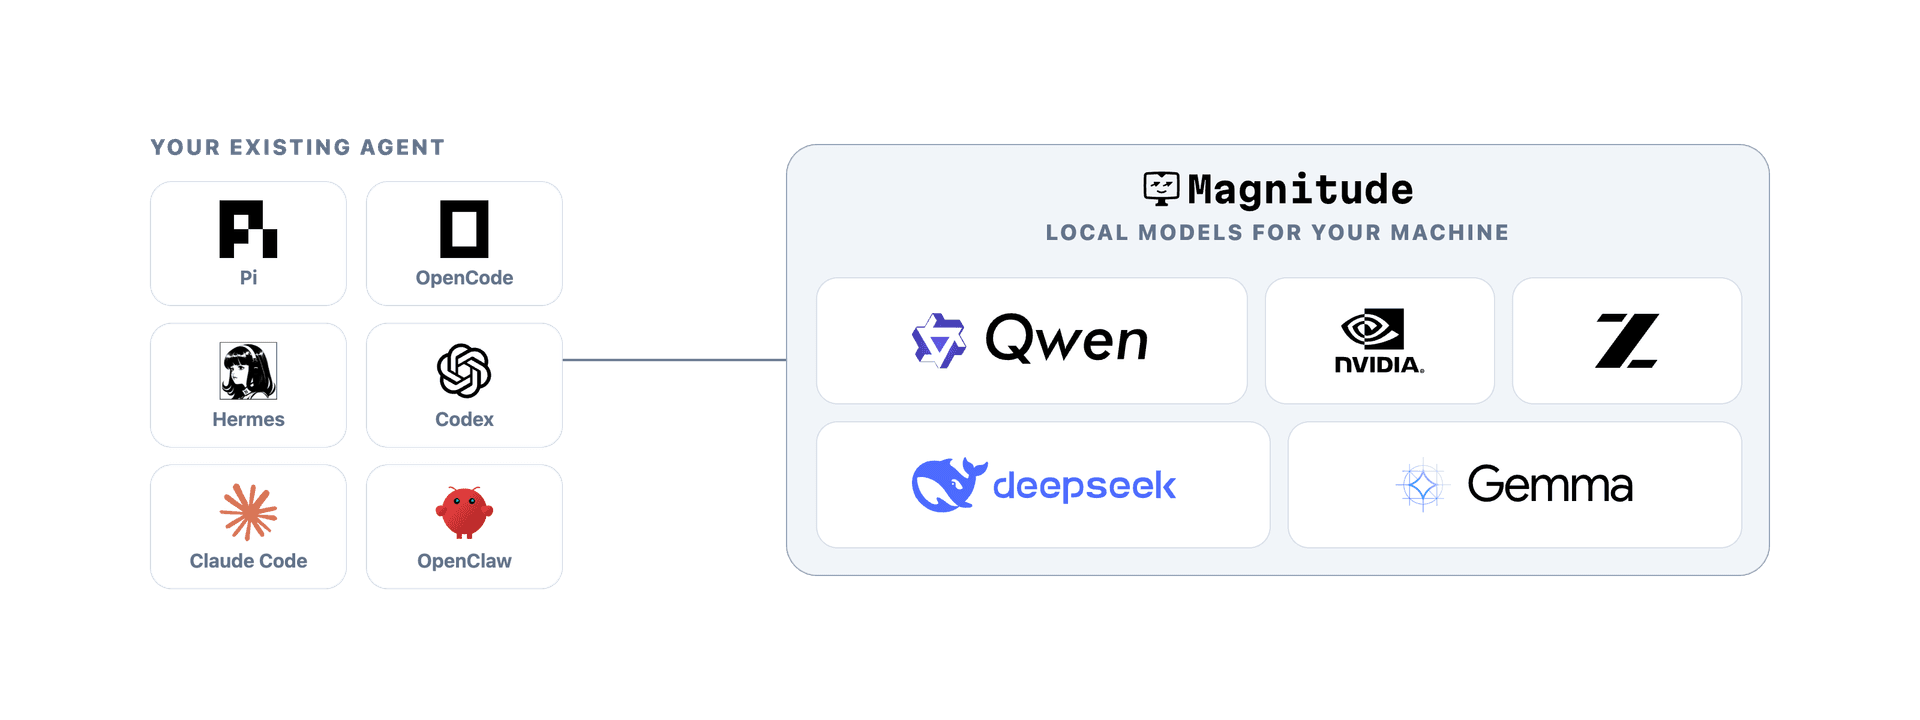
Magnitude 生态系统架构,支持多种 Agent 接入
Magnitude 启动后会对机器硬件进行基准测试(Benchmark),估算每个模型在当前硬件上的 tok/s(Token per Second)表现。这个估算在下载前就会显示,用户在下载前就能知道"这个模型在我的机器上大概跑多快",而不是下载完才发现跑不动。
测试覆盖的硬件包括:Apple Silicon(M1/M2/M3/M4 系列)、NVIDIA GPU、AMD GPU,以及纯 CPU 模式。统一内存架构设备(如 DGX Spark、Strix Halo)同样支持。
Magnitude 的核心推理引擎完全由 Rust 编写,代码位于 inference/ 子目录。这是一个 monorepo 项目,核心模块包括:
引擎支持 llama.cpp 后端和 Apple Silicon 的 MLX 加速库(通过 inference-benchmark 包中的对比实验可见),并集成了 speculative decoding 等高级推理优化技术。
Magnitude 提供"一键连接"功能,支持的主流 Agent 包括:Pi、OpenCode、Hermes、OpenClaw、Codex、Claude Code、Oh My Pi、Cline。项目声称也支持通过网关接入 Cursor 等工具。连接后,Agent 的请求通过 Magnitude 的本地 API 路由到下载好的模型上,所有数据完全在本地处理。
模型会在 Agent 需要时被加载,闲置时自动卸载。当内存紧张时,Magnitude 会优先卸载占用最大的模型,保证系统稳定性。这一机制对统一内存设备(如 Mac 的 UMA 架构)尤为重要——不需要手动管理内存分配。
Magnitude 采用 monorepo 架构,通过 npm workspaces 管理多个子包,关键目录包括:
| 目录 | 职责 | 技术栈 |
|---|---|---|
inference/ | 推理引擎核心(Rust + Node) | Rust, TypeScript |
cli/ | 命令行工具 | TypeScript, Node.js |
desktop/ | Electron 桌面应用 | Electron, TypeScript |
web/ | Web 界面组件 | React, TypeScript |
packages/acn/ | Agent 通信协议 | TypeScript |
packages/providers/ | 模型来源聚合 | TypeScript |
packages/inference-benchmark/ | 推理性能基准测试 | TypeScript |
packages/storage/ | 本地存储(配置/会话/日志) | TypeScript |
值得注意的是,packages/agent/ 目录包含 Agent 相关的实现代码,说明 Magnitude 并不只是一个推理服务器——它自身也具备 Agent 能力。代码中包含了多角色系统(advisor、architect、artisan、critic、engineer、leader、scientist、scout 等),每个角色对应不同的 prompt 策略。
Magnitude 提供三个平台的原生安装包:
.dmg 安装包.AppImage.exe 安装程序下载后运行即可,不需要 Docker,不需要命令行配置。桌面应用中内置了 magnitude CLI,无需单独安装。对于高级用户,也可以通过 npm install -g @magnitudedev/cli 安装 CLI 版本。
整个流程:
过程中最耗时的是模型下载,首次使用需要稳定的网络连接。下载完成后,模型完全本地运行,断网也能用。
| 特性 | Ollama / LM Studio | Magnitude |
|---|---|---|
| 模型选择 | 用户自己查规格 | 自动推荐 + tok/s 预估 |
| 硬件适配 | 用户手动调参 | 自动 profile + 调优 |
| 推理引擎 | 基于 llama.cpp | 自研 Rust 引擎 |
| Agent 集成 | 通用 API 兼容 | 一键连接特定 Agent |
| Apple Silicon | 有限支持 | MLX 原生加速 |
1. 模型质量依赖本地硬件:本地模型的本质决定了它受限于消费级 GPU 的算力。2026年的小型开源模型已经优于2024年的云端顶级模型,但复杂推理任务和长上下文处理仍然无法与前沿云端模型抗衡。
2. 项目相对早期:从 npm 版本 0.0.11 来看,Magnitude 仍处于快速迭代阶段,部分功能可能存在稳定性问题。8个主要贡献者意味着代码审查和测试覆盖可能不如成熟项目全面。
3. 模型目录覆盖有限:推荐模型来自 inference/catalog/models.json 中的内置目录,如果需要某个模型不在目录中,可能需要手动配置。
4. 磁盘占用:完整模型下载后占用数十 GB 存储空间,对小容量 SSD 用户不太友好。
Magnitude 代表了本地 AI 推理领域的两个趋势:
趋势一:推理引擎自研化。过去两年大多数本地推理工具基于 llama.cpp 二次开发,但 Magnitude 选择从 Rust 重写引擎,说明社区认为现有推理库在消费级硬件优化上仍有提升空间。自研引擎可以更精细地控制内存分配、硬件调度和量化策略。
趋势二:推理 + Agent 深度整合。Magnitude 不只是提供一个 API 端点,而是通过 Agent 通信协议(ACN Protocol)直接与主流 Agent 框架对接。这反映了开源社区对"推理即服务"模式的不满——人们希望的是"推理即 Agent 能力",而不是一个需要手动配置的服务器。
# macOS / Linux / Windows:下载安装包
# https://magnitude.dev/download

# CLI 安装(npm)
npm install -g @magnitudedev/cli

# 验证安装
magnitude --version

# 启动服务
magnitude serve
模型下载和硬件配置均由应用自动完成,无需手动干预。
