
imagen-pytorch
lucidrains/imagen-pytorch加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你对 AI 说「一只穿着宇航服的柴犬在火星上弹吉他」,几秒钟后,一幅细节逼真的图像出现在屏幕上——宇航服的光泽、火星表面的红褐色、吉他弦的纹理全都栩栩如生。这不是科幻,而是 Imagen 正在做的事。
2022 年 6 月,Google Research 发布 Imagen,一款基于扩散模型(Diffusion Model)的文本到图像生成系统。它在盲测中以绝对优势击败了当时的 SOTA 模型 DALL·E 2。然而 Google 当时并未开源。Phil Wang(@lucidrains)决定自己做这件事——在论文发布后不到一周内,完成了从 PyTorch 复现到开源的全过程。
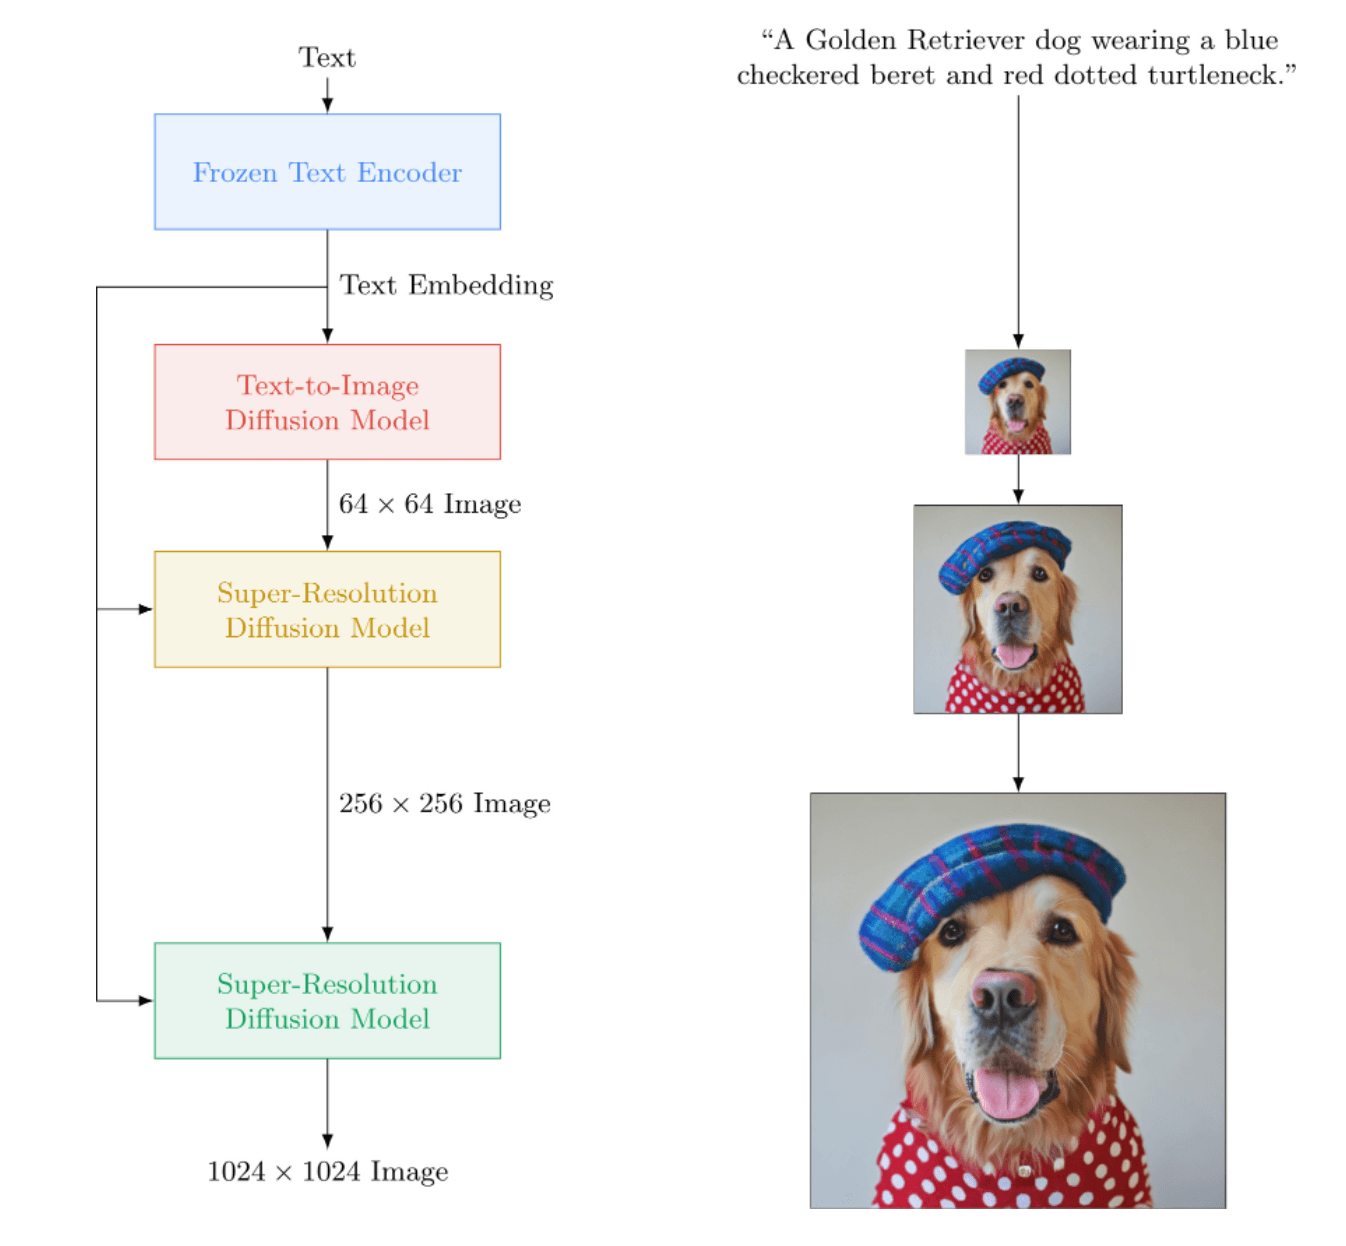
图 1:Imagen-Pytorch 生成效果示例
Google 原文对 Imagen 的定位是:「一款文本到图像的扩散模型,具备前所未有的照片级真实感和深层次的语言理解能力」。
照片级真实感 来源于级联扩散架构(Cascading DDPM)。不同于早期 GAN 生成的「一眼假」质感,扩散模型通过逐步去噪的方式生成图像,在光影、纹理、透视关系上与真实照片几乎无异。
深层次的语言理解 来自 T5 文本编码器的加持。Imagen 使用 Google 预训练的大语言模型 T5 作为文本编码器。这比同期 DALL·E 2 使用的 CLIP 模型,在复杂文本 Prompt 的理解上表现更优——尤其是对于长句、否定句、复合条件等复杂语义。
Phil Wang 的实现忠实还原了这两大核心设计,同时实现了论文中提到的 Elucidated DDPM(一种改进的扩散采样方法)。
从代码结构来看,核心模块包括:
| 文件 | 职责 |
|---|---|
imagen_pytorch.py | 主模型,包含级联 DDPM、U-Net、注意力机制 |
elucidated_imagen.py | Elucidated DDPM 变体实现 |
t5.py | T5 文本编码器封装 |
trainer.py | 分布式训练器 |
configs.py | Pydantic 配置类 |
cli.py | 命令行工具 |
imagen_video.py | 文本到视频扩展(Unet3D) |
模型采用三级级联架构:
文本条件通过 Cross-Attention 机制注入到每一级的 U-Net 中。代码使用 torch.cuda.amp 混合精度、DistributedDataParallel 分布式训练、einops 简化张量重排、beartype 运行时类型检查、pydantic v2 配置验证。
这是一个纯训练/推理库,没有 Web UI,适合有深度学习经验的开发者。
安装:pip install imagen-pytorch,自动安装 PyTorch、transformers(T5)、einops、ema-pytorch、accelerate、kornia 等依赖。
硬件要求:训练推荐 NVIDIA RTX 3090+,16GB+ 显存,32GB+ 内存,50GB+ 硬盘。推理显存需求较低,建议至少 8GB。
CLI 快速体验:imagen_pytorch --text "a cat sitting on a piano"
仓库已收获超过 8400 颗星,104 个 open issues,社区活跃度较高。
存在的局限:
transformers 下载(许可证原因)Phil Wang 的工作代表了开源 AI 社区的一种独特力量:快速复现、最快开源。在 Google 论文发布一周内完成复现并开源,全球数千名开发者基于这个仓库进行了二次开发和学术研究。
从技术演进角度看,Imagen 的核心思想(级联扩散 + 大语言模型文本编码)深刻影响了后续的 SDXL、Stable Diffusion 3 等项目。虽然这个仓库本身已不再是 SOTA,但它代表的那个「大胆复现、快速开源」的精神,是开源 AI 生态中最珍贵的东西。
适合人群: 深度学习研究者、AI 工程师、计算机视觉方向学生
上手门槛: 需要 Python 基础 + PyTorch 经验 + GPU 环境
