
loopx
loopx-project/loopx加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你给一个编程 Agent 下达了一个「把项目里最慢的工作流提速」的任务,然后关掉电脑去睡觉。第二天你打开电脑,发现 Agent 在第 3 小时遇到一个反直觉的失败分支,它自己查了资料、换了思路、记下了决策依据,然后继续跑——第 47 小时,它真的交出了一个带 benchmark 数据的补丁。这一切跨越了两个会话、一次进程重启、一次模型切换。
绝大多数 AI 编码工具做不到这一点。它们的设计假设是「一个会话 = 一段连续时间」,会话一断,目标、决策依据、中间证据就全部蒸发。Agent 重启后要么从零开始,要么靠一句模糊的对话摘要硬接上去。
LoopX(GitHub 6556 star)就是来解决这个问题的。它的自我描述很直白:把长周期目标变成可验证的结果(Turn long-horizon goals into verifiable results)。它不是又一个「帮你写代码的 AI」,而是给 Agent 团队造的一套本地优先的语义控制平面——你可以把它理解成给 Agent 团队配的「Jira + 决策留痕 + 证据链」三合一基础设施,只不过被管的对象是模型,而不是人。
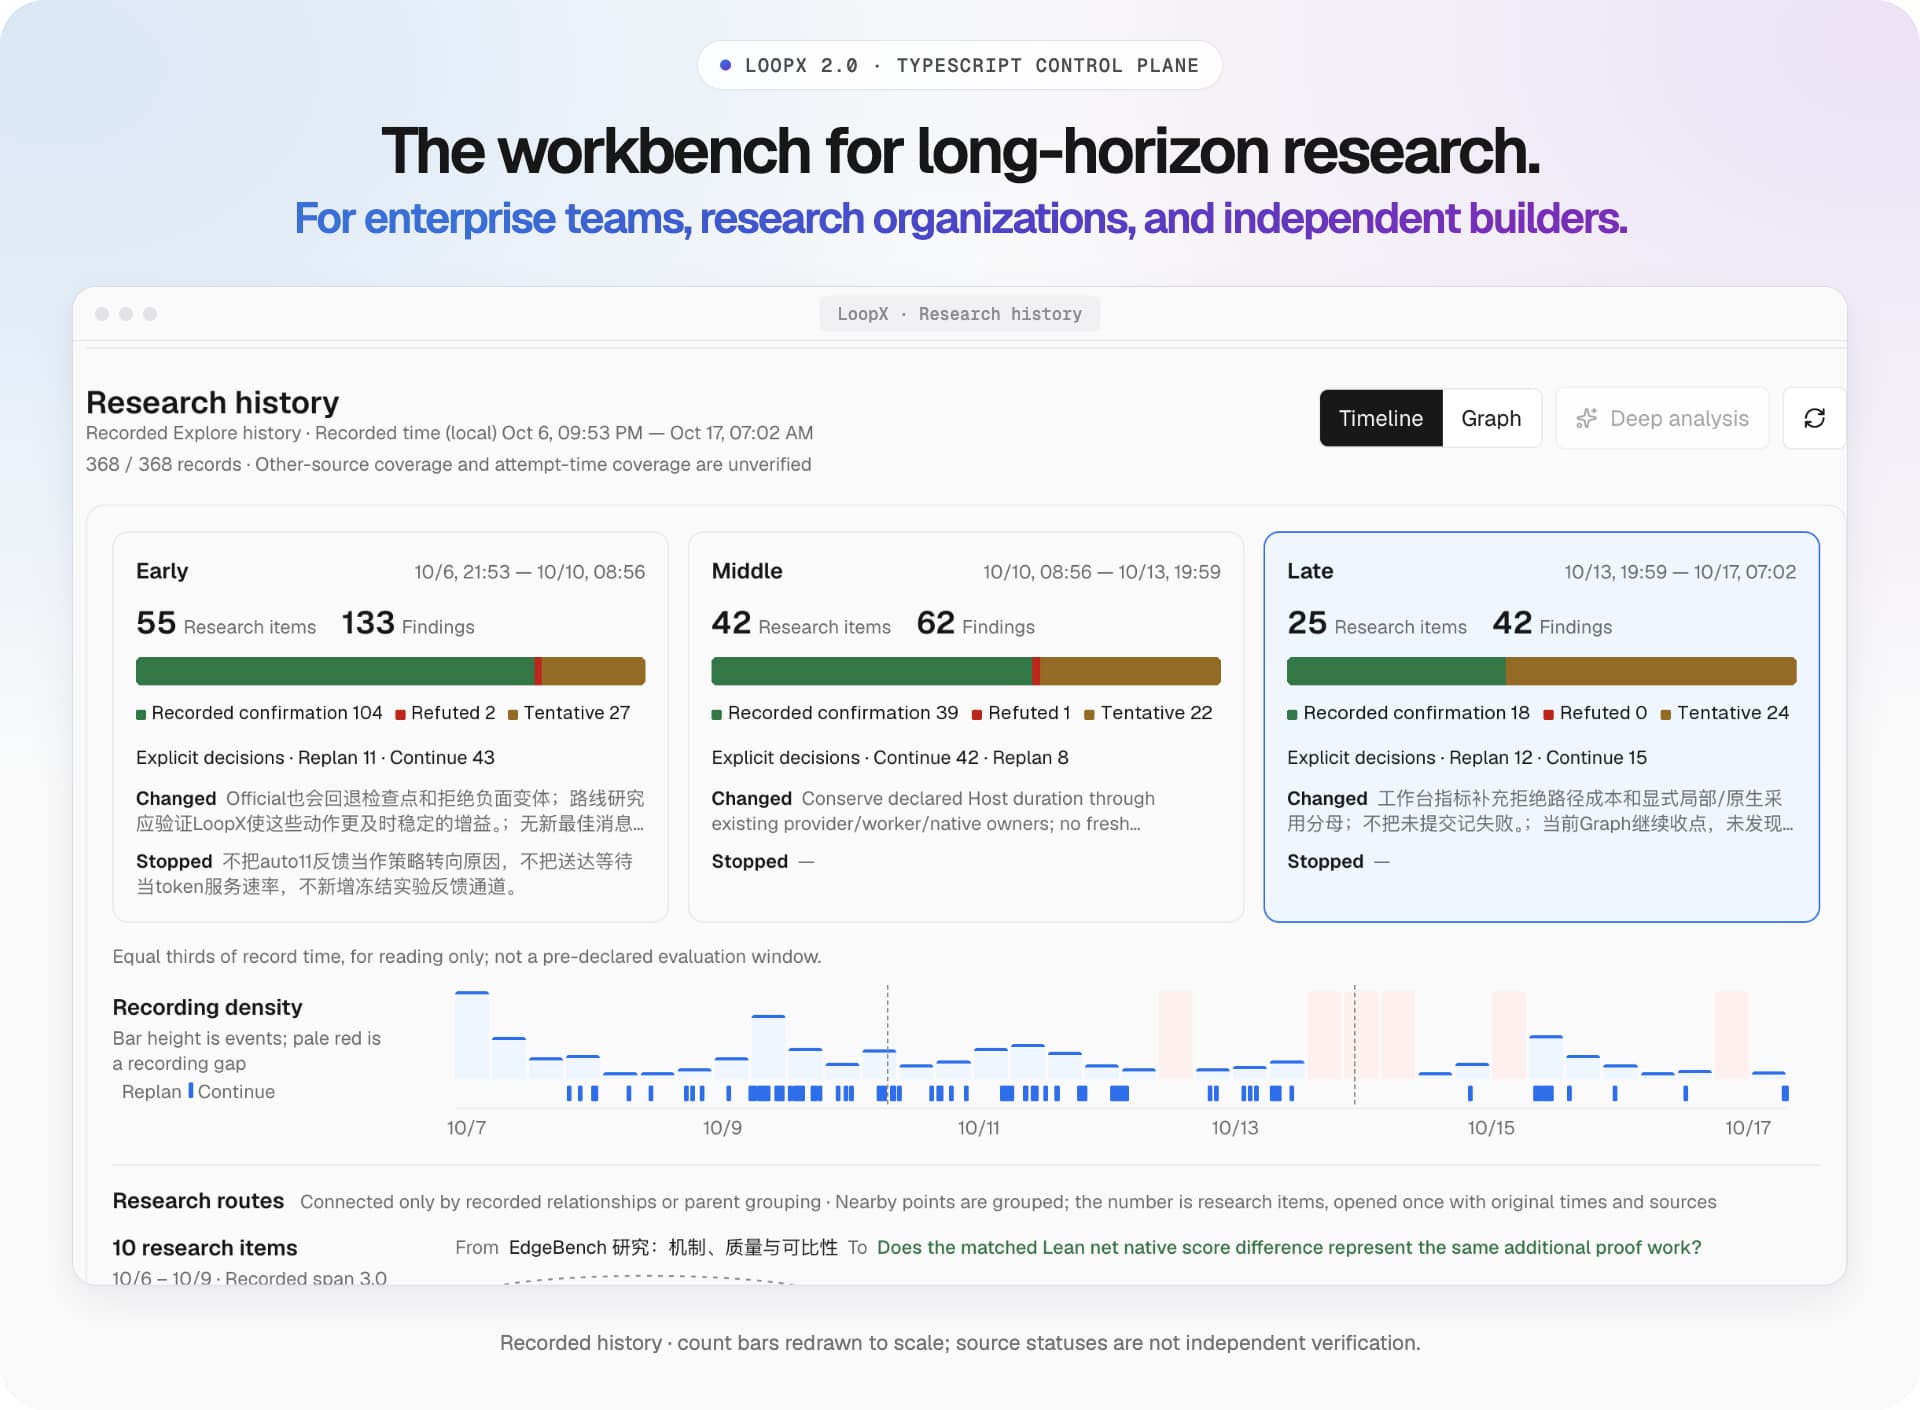
LoopX 由 huangruiteng 主导开发,2026 年 5 月 31 日建仓,到 2026 年 10 月发布 2.0 大版本时已经冲到 GitHub Trending 榜首(README 里挂着 Trendshift 的 #1 徽章),并在 DSH 插件目录上架。项目 6 个多月从 0 做到 6500+ star,119 位贡献者参与,核心作者一人贡献了 8200+ 次提交。
背景是 2026 年 AI Agent 行业的一个共同痛点:Agent 能力已经够强,但「长时间运行的可靠性」远远不够。模型单次任务表现优异,可一旦任务跨越几十小时、涉及多次自我纠错和外部工具调用,就会出现目标漂移、决策丢失、证据失真、重复劳动等一系列问题。LoopX 的思路不是去训练更强的模型,而是在模型外面加一层有状态的控制平面,把「意图、状态、证据、权限」从模型的临时上下文里搬出来,落到本地磁盘上。
这个判断在 2026 年下半年的行业共识里越来越站得住脚:Claude Code、Codex CLI 这类 harness 都在往「长时间循环 + 工具调用 + 可恢复」的方向走,而 LoopX 选择先做控制层,再通过适配器去兼容各家运行时。
把 Agent 团队想象成一个要连续施工三个月的装修队。
这就是它强调的 local-first:控制平面、状态、证据全部在你自己的机器上,你换 Codex、Claude Code、DeepSeek Harness 甚至直接调模型,工期和档案都不丢。
LoopX 的心脏。它维护一套明确的语义对象:Goal(目标及其验收标准)、Todo(可认领的任务)、Decision(决策及理由)、Evidence(证据与产物)、Work Item(委派工作项)、Quota(配额与 should-run 语义)。2.0 版本把这套内核从 Python 重构为 TypeScript 共享控制平面,Python 与前端共用同一份状态契约,CLI 与 Web UI 不会产生「两个真相来源」。
这是 LoopX 1.0 起的主打形态。loopx dashboard 一条命令拉起基于 React + Vite 的 PWA 工作台,配合本地状态服务(8766 端口)与 Chat 服务(8767 端口),可以在浏览器里查看「什么需要你处理、什么正在跑、什么被监控、什么已排期或已停止」,配置 Goal 能力与子任务容量,审阅受保护的改动并做显式确认。桌面端还提供基于 Tauri 的原生预览版(macOS Apple Silicon 与 Windows NSIS)。
LoopX 的差异化机制是 Heartbeat:不是让 Agent 连续跑,而是周期性唤醒 Agent,让它每轮都重新从控制平面读取当前状态和配额判断,再决定是否继续。关键在于每一轮续跑都必须重新经过 quota should-run 这道门,而不是靠 Agent 自己的记忆判断要不要停。这让它在长任务下更容易保持节奏,也更容易被观测和中断。
LoopX 不做模型,它做 harness 的上游。仓库内置了对 Codex App / Codex CLI、Claude Code、DeepSeek Harness(DSH)、KunlunCode、OpenCode / OpenCode2、Pi、ZCode、Antigravity CLI(agy)、Kiro CLI、Cursor 等十余种运行时的适配层,并提供 MCP 接入(goal_mode_mcp、collaboration_mcp)以及飞书(Lark)群聊的 Manager 通道。对不同宿主的续跑语义差异,LoopX 做了显式区分——比如 Codex 用 heartbeat automation,Claude Code 用原生 /loop,Kiro CLI 用 /goal --max N 迭代预算。
仓库内建 benchmark/ 目录,跑过 LHTB(Long-Horizon Terminal-Bench,46 任务)、SWE-Marathon(15 任务、5 种执行模式)、DeepSWE 行为分析与 EdgeBench 等研究性评测,并提供 Explore Graph、材料库(Materials)、奖励记忆流水线等研究能力。这让它不只是工具,也是一个可复现的实验场。
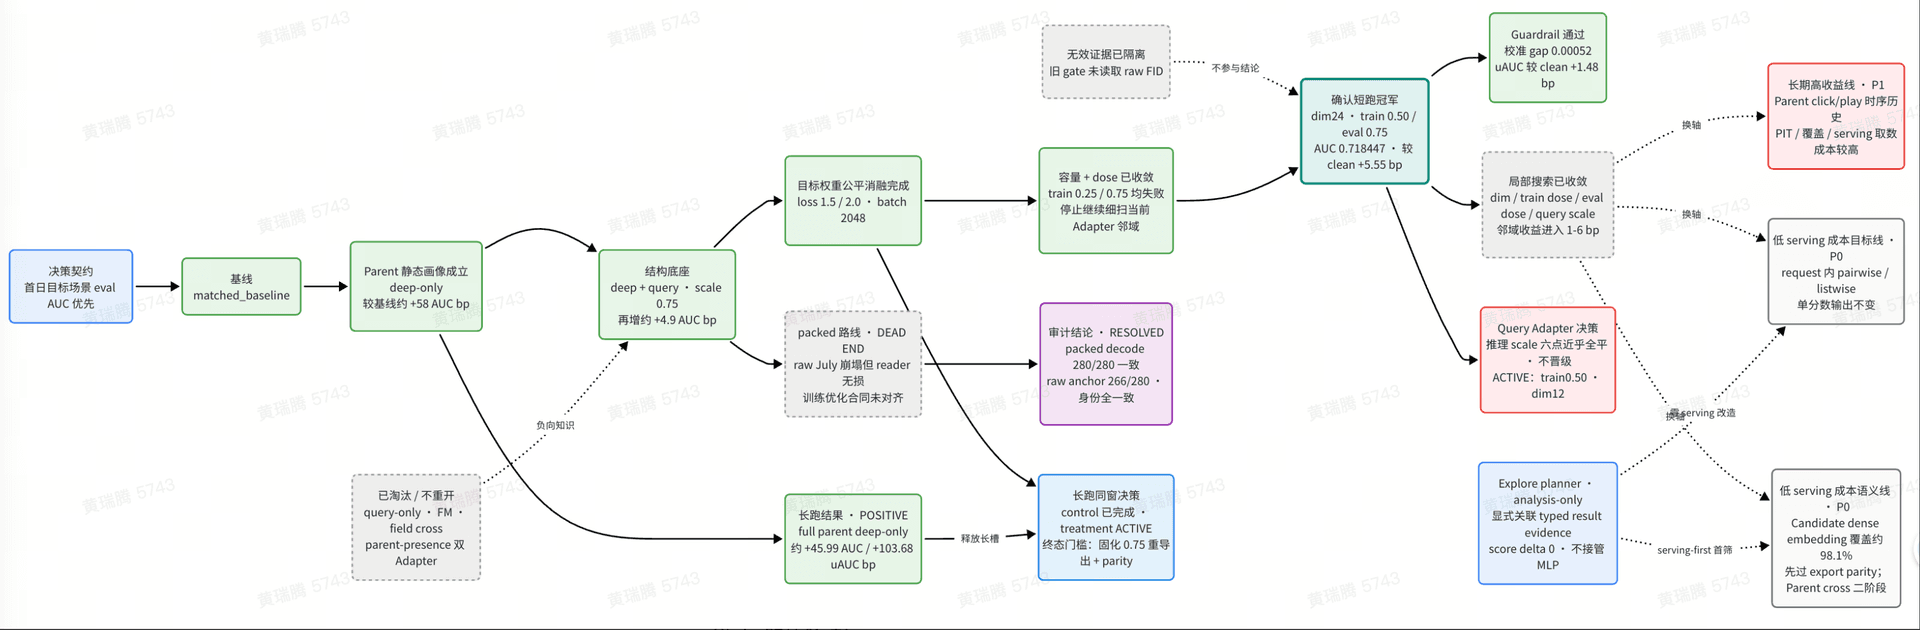
skills/ 下有 10 个官方技能(loopx-project、loopx-change-quality、loopx-performance-diagnosis、loopx-pr-review 等),packages/ 下有 13 个插件包(媒体、金融、代码审查队列、飞书扩展等)。项目还有完整的多语言社区:英文 README + 简体中文 README + 双语开发者手册 + 飞书公开用户手册。
最省事的路径(CLI,约 10-20 分钟):
# 需要 Python 3.11+ 与 Node.js 22.22.3+(推荐 24 LTS)
python3 -m pip install --upgrade loopx && loopx workflow-skills --install
然后重启你的 Agent 宿主,在项目里对 Codex 说 $loopx 提速这个项目最慢的工作流,比较方案并验证收益,Claude Code 用 /loopx <复杂任务>。诊断用 loopx doctor,看状态用 loopx status。
想要可视化:Web UI。 loopx dashboard 启动浏览器工作台。仓库也提供了 demo/workspace 可复现场景(社区活动、家电能耗对比、邻里网站发布三个场景,各含 4 个工作角色、18 个任务、2 个决策、2 个监控),不需要任何私有状态就能跑起来看效果。
必须提前知道的三个门槛:
MINIMUM_NODE_VERSION 会直接卡住。
第一,基准数字要看清楚口径。 README 里最亮的数字是 LHTB:LoopX 1.0.3 Heartbeat 平均 reward 0.4948,比 Plain Codex 高 17.3%,比 Codex 原生 Goal 高 10.6%。但作者自己在同一段落里做了非常重要的限定:只有 46 个任务、每任务每模式仅一次有效试验,部分替换试验的运行时间与预算不对等;对原生 Goal 是 23 个任务提升、13 个持平、10 个任务退步;严格通过率与 Plain Codex 持平。作者明确写明「这不是同等预算下的效率结论,也不是 LoopX 因果效应的隔离估计」。这种自我限定在开源项目里并不常见,反而提升了可信度——但读者必须自己看方法论,别只看 17.3% 这个数。
第二,200+ 小时案例是「墙钟时间」不是「连续算力」。 OpenViking 贡献序列和 Auto ML 实验都被描述为跨越 200+ 小时,作者明确标注这是 elapsed wall-clock project time,而非持续模型执行或无人值守生产自主性。这两个案例一个是作者自己 dogfooding,一个是脱敏后的自有展示,都不是独立复现。
第三,工程复杂度已经明显超出「一个小工具」。 loopx/ 核心包 149 个文件、tests/ 下 429 个测试文件、docs/ 37 个目录、另有 TypeScript 内核、Python 包、Tauri 桌面端、React 工作台、13 个插件包、10 个技能包、三种语言的 CLI 扩展。开发者贡献 119 人,Top 3 贡献者占了绝大部分提交量——这对社区健康度是个隐忧,也说明维护者精力是单点风险。
第四,能力高度依赖宿主 Agent。 LoopX 自己不调用模型,它把「怎么调模型」这件事外包给 Codex / Claude Code / DSH。这意味着:宿主的行为变更、额度限制、模型下线,都会直接传导到 LoopX 的可用性;Kiro CLI 这类宿主甚至只被描述为「advisory pacing, not a host-enforced gate」——门禁并不真的强制。
第五,隐私边界值得单独核实。 local-first 听起来安全,但项目集成了飞书通道、公开 case 展示、star-history 图表,甚至有 public-safe text 过滤与 public/private boundary 文档——说明作者也在与「不小心泄漏私有路径/摘要」的持续搏斗。使用前建议自行审阅 outbound 数据流。
LoopX 的走红本身就是一个信号:2026 年下半年开源社区的关注点,已经从「谁的模型更聪明」转向「谁能让 Agent 在长时间里可靠地干活」。这与 MCP(Model Context Protocol)、Agent harness、Skills 生态的兴起是同一条脉络——标准化 Agent 的外围工程,而不是再造一个模型。
更值得注意的是它选择的架构姿态:用适配器矩阵去兼容所有主流宿主,而不是赌某一个宿主赢。Codex、Claude Code、DeepSeek Harness、OpenCode、Kiro……LoopX 想做的是这一层的「标准件供应商」。这种不押注单一生态的做法在开源项目里少见,也解释了它为什么能在短时间聚集 119 位贡献者和大量第三方插件。
而它对「长周期 Agent 基准」(LHTB、EdgeBench)和「跨会话证据留存」的强调,也预示着评估体系会从单次问答分数,逐步转向长时间跨度下的成果可验证性——Agent 交出来的东西,能不能拿出证据链让人验。
适合: 已经在用 Codex / Claude Code,需要把「跑几小时的活」变成「跑几天的活」的技术团队;需要审计 Agent 决策与证据的合规场景;愿意自己搭 harness 层、愿意读文档的高级用户。
不适合: 想要开箱即用图形界面、一键出结果的普通用户;没有 Agent 运行时账号和模型额度的人;不接受本地状态管理复杂度、只想「Ctrl+C 就完事」的轻度使用者。
必须自己核实的三件事: LHTB 的 17.3% 增益在同等预算下是否还成立;200+ 小时案例在你的实际工作负载下是否可复制;以及 2.0 的 TypeScript 重构是否已经稳定(README 显示 2.2.0 仍在活跃迭代,176 个 open issue)。
项目速览
| 项 | 值 |
|---|---|
| 仓库 | loopx-project/loopx |
| Star / Fork | 6556 / 616 |
| 语言 | Python 主控 + TypeScript 控制平面内核 |
| 许可证 | Apache-2.0(同时提供 MIT) |
| 最低环境 | Python 3.11+ / Node.js 22.22.3+ |
| 容器化 | 无官方 Dockerfile / compose(仅 benchmark 验证镜像) |
| Web UI | React + Vite PWA(loopx dashboard)+ Tauri 桌面预览 |
| 适配宿主 | Codex App/CLI、Claude Code、DSH、KunlunCode、OpenCode、Pi、ZCode、agy、Kiro、Cursor 等 |
| 外部依赖 | 需自备 Agent 运行时账号与模型额度;可选飞书/MCP/PostgreSQL |
