
oasisdb
lizzy-0323/oasisdb加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你向一个 RAG 系统抛出了问题:「上个季度营收下滑的主要原因是什么?」几毫秒后,AI 返回了精准的答案。你可能不知道的是,在那背后,一个向量数据库正在高速运转——它把你的问题翻译成一串数字(向量),然后在数十亿条文本中寻找「数学意义上最接近」的内容。
这个过程叫向量相似度检索,而今天要介绍的工具,就是让你能亲手搭建这套系统的「学习版」——OasisDB。
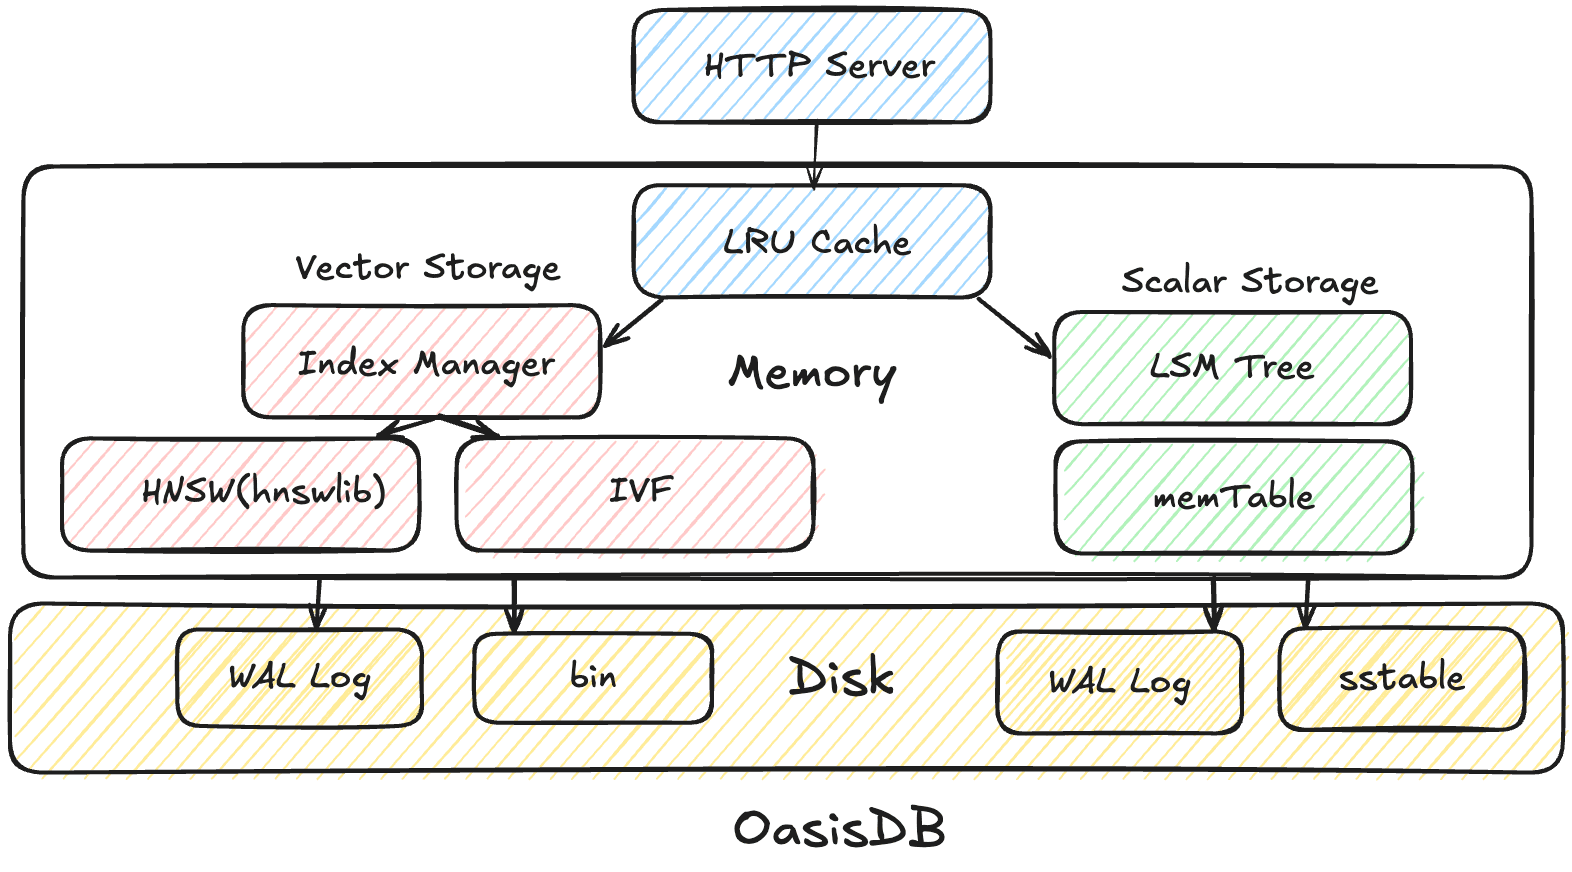
市面上已有不少成熟的向量数据库:Milvus 功能全面、Qdrant 性能优异、Pinecone 是云端即服务……但对初学者而言,它们的架构过于复杂,Milvus 甚至本身就是分布式设计,部署一套本地测试环境就要折腾半天。
OasisDB 的作者(GitHub @lizzy-0323)意识到一个问题:很多人想理解向量数据库的底层原理,却找不到一个足够轻量的学习样本。于是他决定自己写一个。
设计目标非常明确:
换句话说,OasisDB 不是要和 Milvus 竞争,它是一本可以运行的教科书。
OasisDB 支持多种向量索引算法,不同算法在速度、精度和内存占用之间做取舍:
| 索引类型 | 原理 | 优势 | 适用场景 |
|---|---|---|---|
| HNSW | 分层可导航小世界图 | 查询极快(毫秒级) | 对延迟敏感的生产环境 |
| IVFFLAT | 倒排文件+暴力聚类 | 精度高,内存适中 | 小规模、高精度需求 |
| IVFPQ | 倒排文件+乘积量化 | 内存占用大幅压缩 | 海量数据、精度可接受 |
| Flat | 暴力全量比较 | 100% 精确 | 数据量小、追求绝对精度 |
这些算法在代码中分别位于 internal/engine(HNSW)和 internal/index(IVF)目录,作者对每种都实现了完整的 CRUD 操作。
根据 docs/design-CN.md 中的设计文档,OasisDB 内部划分为五层:
1. 网关层(RESTful API)
基于 Go 语言生态中最流行的 Gin 框架实现 HTTP 接口,接收查询请求并返回结果。Python SDK(client-sdk/python/)和 Go SDK(client-sdk/go/)都封装了这套 API。
2. LRU 缓存层
对热门查询结果进行缓存,缓存 Key 由「向量 + topk」共同决定,避免重复计算同一检索请求。
3. 向量存储层
这是核心中的核心:
hnswlib(一个 C++ 库,通过 internal/engine/ 中的 Go 绑定调用)4. 标量存储层
负责存储向量的元数据(KV 键值对)。作者选择了 LSM Tree(Log-Structured Merge Tree)架构,参考 RocksDB 的设计:
5. Embedding 服务层(可选)
内置对阿里云 DashScope 嵌入 API 的支持,查询时可直接传入文本、后台自动完成向量化,无需额外搭建 embedding 服务。当然你也可以用 OpenAI 或任何兼容接口。
语言:        Go 1.23
HTTP 框架:   Gin (github.com/gin-gonic/gin)
日志:        Zap (uber.org/zap)
向量引擎:    hnswlib (C++) + 自研 IVF
存储引擎:    自研 LSM Tree
配置管理:    YAML (gopkg.in/yaml.v3)
测试框架:    testify (github.com/stretchr/testify)
构建工具:    Makefile + CMake
路线 A:Docker 容器(推荐新手)
docker build -t oasisdb:latest -f Dockerfile .
docker run --rm -p 8080:8080 oasisdb:latest
Dockerfile 采用 Go + CMake + clang 多阶段构建,最终镜像基于 debian:bullseye-slim,暴露 8080 端口,一键拉起。
路线 B:源码编译
make build      # 编译 C++ 向量引擎 + Go 主程序
./bin/oasisdb  # 直接运行
路线 C:使用脚本一键启动
chmod +x ./scripts/start.sh
./scripts/start.sh
启动后访问 http://localhost:8080 即可以开始操作。
from client import OasisDBClient

client = OasisDBClient()          # 默认连接 localhost:8080
client.health_check()             # True = 服务正常

# 创建集合(HNSW 索引)
client.create_collection("movies", 768, index_type="hnsw", parameters={"efConstruction": "200"})

# 批量写入文档
client.batch_upsert_documents("movies", [
    {"doc_id": "doc1", "vector": [...], "text": "《星际穿越》是一部诺兰导演的科幻片"},
    {"doc_id": "doc2", "vector": [...], "text": "《盗梦空间》讲述梦境中的层层嵌套"},
])

# 检索
result = client.search_documents("movies", query_vector=[...], limit=5)
坦诚地说,OasisDB 不是万能的:
对于想快速搭建生产级 RAG 系统的用户,Milvus 或 Qdrant 仍是更稳妥的选择;但对于想理解向量数据库原理的学生和独立开发者,OasisDB 是不二之选。
随着大模型上下文窗口不断增大(GPT-4o 128K tokens、Claude 200K tokens),有人认为向量数据库会被「上下文替代」。但现实是:长上下文是有成本的——Token 费用、推理延迟、注意力退化问题依然存在。向量检索作为「外部知识钩子」的角色短期内不会消失。
更值得关注的是趋势:开发者越来越倾向于用更少的组件搭建系统。Oceanbase、PostgreSQL(pgvector)、Redis(RediSearch)纷纷内置向量能力,就是这个趋势的体现。OasisDB 恰好站在了这个交叉点——它既是学习工具,也代表了一种「小即是美」的工程哲学。
OasisDB 是一个可以塞进背包的向量数据库实验室:架构清晰、代码自研、体积极小。它不追求替代任何产品,它的使命是让更多人真正理解向量检索这件事是怎么发生的。
