
LangChain-Chinese-Getting-Started-Guide
liaokongVFX/LangChain-Chinese-Getting-Started-Guide加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
如果你是在 2023 年 4 月前后接触过大模型应用开发,大概率翻过这篇《LangChain 中文入门教程》。它有一万多个 star,是 GitHub 上最被低估的中文 AI 教程之一——不是因为内容差,恰恰相反,它讲得非常清楚。问题在于:它记录的是一个已经消失的技术栈。
今天我们把它拆开看,看看一个 9148 star 的项目是怎么在三年里从"最实用"变成"最好的历史教材"的。
2023 年 4 月 7 日,仓库创建。那是一个 OpenAI API 生态充满野心的阶段:GPT-3.5 Turbo 刚发布两个月,函数调用(Function Calling)刚把 ChatGPT 的能力暴露成 API;LangChain 自己也才刚站稳脚跟,官方文档还挂在 python.langchain.com 这个后来被反复改名的域名下。
在那时,开源 LLM API 有三个绕不开的痛点,而这篇教程的每一个章节,几乎都是在解决其中一个:
作者用一句话概括了动机:"众所周知 OpenAI 的 API 无法联网的,所以如果只使用自己的功能实现联网搜索并给出回答、总结 PDF 文档、基于某个 Youtube 视频进行问答等等的功能肯定是无法实现的。"
这句话放在 2023 年 4 月是常识,放在今天是废话——但在当时,它精准定义了"大模型应用开发"这件事的全部难点。
教程的骨架非常清晰,分成"必知概念"和"实战"两段。
概念层教了六个 LangChain 核心抽象:Loader(加载器)、Document(文档对象)、Text Splitters(文本分割)、Vectorstores(向量数据库)、Chain(链)、Agent(代理),外加 Embedding。
作者对 Chain 的比喻相当贴切:"我们可以把 Chain 理解为任务。一个 Chain 就是一个任务,当然也可以像链条一样,一个一个的执行多个链。"
Agent 的定义也简单直接:"可以简单的理解为他可以动态的帮我们选择和调用 chain 或者已有的工具。"后面还附了一张 ReAct 执行流程图,把"思考—调用工具—观察结果—再思考"的循环画了出来。
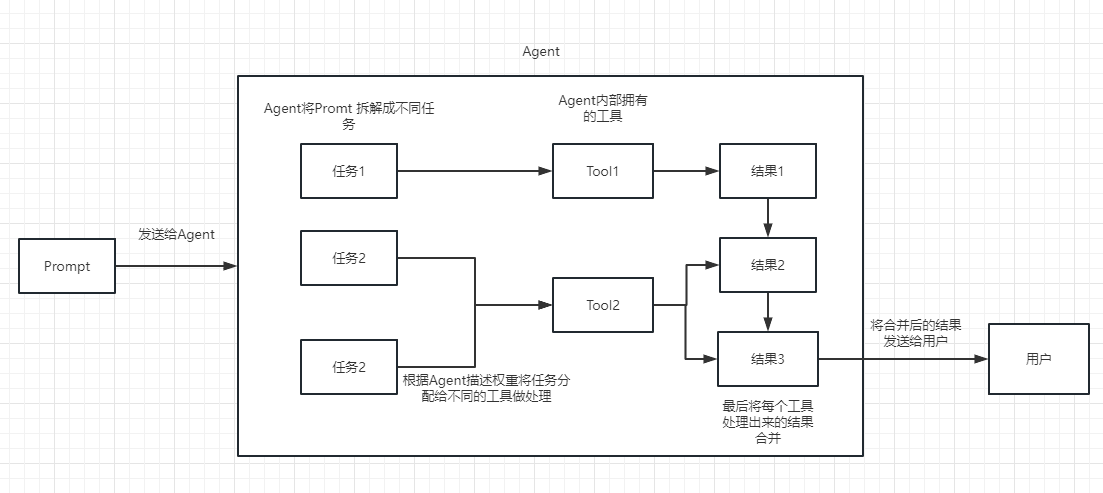
Agent 的 ReAct 循环:模型自己决定调用哪个工具,这是整篇教程里最有前瞻性的一张图
实战层从"完成一次问答"这种三行代码开始,一步步加复杂度:
每一个案例都配了运行结果截图和逐行讲解。比如知识库问答那段,作者不仅给出代码,还解释了每一步在干什么:
loader = DirectoryLoader('/content/sample_data/data/', glob='**/*.txt')
documents = loader.load()
text_splitter = CharacterTextSplitter(chunk_size=100, chunk_overlap=0)
split_docs = text_splitter.split_documents(documents)
embeddings = OpenAIEmbeddings()
docsearch = Chroma.from_documents(split_docs, embeddings)
qa = RetrievalQA.from_chain_type(llm=OpenAI(), chain_type="stuff",
                               retriever=docsearch.as_retriever(),
                               return_source_documents=True)
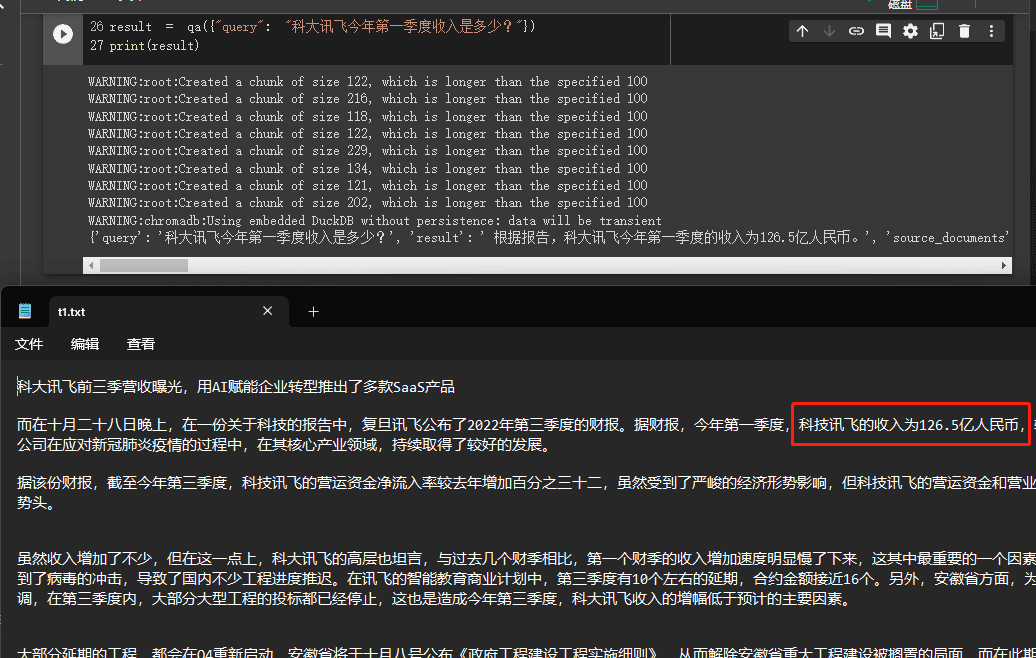
检索增强问答的完整链路:加载 → 切分 → 向量化 → 入库 → 检索 → 生成
用生活化的比喻说,这套流程就像图书馆:Loader 是把整座图书馆的书搬回来,Text Splitter 是按主题给书分册,Embedding 是给每本书贴上主题标签,Vectorstores 是建了一套标签检索系统,Chain 就是图书管理员的工作流程。
这里有个关键区别:这是一个文档仓库,不是一个软件包。
仓库里只有 30 个文件,3 个 Markdown、24 张截图、1 个测试数据文本,没有任何 .ipynb 文件——所有示例代码以代码块形式内嵌在 README 里,末尾附了一个 Google Colab 链接供一键运行。
这意味着:
部署维度看,这几乎是零门槛:无 Dockerfile、无 docker-compose、无 K8s manifest、无 Web UI。它不是一个需要被部署的服务,而是一本可以直接读的文档。
最大的问题是技术栈过时。 作者自己在 README 顶部就贴了免责声明:"因为 langchain 库一直在飞速更新迭代,但该文档写于4月初……所以 colab 里面的代码有可能有些已经过时。"
具体过时在哪:
from langchain.llms import OpenAI —— 这条导入路径在 LangChain 0.3 已废弃,现在推荐 from langchain_openai import ChatOpenAItext-davinci-003 —— 2023 年 6 月就被 OpenAI 下线了,今天调用必然报错initialize_agent / AgentType.ZERO_SHOT_REACT_DESCRIPTION —— 0.2 版本起 LangChain 官方推荐迁移到 LCEL(prompt | model | tools 管道语法),AgentExecutor 已进入维护状态,官方文档明确说 LangGraph 才是构建 agent 的推荐路径Chroma.persist_directory 的 persist() 调用方式在 Chroma 新版本中已重构SQLDatabaseChain 属于被标记为不安全、不推荐在新项目使用的模式(模型生成的 SQL 直接执行存在注入风险)其次是维护状态。 CHANGELOG 最后一条记录停在 2023 年 5 月 10 日,而仓库 pushed_at 显示 2026 年 4 月仍有推送——但结合贡献者只有 10 人、提交总数 58 次来看,后期推送更可能是自动化机器人(GitBook 同步)而非内容更新。这份文档在实质上已经停止维护。
第三是内容深度。 它明确定位为"初级讲解":"这篇文章只是对 LangChain 一个初级的讲解,高级的功能希望大家继续探索。" 没有代码测试、没有 CI、没有版本管理、没有贡献指南,仓库甚至没有 LICENSE 文件(PIFS 库中标记为 "Not specified")。对教程类项目这不算致命,但商用或二次分发时存在授权风险。
第四是代码质量维度: 零自动化测试(仓库内无 tests/ 目录),文档质量则相当高——中文表达流畅、示例可运行、概念解释到位,唯一的硬伤是时效性。
把这篇文档放到大背景里看,它记录的是一次完整的范式切换。
2023 年初,"大模型应用开发"的主流范式是 Chain(链)——把任务拆成固定的、有向的流水线。LangChain 的 initialize_agent、各种 *Chain 类,本质上都是这个范式的产物。作者在文末写"我希望这个系列只是一个开始",背后是一整套"链式编排"方法论。
2023 年底到 2024 年,范式转向 LCEL(LangChain Expression Language),用 | 管道组合可组合组件,强调流式、异步和批处理。
2024 年之后,范式进一步转向 LangGraph——有状态的图式 Agent,支持循环、人工介入(human-in-the-loop)和多 agent 协作。LangChain 自身从"应用开发框架"收缩为"模型与工具接入层"。
这篇教程停在了第一范式的黄金时期。它的价值因此发生了转移:从"教你怎么做"变成了"帮你理解为什么"。
有意思的是,它的几个判断在三年后依然成立——作者说"LangChain 迭代极快",而这恰恰是他不能持续更新的原因;他说"非常看好这个开源库",也没错,LangChain 生态确实长成了 LangGraph、LangSmith、LangServe 的完整矩阵;他希望读者"开发出更有创意的产品,而不仅仅只搞一堆各种一键搭建 chatgpt 聊天客户端"——这句话在 2024 年"套壳 API 洗稿"争议爆发时回看,简直是预言。
值得一提的是,作者后来把这套方法论商业化成了一本纸质书《LangChain技术解密:构建大模型应用的全景指南》,中文 AI 教程作者能出书,本身就是内容质量的背书。他同期还做了《MCP 编程极速入门》——从 MCP(Model Context Protocol)的角度看,2023 年 4 月这个时点恰好是协议爆红的前一年。
如果你在 2026 年想用这份教程:
langchain.llms.OpenAI 换成 langchain_openai.ChatOpenAI,把 text-davinci-003 换成 gpt-4o-mini 之类,把 initialize_agent 重写为 LCEL 管道9.1k star、10 位贡献者、58 次提交、零测试、零许可证、CHANGELOG 停在 2023 年 5 月——但一个仓库最重要的指标从来不是这些。对教程而言,是有多少人因为它第一次跑通了人生第一个 RAG 机器人。这个数字,此刻还在增长。
