
moli
lexmount/moli加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你让一个 AI Agent 去抓取 100 个行业资讯页面、提取正文、顺便把其中 5 个页面转成 PDF 摘要。Agent 手里最顺手的工具是 Playwright 或 Puppeteer——但每一次 page.content() 调用背后,Chromium 都在后台忙着做布局、绘制像素、合成图层。你只为读一段文字,却让浏览器渲染了一整张画面。
这就是「结构优先(structure-first)」与「像素优先」的错配。Moli 的作者把这个矛盾摆在了台面上:Agent 绝大多数时候需要的是页面结构,而不是一张持续渲染的视觉世界。于是这个 2026 年 8 月才创建、不到三个月就冲到 2 万星的项目,选择了一条相当激进的路——不用 Chromium 包装,而是用 Rust 从零写一个浏览器内核。
Moli 来自 Lexmount 团队。他们的自我定位很直接:Moli 是 Lexmount 的开源无头浏览器内核,围绕它还构建了商业化的云端运行时 Lexmount Browser(提供托管云浏览器、内网访问、自动过验证码等能力)。README 里明确写了一句:开源的无头浏览器完全不依赖 Lexmount Browser 也能独立使用。
商业与开源的边界划得很干净——内核开源、云服务收费,这在国内开源项目里算是少见的克制。仓库采用 MIT OR Apache-2.0 双协议,2026 年 10 月已发布到 v1.1.19,迭代节奏非常密(基本两三天一个小版本)。
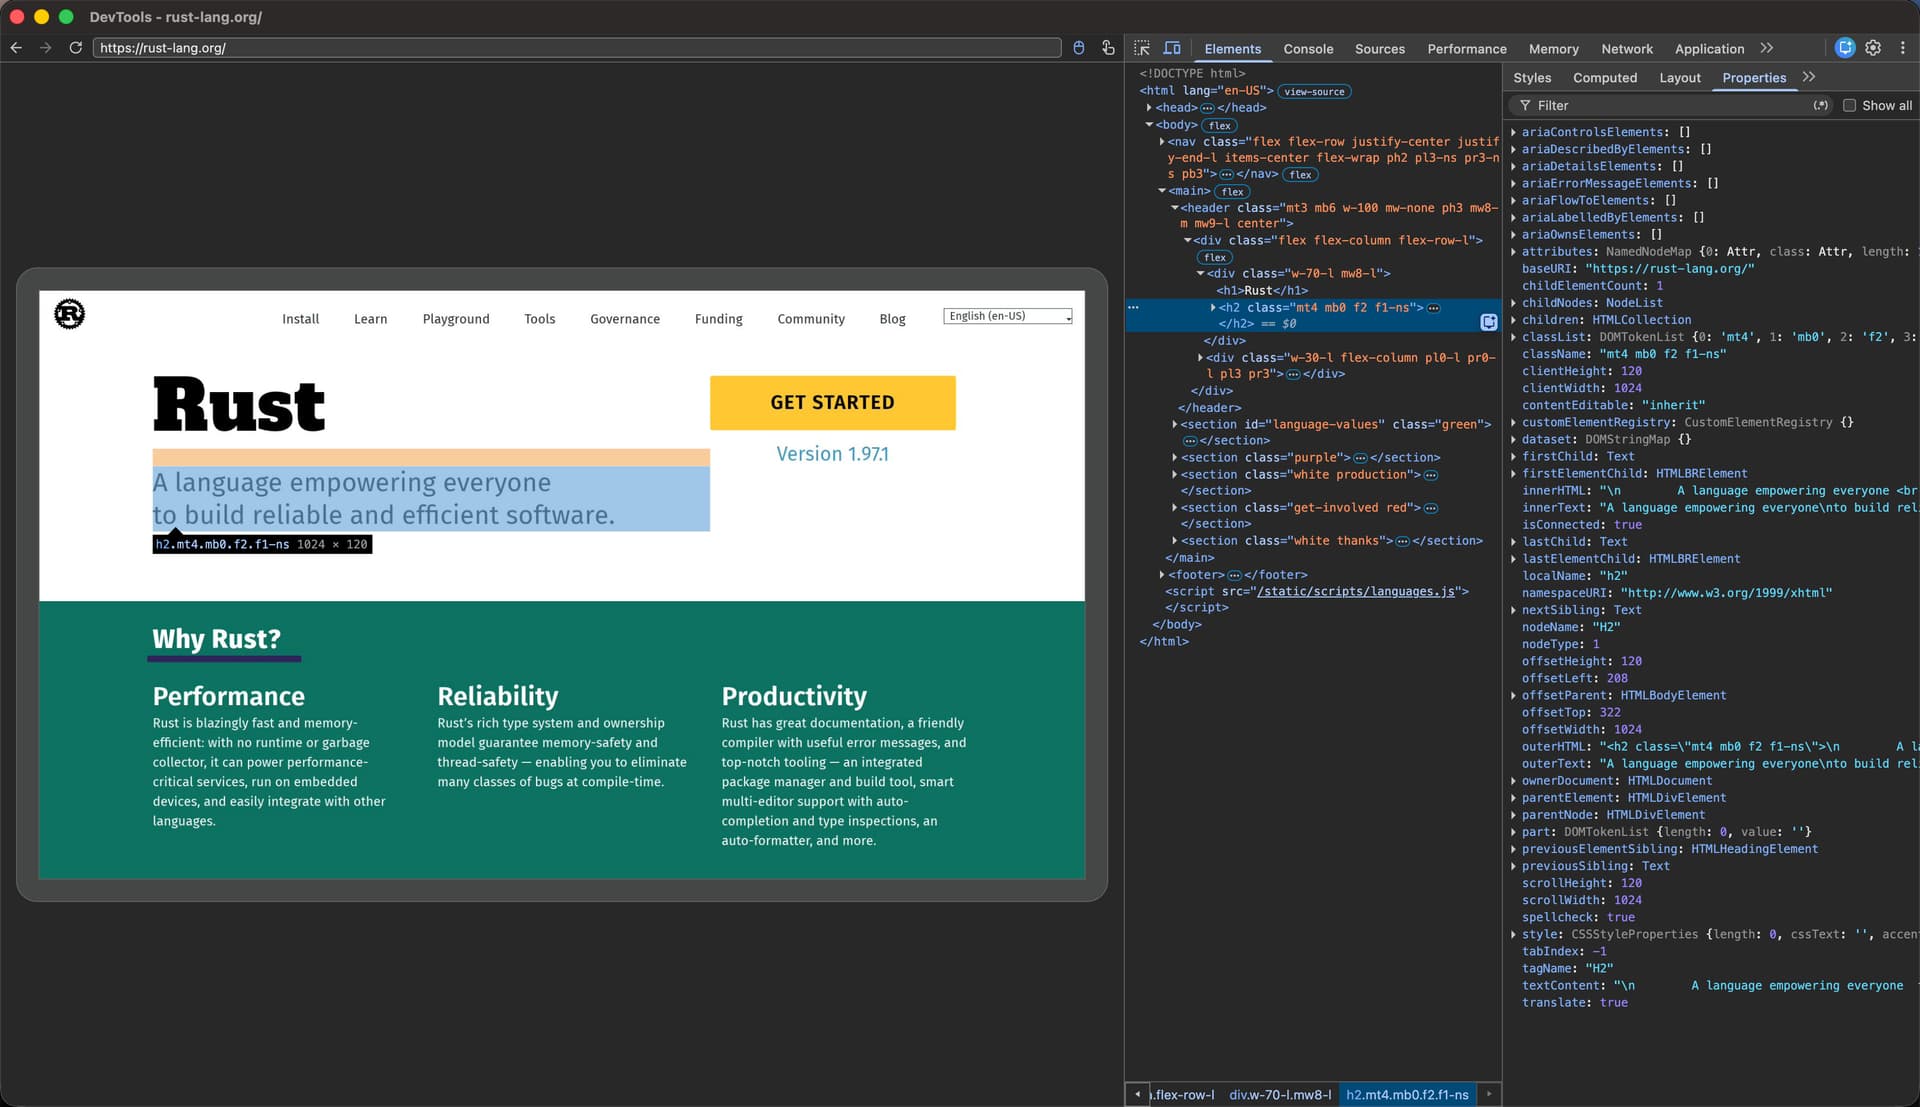
传统浏览器像一位拿着画笔的画家:你要问它「这页正文是什么」,它先把整幅画完整画出来,再从画布上辨认文字。Moli 像一位结构工程师:你问「这页正文是什么」,它直接读蓝图;但当你说「给我一张截图」时,它才临时搭起脚手架、算一遍结构、渲一帧,然后把脚手架拆掉,只保留最新那张冻结的布局快照。
官方管这个叫 LayoutPolicy::Mock / OnDemand 两种模式:默认走 Mock(不做真实布局与绘制),加 --layout 才开启真实布局、命中测试、坐标输入和截图;--resource 才额外拉取图片、字体、音视频等可选资源族。所有昂贵操作都需要显式开启,从不默认触发。
从代码看,这不是一个「小而美」的 demo,而是一个真正的浏览器内核工程:
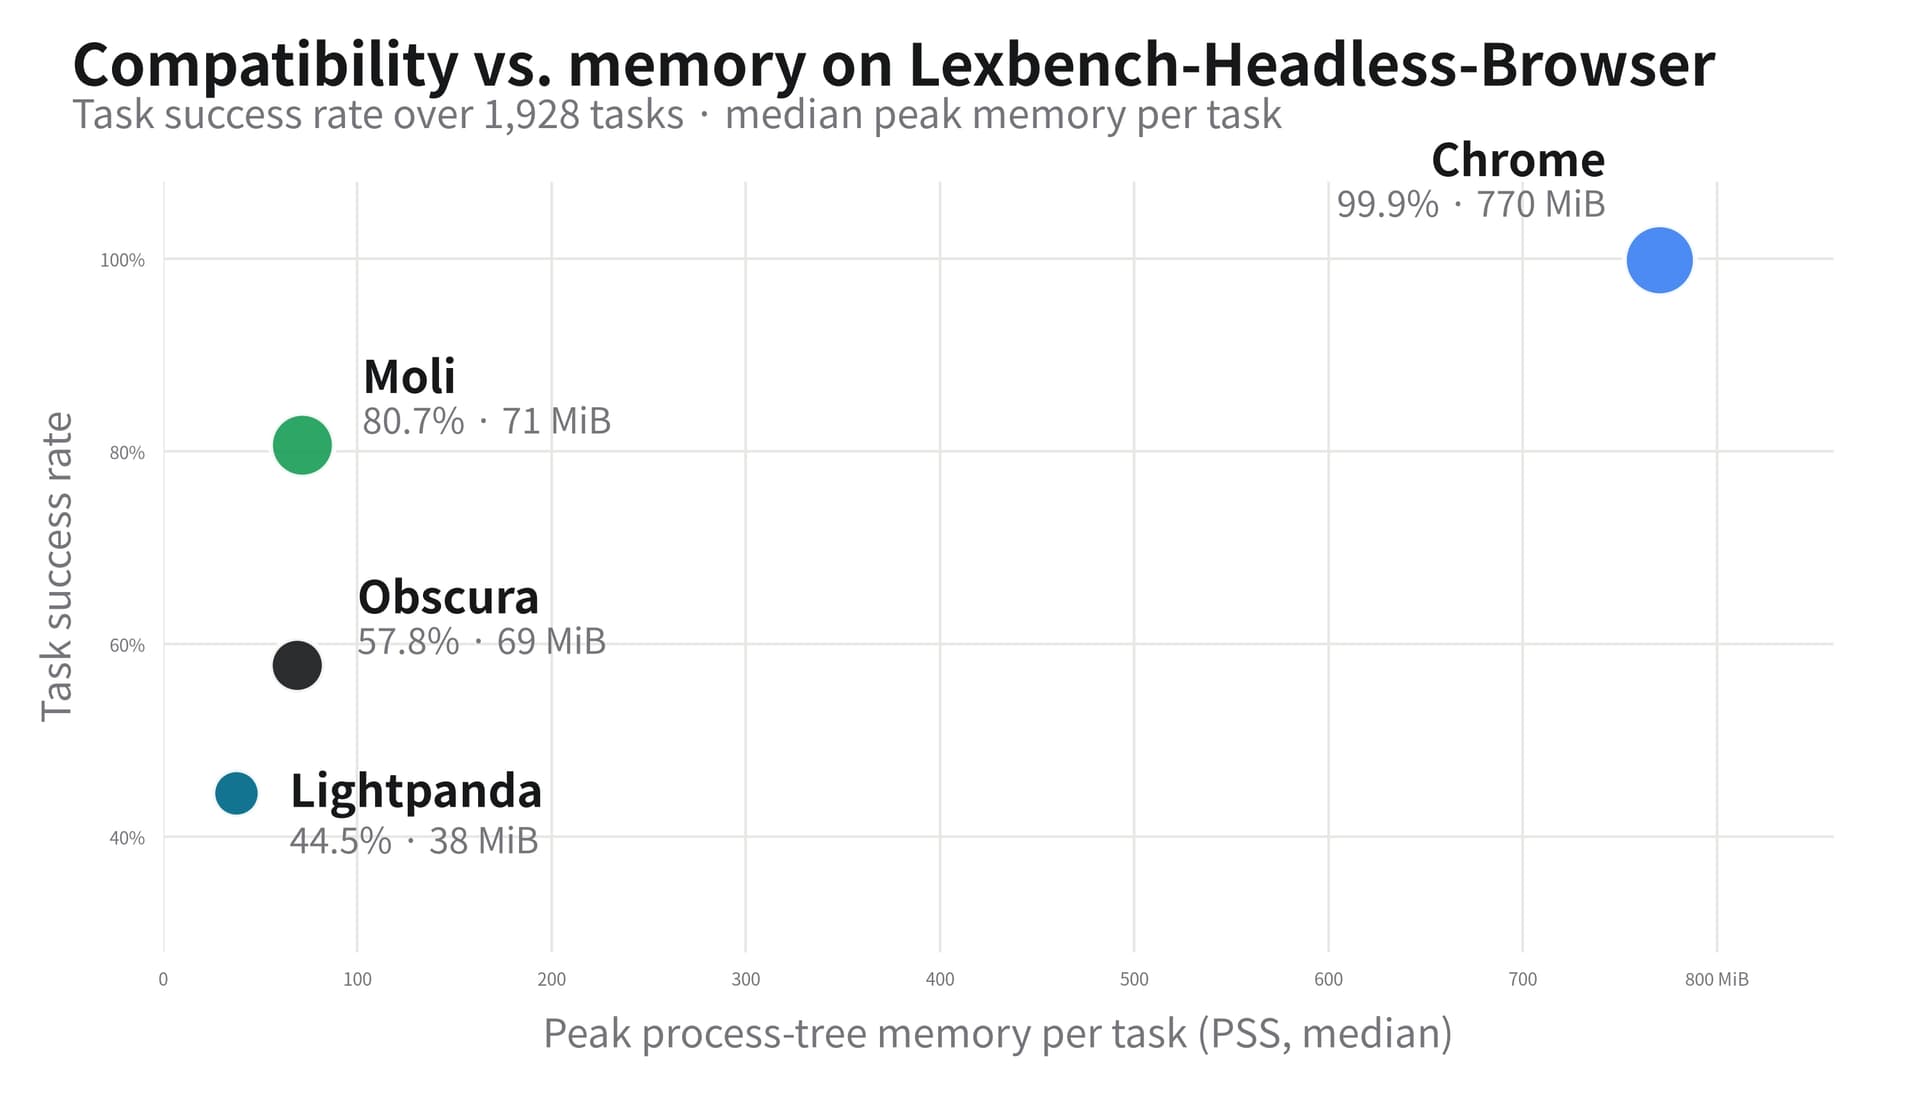
connectOverCDP 接上,Selenium 也不用另外装 chromedriver——这正是当前 agent 生态最痛的兼容性摩擦点。moli fetch --dump 可直接吐出 HTML、Markdown、JSON、语义文本树(semantic_tree_text) 和帧感知序列化。语义树是给大模型吃的——比裸 HTML 干净得多,能显著省 token。moli-playground/webmcp,可以列出并调用网站原生暴露的 WebMCP 工具,附带订位、餐厅、披萨等演示。这一步很关键——浏览器开始从「被动抓取」走向「主动调用网页能力」。性能数据是它最拿得出手的部分。在 192 个真实站点(国内外主流站点混合)的抓取基准里,Moli 成功抓取 103 页(53.6%),Chrome Headless 是 101 页(52.6%),但中位常驻内存 73 MiB vs Chrome 的 773 MiB,相差一个数量级。单 Agent 工作负载场景下,CDP 就绪 34.85ms(Chrome 169.37ms),峰值 PSS 102 MiB(Chrome 349 MiB),进程/线程数 1/24(Chrome 11/123)。
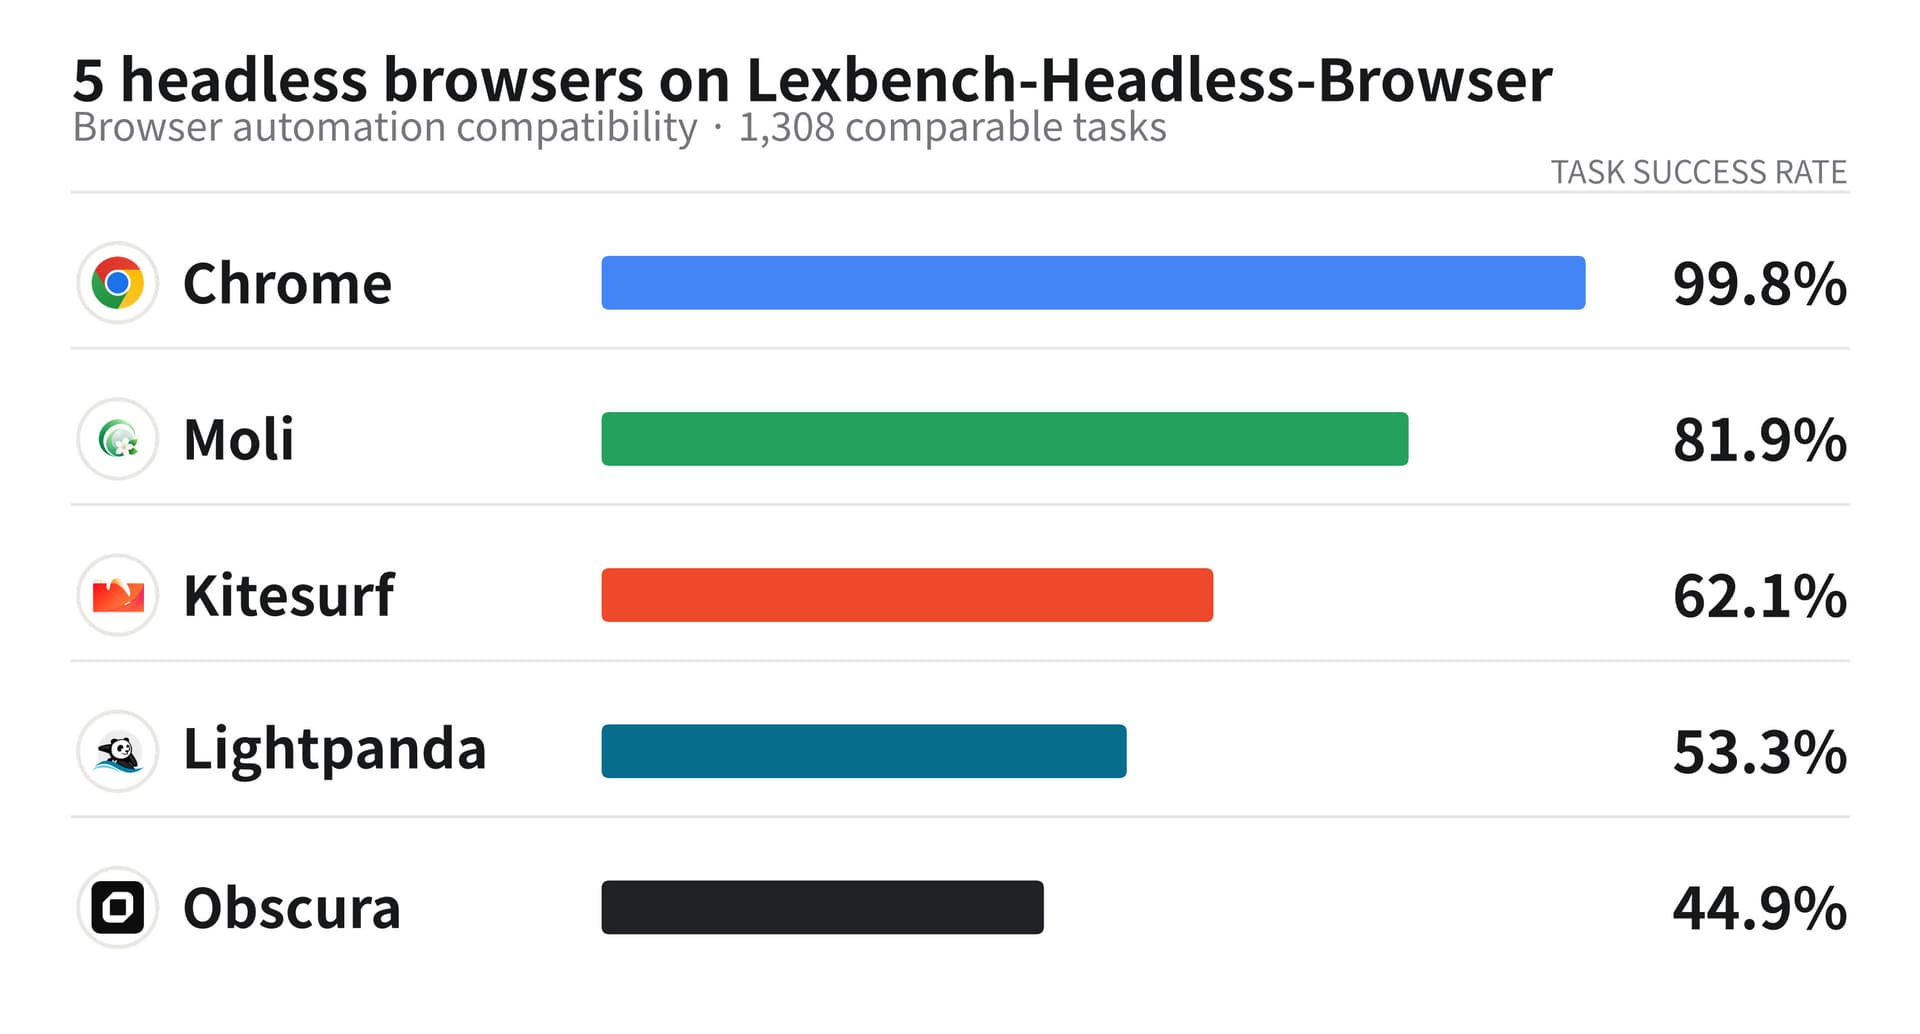
在作者自建的 Lexbench-Headless-Browser(1,928 个任务,含原始 CDP、Playwright、Puppeteer、Selenium 等 13 种工具及 Web 平台语义)上,Moli 0.1.1 通过 1,071 个任务,成功率 81.88%,明显领先 Kitesurf(62.08%,且为远程服务)、Lightpanda(53.29%)、Obscura(44.88%),Chrome 作为参考引擎为 99.85%。
另外,WPT(Web Platform Tests)全量跑通 161.2 万个测试,这说明兼容性问题不是靠「差不多就行」糊过去的。
最轻的用法是 CLI:
# Linux / macOS
curl --proto '=https' --tlsv1.2 -fsSL \
  https://github.com/lexmount/moli/releases/latest/download/moli-installer.sh | sh

moli fetch --dump markdown --wait-until done https://example.com
预编译二进制覆盖 x86_64/aarch64 的 Linux、macOS、Windows,不需要 Docker、不需要 Rust 工具链,装完即用。想要截图和 PDF 就加 --layout:
moli fetch --layout --dump screenshot_full https://example.com > full.png
进阶用法是起服务,一个端点同时暴露三套协议:
moli serve --layout
然后 Playwright 直接接管:
const browser = await chromium.connectOverCDP("http://127.0.0.1:9222");
对 AI Agent 框架用户,仓库还提供了三个现成 Skill:moli-webfetch(抓取/抽取/截图/PDF)、moli-websearch(搜索)、moli-cdp-server(起服务给自动化客户端连)。README 甚至贴了一段「直接把这段 prompt 丢给你的 Agent」的引导语——作者很清楚自己的用户是谁。
门槛的真正分水岭在源码编译:Cargo workspace 有 100+ 个 crate,还要 [patch.crates-io] 指向作者 fork 的 rust-openssl、parley、rust-url 等分支,加上 V8 的构建体量,从源码编译绝非一条命令的事。建议只走预编译二进制路线。
Moli 的 README 有一节叫「Project scope」,把限制写得非常坦白,这反而提升了可信度:
--layout 支持软件截图和原生 PDF(带字体嵌入),但并非所有 Chrome 的截图/打印模式都实现。其他值得留意的风险点:
--eval 允许执行任意页面脚本;cookie 文件以明文存于本地 profile 目录。对抓取不可信站点,需要自行做网络隔离。2026 年是「Agent 专用浏览器」元年。Chrome、Playwright、Puppeteer 是为「人看网页」设计的,Agent 用它们属于错配;Lightpanda、Obscura、Moli、Kitesurf 分别从不同角度切入这个空位。Moli 的差异化打法是不跟 Chrome 比像素,而比单位任务的 CPU/内存成本——在这个比法下,它用约 15% 的 CPU 时间和 13% 的峰值内存换来了接近 Chrome 的抓取成功率。
它的出现对整个 Agent 基础设施有三层意义:一是浏览器从「渲染器」变成了「工具服务」,CDP/WebDriver 三协议一统消除了客户端兼容成本;二是输出形态面向模型优化(语义树、Markdown 直出),把 LLM 上下文成本压了下来;三是WebMCP 让网页能力可被函数调用,浏览器从爬虫升级成了工具提供方。
对国内团队的现实建议:如果你的场景是高频、批量、以文本抽取为主的 Agent 抓取,Moli 值得立刻试——它的一键安装和 CLI 体验几乎没有学习成本,资源占用还能让你在单机上多跑 5 倍并发。但如果是强视觉交互、需要绕过风控、或要求像素级还原的自动化,Chromium 仍然是唯一稳妥选择。至于想深挖源码的团队,100+ crate 的 Rust 内核值得读,但请把它当成长期投入而不是季度方案。
一句话总结:Moli 用「结构优先、像素按需」的架构重构了无头浏览器的成本模型,为 AI Agent 提供了一个比 Chromium 轻一个数量级、协议兼容性又足够好的浏览器内核;它不是 Chromium 的替代品,而是 Agent 负载下的更优解。
