
langgraph-bigtool
langchain-ai/langgraph-bigtool加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你给团队做了一个客服智能体,它要能查订单、退款、改地址、发优惠券、查物流、生成报表……二十个接口接上去,你觉得很完备。结果上线第一天,模型开始胡说八道:把"退款"理解成"查退款进度",甚至调用了一个不存在的 refund_all_users。打开日志一看,模型一次调用就挂着 20 个工具定义,光工具描述就占了系统提示词三分之一的 token。更麻烦的是每加一个业务方,模型就退化一分。
问题的本质不是模型笨,而是把所有工具一次性塞进上下文是一种线性糟糕的架构。当工具数量从 20 涨到 500,模型的选择准确率不是缓慢下降,而是断崖式崩塌——token 超限、注意力被稀释、语义混淆。
langgraph-bigtool 给出的解法听起来朴素得有点反常识:别一次给完,让智能体自己按需去取。
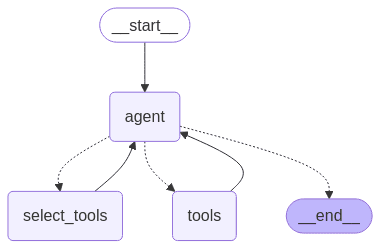
图:LangChain 官方仓库中的 BigTool 状态图——agent 节点只挂着一个 retrieve_tools 工具,检索到的具体工具才被动态绑定到模型上。
langgraph-bigtool 是 LangChain 官方在 2025 年 3 月开源的一个 Python 库(MIT 协议,目前 559 star、48 fork),顾名思义就是"给 LangGraph 用的 BigTool"。它的核心机制有三层:
第一层:工具注册表而非工具列表。 你不再把工具塞进 llm.bind_tools([...]),而是交给它一个 tool_registry——一个 {id: tool} 的字典,工具可以是几百上千个。
第二层:借力 LangGraph 的长期记忆 Store 做语义检索。 你把每个工具的名称和描述写进 store.put(("tools",), tool_id, {...}),Store 底层可以接语义索引(比如 InMemoryStore + OpenAI embeddings,或者 Postgres 持久化后端)。智能体拿到用户问题后,用这个查询去 Store 里做向量检索,只取回 top-k 个工具(默认 limit=2)。
第三层:动态绑定与循环。 状态图里 agent 节点起初只绑定一个 retrieve_tools 工具。模型发现"我需要算弧度",于是调用 retrieve_tools(query="arc cosine calculation");select_tools 节点执行检索,把命中的 acos 等工具追加进 selected_tool_ids 状态;下一轮 agent 节点才把 retrieve_tools + 命中的工具一起绑给模型。模型随后才真正调用 acos。
看源码你会发现两个精心设计的细节:State 用 Annotated[list[str], _add_new] 定义了一个去重累加器,保证多轮检索的工具不会重复堆积;should_continue 条件边用 Send 做动态分发,retrieve_tools 调用走向 select_tools,其他工具调用直接走向 tools 节点——这让"检索工具"和"执行工具"在图上是两条清晰的路径。
传统做法像是把整个工具仓库的说明书糊在模型脸上:扳手、电钻、焊枪、螺丝刀……两页纸看完,它能记住的只有前三样。
BigTool 的做法更像图书馆:模型只拿到一张借阅卡。它想修水管,就去检索"水管"相关的书目,借出扳手;想钻墙洞,就换一本目录。书架(Store)由你维护,取书规则(检索函数)由你定义。
而且这个"取书规则"完全可以自定义。你传入 retrieve_tools_function,就能实现任意逻辑——比如按业务线分类返回(Literal["billing", "service"]),根本不用向量检索。README 里明确展示了这条路径。
这是本次分析中最需要说清楚的部分:它是一个库,不是一个应用。
pip install langgraph-bigtool
严格来说只要一行 pip 命令。难点在于三处:
langgraph>=0.3.0,如果你的项目还在裸用 LangChain Agent API,得先迁移到 LangGraph。init_embeddings("openai:text-embedding-3-small"),也就是要一个 OpenAI API Key 和相应费用。不想付这个钱,就得自己实现 retrieve_tools_function 走关键词/分类逻辑。InMemoryStore 进程一退就没了;生产环境需要接 PostgresStore,那意味着你要额外维护一张 Postgres 表。跑通官方 Quickstart 需要 OPENAI_API_KEY。它没有 CLI、没有 Web UI、没有 Docker 镜像、没有任何守护进程——所有交互都发生在 Python 进程内,通过 agent.stream(...) 逐轮打印 messages。
没有 Web UI、没有容器编排,所以它的部署成本几乎为零,但也意味着它无法被"一键部署"评估。 它是被 import 进你已有服务的。
诚实地说,这个项目有几个需要留意的点:
0.0.3。 距离 2025 年 3 月首发已一年多,版本号几乎没动,说明项目已进入低维护状态。仓库最后一次提交是 2026 年 10 月的依赖升级(dependabot 自动 PR),不是功能性开发。社区贡献者也仅 4 人(其中 1 个是机器人),实际维护者主要是 LangChain 团队的 ccurme。limit=2 的默认值偏保守。 复杂任务往往需要组合多个工具,默认只取 2 个可能不够。_inject_tool_args、tool_node._inject_tool_args 这类下划线前缀的内部属性,说明它对 LangGraph 版本比较敏感——LangGraph 大版本升级有可能直接把它打断。math 库的 50 个函数,对于演示很友好,但离真实的数百工具场景还有距离。BigTool 折射出 Agent 架构的一次集体转向:从"堆上下文"到"按需检索"。
2023–2024 年,Function Calling 的普及让"给模型更多工具"变成一种时髦做法,随即撞上两个硬墙——上下文窗口和选择准确率。2025 年起,学术界和工业界开始系统性地研究工具检索:Toolshed(arXiv:2410.14594)用 RAG 融合工具知识库,Graph RAG-Tool Fusion(arXiv:2502.07223)引入图结构做工具关联,OpenAI 的 function calling 生态、Hugging Face 的 MCP 生态都在往同一个方向收敛。
LangChain 把这条路线做成了官方库,本身就是一个强信号:工具数量从"个位数"增长到"数百个"正在成为常态。企业级 Agent 要接的不只是自己公司的 API,还有 ERP、CRM、工单、监控、数据库——每个域几十个工具,叠加几百个是必然。当 MCP 让工具接入成本趋近于零,工具注册表的规模只会继续膨胀,而"动态检索"就会从优化项变成必需项。
有意思的是,这个库至今只有 559 star——相比 LangGraph 主仓库的数万 star,几乎无人问津。架构上的正确,不代表生态上的胜利。 当你可以直接用 LangGraph 自己的 Store + 几行代码手搓同样的循环时,为什么还要多装一个依赖?这可能是这个项目最值得玩味的地方。
| 维度 | 评价 |
|---|---|
| 定位 | LangGraph 官方扩展库,解决"工具太多导致模型退化"问题 |
| 核心机制 | Store 语义检索 + 动态工具绑定 + ReAct 循环 |
| 部署难度 | 极低(纯 pip 依赖),但无 Web UI、无 Docker、非独立应用 |
| 硬件需求 | 无 GPU 要求,纯 CPU 内存占用极小 |
| 代码质量 | 优秀(ruff + mypy 严格模式、单元/集成测试分离、pytest-socket 禁网) |
| 文档质量 | 良好(README 结构清晰,含可运行示例与学术引用) |
| 维护活跃度 | 低(v0.0.3,约 63 次提交,4 名贡献者) |
| 适合场景 | 已有 LangGraph 应用、工具数量上百、需要持久化检索的团队 |
| 不适合场景 | 工具数量少于 30、无 LangGraph 基础、不愿承担 Embedding 成本的场景 |
