
Agent-Fusion
krokozyab/Agent-Fusion加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
假设你正在开发一个电商后端,让 AI Agent 帮忙添加「用户下单后自动扣减库存」的逻辑。Agent 翻遍了项目,告诉你「找不到库存相关的代码」。
实际情况呢?你的 StockManager.kt 里有 decrementInventory() 方法,OrderController.kt 里有完整的下单流程,InventoryException.kt 定义了库存不足的异常处理——代码都在,但 Agent 只会用 grep 「库存」的方式搜索。而「库存」在代码里被写成了 stock、quantity、availableUnits,Agent 翻来覆去找不到。
这就是 AI Coding Agent 的 语义鸿沟问题:Agent 理解关键词,但代码天然充满同义词、多态和抽象层级。传统 grep 式的搜索,无法跨越这个语义鸿沟。
Agent Fusion 解决的就是这个问题——它让 AI Agent 拥有「理解代码含义」的能力,而不只是匹配文字。
Agent Fusion 是一个本地运行的 RAG(检索增强生成)语义搜索引擎,专为 AI Coding Agent 设计。它的核心思想很简单:把代码仓库构建成知识图谱,让 Agent 用自然语言检索真实存在的代码片段,而不是靠「猜」生成幻觉代码。
项目的发起背景直指痛点:当你同时使用多个 AI Coding Agent(如 Claude Code、Gemini Code Assist、AWS Q Developer)时,每个 Agent 都有各自的上下文窗口限制和代码理解盲区。Agent Fusion 作为 MCP(Model Context Protocol)工具,插入到 Agent 的工作流中,当 Agent 需要了解项目代码时,通过 query_context 语义查询,实时返回准确的代码块和依赖关系。
该项目由独立开发者 krokozyab 创建,采用 MIT 许可证,100% 本地运行,无需任何外部 API 或云服务。
 图 1:Agent Fusion 项目横幅,展示 MCP Context Engine 在多 Agent 协作中的角色
Agent Fusion 由两个相互独立的核心组件构成,可以单独使用,也可以组合使用。
这是项目的核心功能,通过三层检索策略将代码转化为可检索的知识:
第一层:语义搜索(Semantic Search)
基于 sentence-transformers 类型的 embedding 模型将代码片段向量化。系统内置了轻量级的 all-MiniLM-L6-v2 ONNX 模型(384 维),也支持替换为更高质量的 baai-bge-base-en-v1.5(768 维)。搜索「用户认证逻辑」能找到所有包含登录验证、Token 校验、会话管理的代码——即使这些代码里从未出现「用户认证」这个短语。
第二层:符号搜索(Symbol Search) 通过标识符匹配(identifier matching),查找函数名、类名、变量名直接相关的代码块。这对于「找到某个特定函数的实现」这类精确需求非常有效。
第三层:全文搜索(Full-Text Search) 基于关键词的快速匹配,与语义搜索形成互补,兜底极端情况。
三层检索结果通过相关性评分统一排序,取最优匹配。
知识图谱构建 Context Engine 不仅做检索,还会构建代码的层级关系图谱。每个代码块(chunk)都记录了父子关系(parent/children)、兄弟关系(siblings)以及前后相邻关系(prev/next)。Agent 可以检索到目标代码块后,顺着图谱追踪到整个类结构、调用链或文档组织。
文件监控与自动索引
通过 TOML 配置指定 watch_paths,系统会监控目录变化,自动重新索引有变更的文件。用户无需手动刷新索引,代码改了,索引自动更新。
多格式文档支持 不只支持代码文件,还支持 Word 文档(.docx)、PDF 和 Markdown 格式文档的语义索引。通过 Apache POI 处理 Word/PDF,chunking 策略可配置。
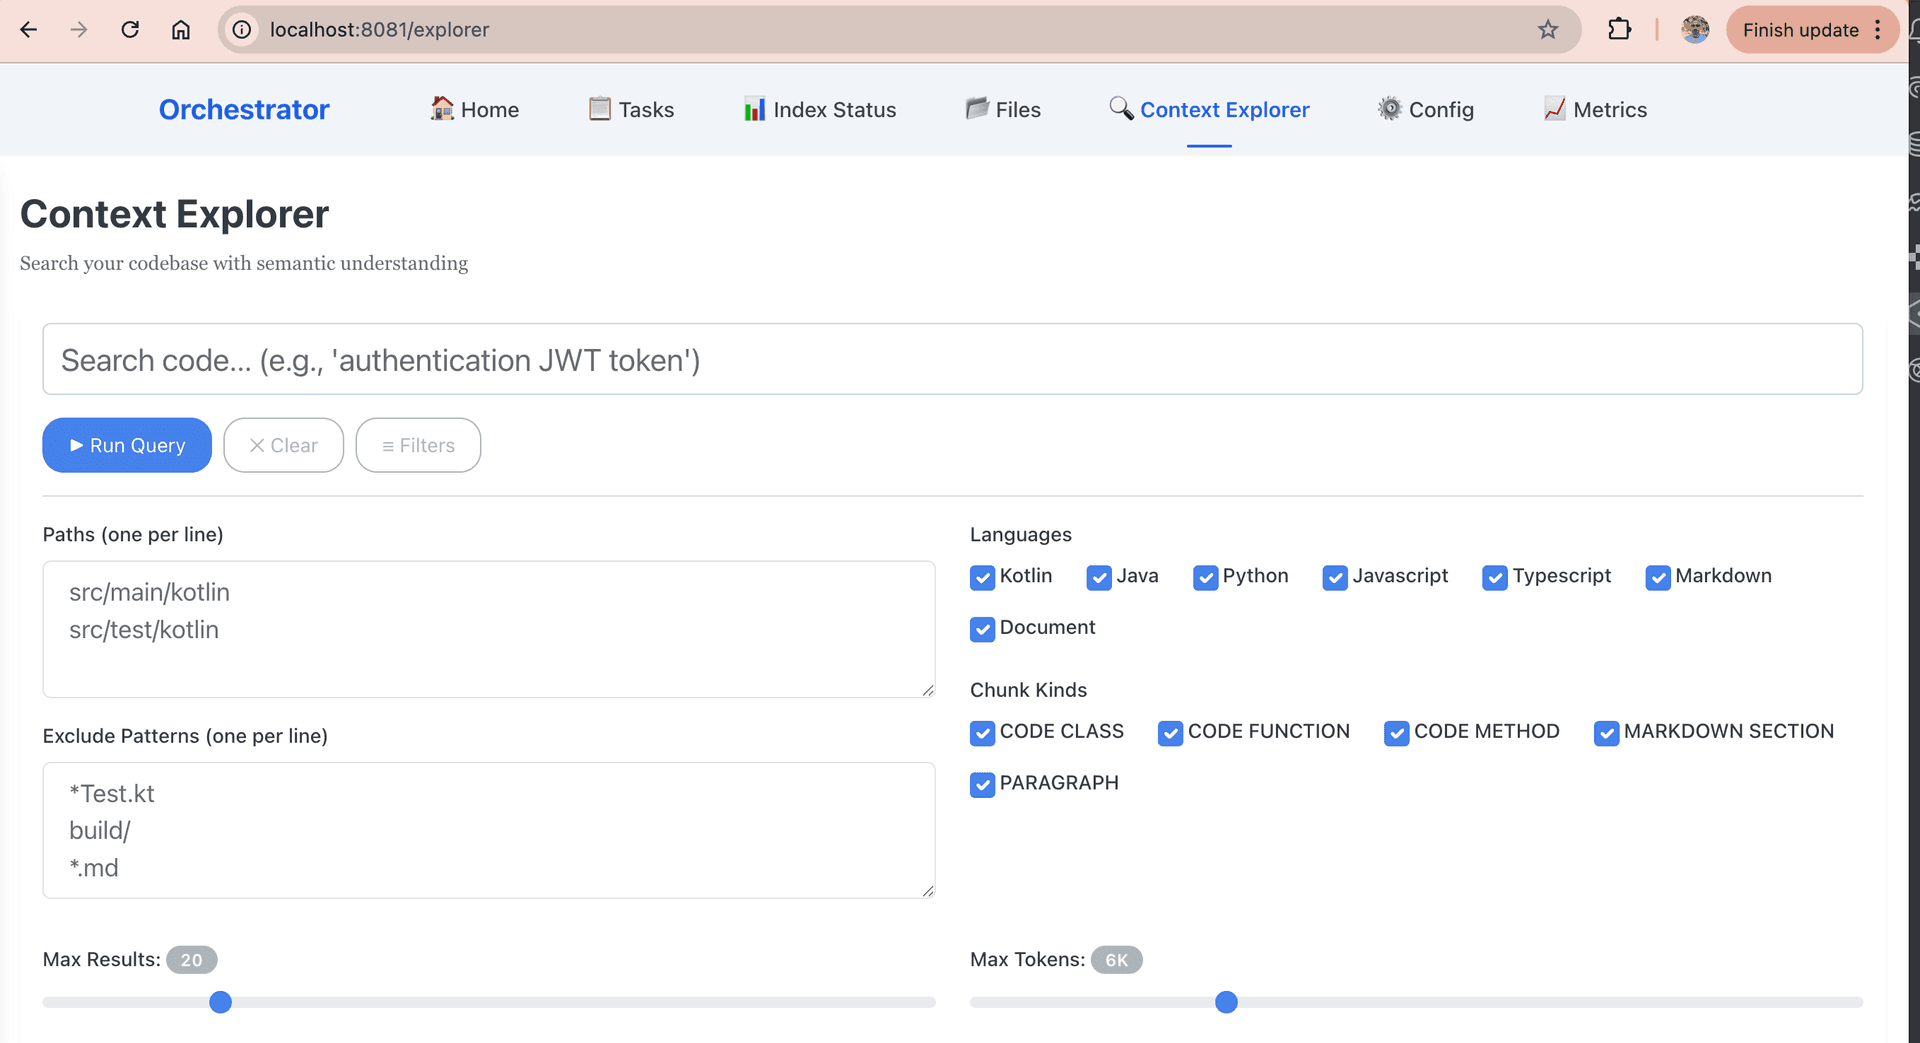 图 2:Context Explorer 界面,展示知识图谱中代码块的层级关系
可选组件,用于协调多个 AI Agent 的工作:
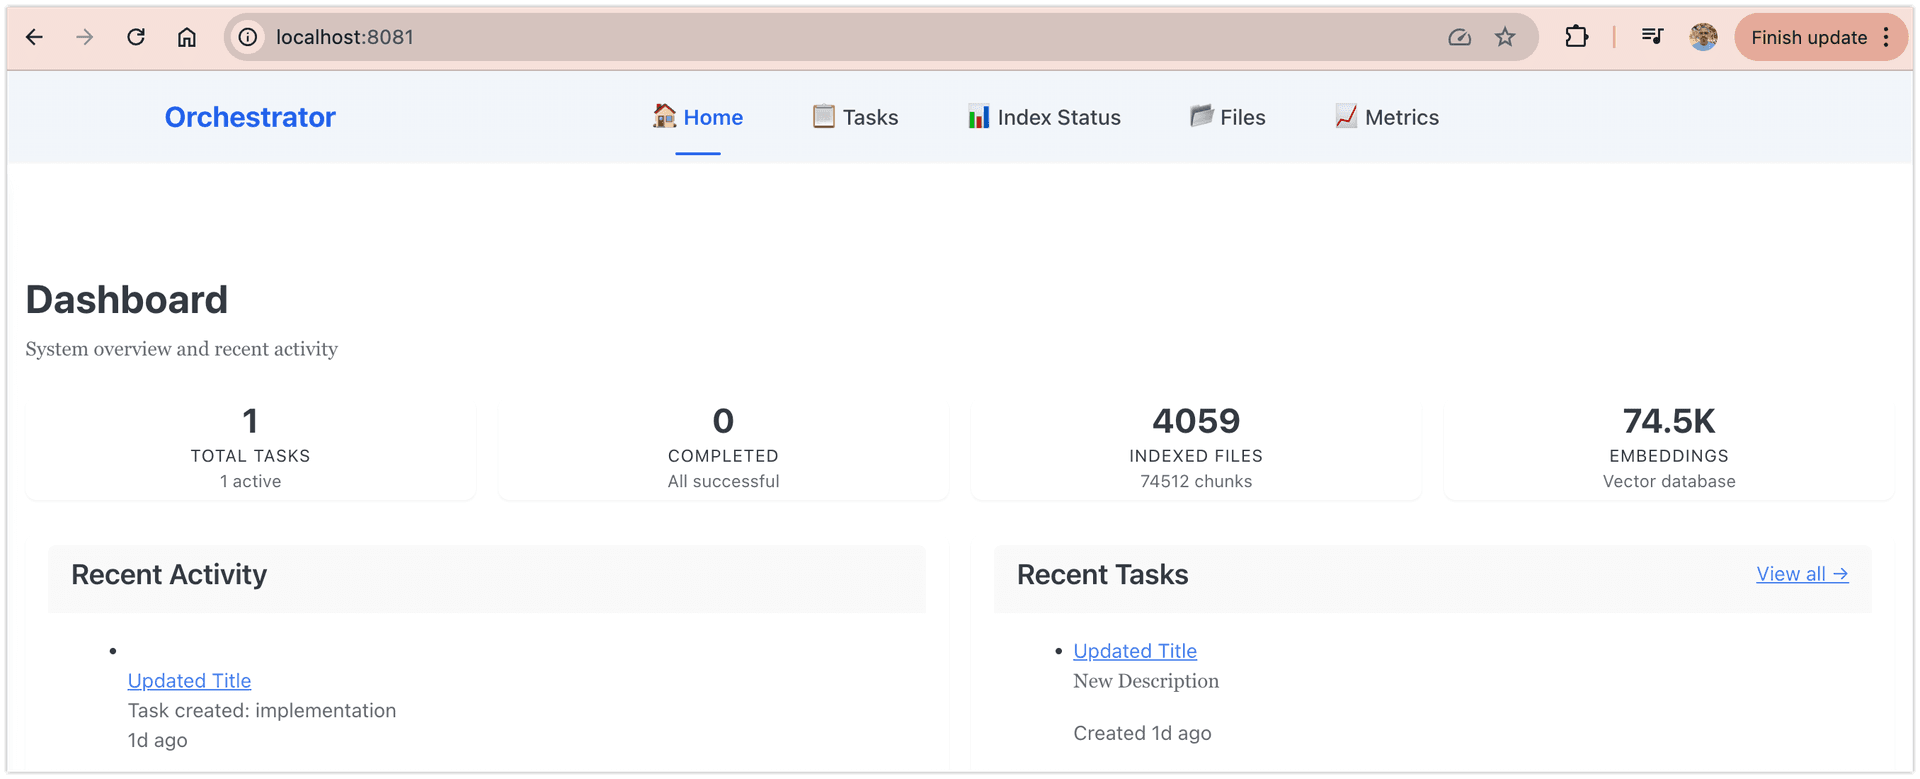 图 3:Task Manager Web Dashboard,实时追踪多 Agent 任务状态
| 层级 | 技术选型 | 说明 |
|---|---|---|
| 核心语言 | Kotlin 2.2.10 | JVM 生态,优雅的协程支持 |
| Web 框架 | Ktor 3.3.0 | 轻量异步 Web 框架(Netty 引擎) |
| 向量数据库 | DuckDB | 本地嵌入式列式数据库,零部署 |
| ONNX 推理 | onnxruntime 1.16.3 | CPU 运行 embedding 模型,无需 GPU |
| MCP 协议 | Model Context Protocol Kotlin SDK | 标准化 Agent ↔ 工具通信 |
| 代码解析 | tree-sitter + javaparser | AST 级 chunking,支持 8 种主流语言 |
| 文档处理 | Apache POI + PDFBox | Word/PDF 解析 |
| Git 集成 | JGit | 搜索 git 历史中的代码变更 |
整个系统打包为单一 fat JAR(orchestrator-0.1.0-all.jar),包含所有依赖,部署极简。
Agent Fusion 的部署体验设计得非常克制——不需要 Docker,不需要 Python 环境,不需要云账号。
部署前提:只需要 Java 21。
部署步骤:
build/libs/orchestrator-0.1.0-all.jar)fusionagent.toml(指定要索引的目录和文件类型)./start.sh启动检查流程:
start.sh 会依次检查 Java 环境 → 配置文件是否存在 → JAR 文件是否存在,全部通过后启动服务。彩色输出直观展示检查结果。
访问入口:
http://127.0.0.1:3000http://localhost:8082文件结构:
orchestrator-0.1.0-all.jar   # 唯一可执行文件
fusionagent.toml              # 唯一配置文件
context.duckdb               # 索引数据库(自动生成)
data/models/                  # 自定义 embedding 模型(可选)
注意事项:
127.0.0.1,无认证保护,仅限本机访问。如需局域网访问,需自行加访问控制xattr -d com.apple.quarantine 解除隔离用户(开发者)不需要直接操作 Agent Fusion,核心交互发生在 AI Agent 层面:
query_context 工具搜索 X」query_context,传入自然语言查询(如「找到所有涉及数据库连接的代码」)整个过程对开发者透明——你只需要告诉 Agent「遇到代码问题时用 query_context」,剩下的由 Agent 自己完成。
embedding 模型(即使是轻量的 all-MiniLM-L6-v2)在处理大型代码仓库时,索引和检索速度都受限于 CPU 性能。官方文档建议对大型仓库升级到更强 embedding 模型,但这会进一步降低速度。
fat JAR 包含完整的 ONNX Runtime 和所有解析库,首次启动需要数秒到十几秒的初始化时间。文档和评测中未提及预热机制,每次重启都有冷启动开销。
tree-sitter 支持 8 种主流语言(Java、Python、Go、TypeScript、JavaScript、C#、Kotlin),但对其他语言仅靠文件扩展名判断,无法做 AST 级 chunking,语义检索质量会下降。
Task Manager 的投票机制在实践中可能遇到 Agent 之间立场差异过大的问题,目前文档中关于冲突仲裁的策略描述较少,实际效果有待验证。
项目强依赖 MCP 协议,只能用于支持 MCP 的 AI Agent(主要是 Claude 系列和新兴的 MCP 兼容 Agent)。对于使用 OpenAI Codex API 或其他非 MCP 协议的 Agent,需要额外适配层。
2025 年,AI Coding Agent 已经能够完成从代码补全到重构的多种任务,但「幻觉」——生成不存在 API、引用错误文件——仍是阻碍 Agent 在生产环境落地的最大障碍。
Agent Fusion 代表了一条务实的解决路线:与其让模型「记住更多」,不如在需要时「精准检索」。RAG 范式在 LLM 文本生成领域已被验证有效,Agent Fusion 将这一范式引入代码理解和 Agent 协作领域。
从增长曲线看,该项目 Star 增速与 MCP 生态的扩张高度相关。随着 Claude Code、Gemini 等 MCP Native Agent 的普及,需要本地知识检索的场景会持续增长。
代表趋势:
对于追求 AI Agent 生产级可靠性的团队,Agent Fusion 是一个值得关注的技术选型——它不追求大模型参数竞赛,而是专注于「让 Agent 检索到真实存在的代码」,这个定位足够清晰,解决的问题也足够具体。
