
adk-mcp-rag
khoi03/adk-mcp-rag加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
用过 ChatGPT 的朋友大概都遇到过这种情况:你问一个专业领域的问题,AI 信心满满地给出一个答案,但仔细一看——数据是编的,引用是假的,一本正经地胡说八道。这不是 AI "不聪明",而是它本身就"没有知识",它只是在拟合语言概率。
RAG(检索增强生成)就是为了解决这个问题而生的。简单来说:RAG 就像给 AI 配了一个随时可查的资料库。用户提问时,系统先从资料库中检索相关片段,再把这些"有据可查"的内容塞给 AI 作为上下文——AI 不再凭空发挥,而是"看着答案回答"。
但是,传统的 RAG 系统有一个痛点:向量数据库的查询逻辑和 AI Agent 的工具调用是割裂的。你需要在代码里手动写"先查向量库、再把结果塞给 prompt"这段胶水代码,既不优雅,也不好维护。
khoi03/adk-mcp-rag 这个项目给出了一个新的解决思路:让向量数据库以 MCP Server(Model Context Protocol Server) 的身份,成为 AI Agent 的一种原生工具。
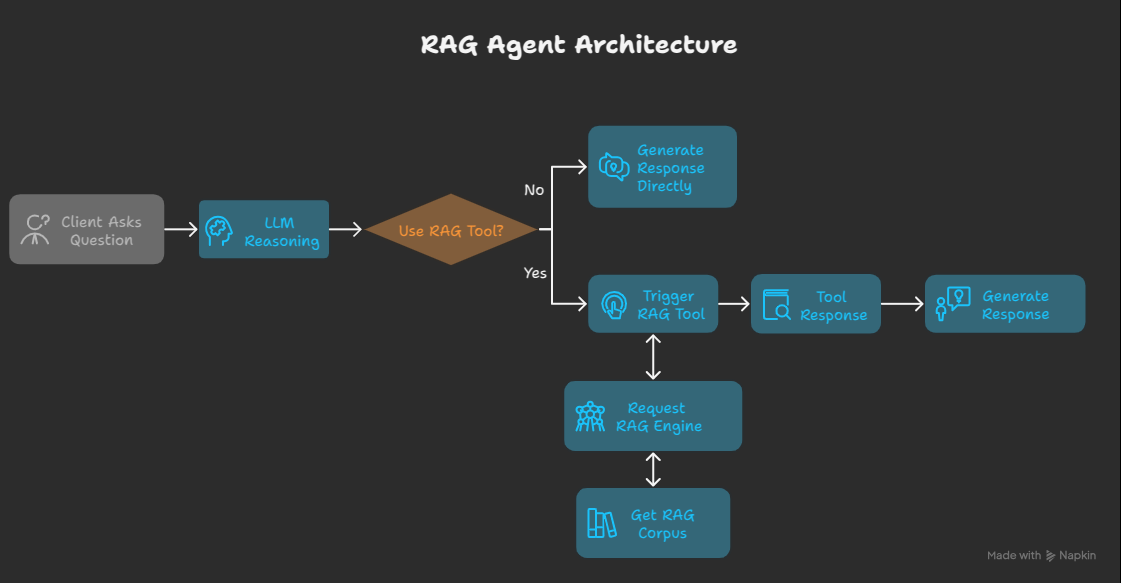
图注:RAG Agent 整体架构,展示了用户请求 → Google ADK Agent → MCP Tool → Qdrant 向量库 → 检索结果回流的全流程。
Google Agent Development Kit(ADK)是 Google 官方在 2025 年初推出的 AI Agent 开发框架。相比 LangChain、Hays 等老牌框架,ADK 的核心设计理念是简化 Agent 的构建流程,让开发者聚焦于"定义 Agent 的行为"而不是"管理 Agent 的生命周期"。
ADK 的几个关键概念:
ADK 还自带一个 Web UI 调试工具(adk web),可以实时看到 Agent 的思考过程、工具调用和中间结果,极大降低了开发调试成本。
MCP(Model Context Protocol)是 Anthropic 在 2024 年底开源的一种标准化协议,用于规范 AI Agent 如何与外部工具和数据源交互。在 MCP 出现之前,AI Agent 连接外部工具需要为每个工具单独写适配代码;有了 MCP,只需要实现一次 MCP Server,任何兼容 MCP 的 Agent 都能调用它。
打个比方:MCP 就像是 AI 世界的"USB 接口标准"——不再需要为每个设备定制线缆,插上就能用。
mcp-server-qdrant 就是一个将 Qdrant 向量数据库暴露为 MCP 工具的 Server。它对外暴露的核心工具是 qdrant-find:Agent 发送查询请求,Qdrant 在向量空间中找到最相似的文档片段,返回给 Agent 作为上下文。
adk-mcp-rag 的代码组织非常清晰,可以分为三层:
# 通过 Google ADK Runner 启动 Agent
runner = Runner(
    app_name='mcp_filesystem_app',
    agent=root_agent,
    artifact_service=artifacts_service,
    session_service=session_service,
)
主程序负责初始化 ADK Runner 和 Session Service,然后启动异步运行循环。用户的查询通过 Content 对象传递给 Agent,最终以 SSE 流式响应输出。
# 通过 MCPToolset 将 Qdrant 暴露为 Agent 工具
toolset = await self.mcp_tools.get_tools_async(os.getenv('QRANT_MCP_SSE'))
root_agent = LlmAgent(
    model='gemini-2.0-flash',
    name='ask_rag_agent',
    instruction=self.prompt_configs['ask_rag_agent']['instruction_prompt'],
    tools=[toolset],
    generate_content_config=types.GenerateContentConfig(temperature=0.2),
)
Agent 的 prompt 在 agents/config/prompts.yml 中定义。prompt 明确指示 Agent:"只在用户提出需要知识库支撑的问题时才调用检索工具,回答要有引用来源"。这是一个很实用的设计——日常闲聊不触发检索,既节省 API 调用,也避免无关信息干扰。
# 文档向量化入库
loader = DirectoryLoader("data")
splitter = RecursiveCharacterTextSplitter(chunk_size=500, chunk_overlap=50)
chunks = splitter.split_documents(docs)

db = VectorDB(embeddings_model_name="sentence-transformers/all-MiniLM-L6-v2")
db.add_documents(chunks)
文档入库存取使用 LangChain 的文档加载器(支持 PDF 和 Markdown),文本分割采用 RecursiveCharacterTextSplitter(按段落语义切分),向量嵌入模型默认使用 all-MiniLM-L6-v2(轻量高效,384 维向量)。
这个项目在部署体验上做得很用心。docker/ 目录下提供了完整的 Docker Compose 配置,一行命令启动全套服务:
docker compose -p qdrant-mcp up --build -d
启动后实际运行两个容器:
mcp-server-qdrant 包暴露 Qdrant 的 SSE 端点(8888 端口)主程序通过 QRANT_MCP_SSE=http://localhost:8888/sse 环境变量连接 MCP Server。整个链路无需手动配置 IP 或端口,网络名统一为 mcp-servers Docker 网络。
shibing624/text2vec-base-chinese 等中文 embedding 模型。adk-mcp-rag 是一个将 Google ADK、MCP 协议和 Qdrant 向量库三者深度融合的 RAG 实现。它代表了一个趋势:未来 AI Agent 将通过标准协议(如 MCP)原生调用外部工具,而不是在业务代码里写胶水逻辑。对于想了解 Agentic RAG 架构、以及如何用 MCP 协议构建生产级 RAG 系统的开发者,这个项目是一个值得参考的范本。
