
nn-zero-to-hero
karpathy/nn-zero-to-hero加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下 2026 年的某个周一,一个开发者在工位上打开 Jupyter,第一次看到自己写的 20 行代码让一个字符级语言模型学会了生成名字。他可能会想:这背后的反向传播到底是谁教出来的?答案常常是同一个——Andrej Karpathy。
Karpathy 是前特斯拉 AI 总监、OpenAI 创始成员,也是深度学习领域最具影响力的布道者之一。他的博客订阅者以万计,每篇文章都在做同一件事:把复杂的机器学习概念翻译成人话。但真正让他影响力封神的是一门公开课——Neural Networks: Zero to Hero。
这门课最反直觉的地方在于它的起点。不是从 PyTorch 的一行 model.fit() 开始,也不是从 Transformer 论文的公式开始,而是从手写一个自动微分引擎开始。你得自己实现反向传播,自己手写梯度,自己在只有标量(单个数字)的世界里体会链式法则到底在链什么。
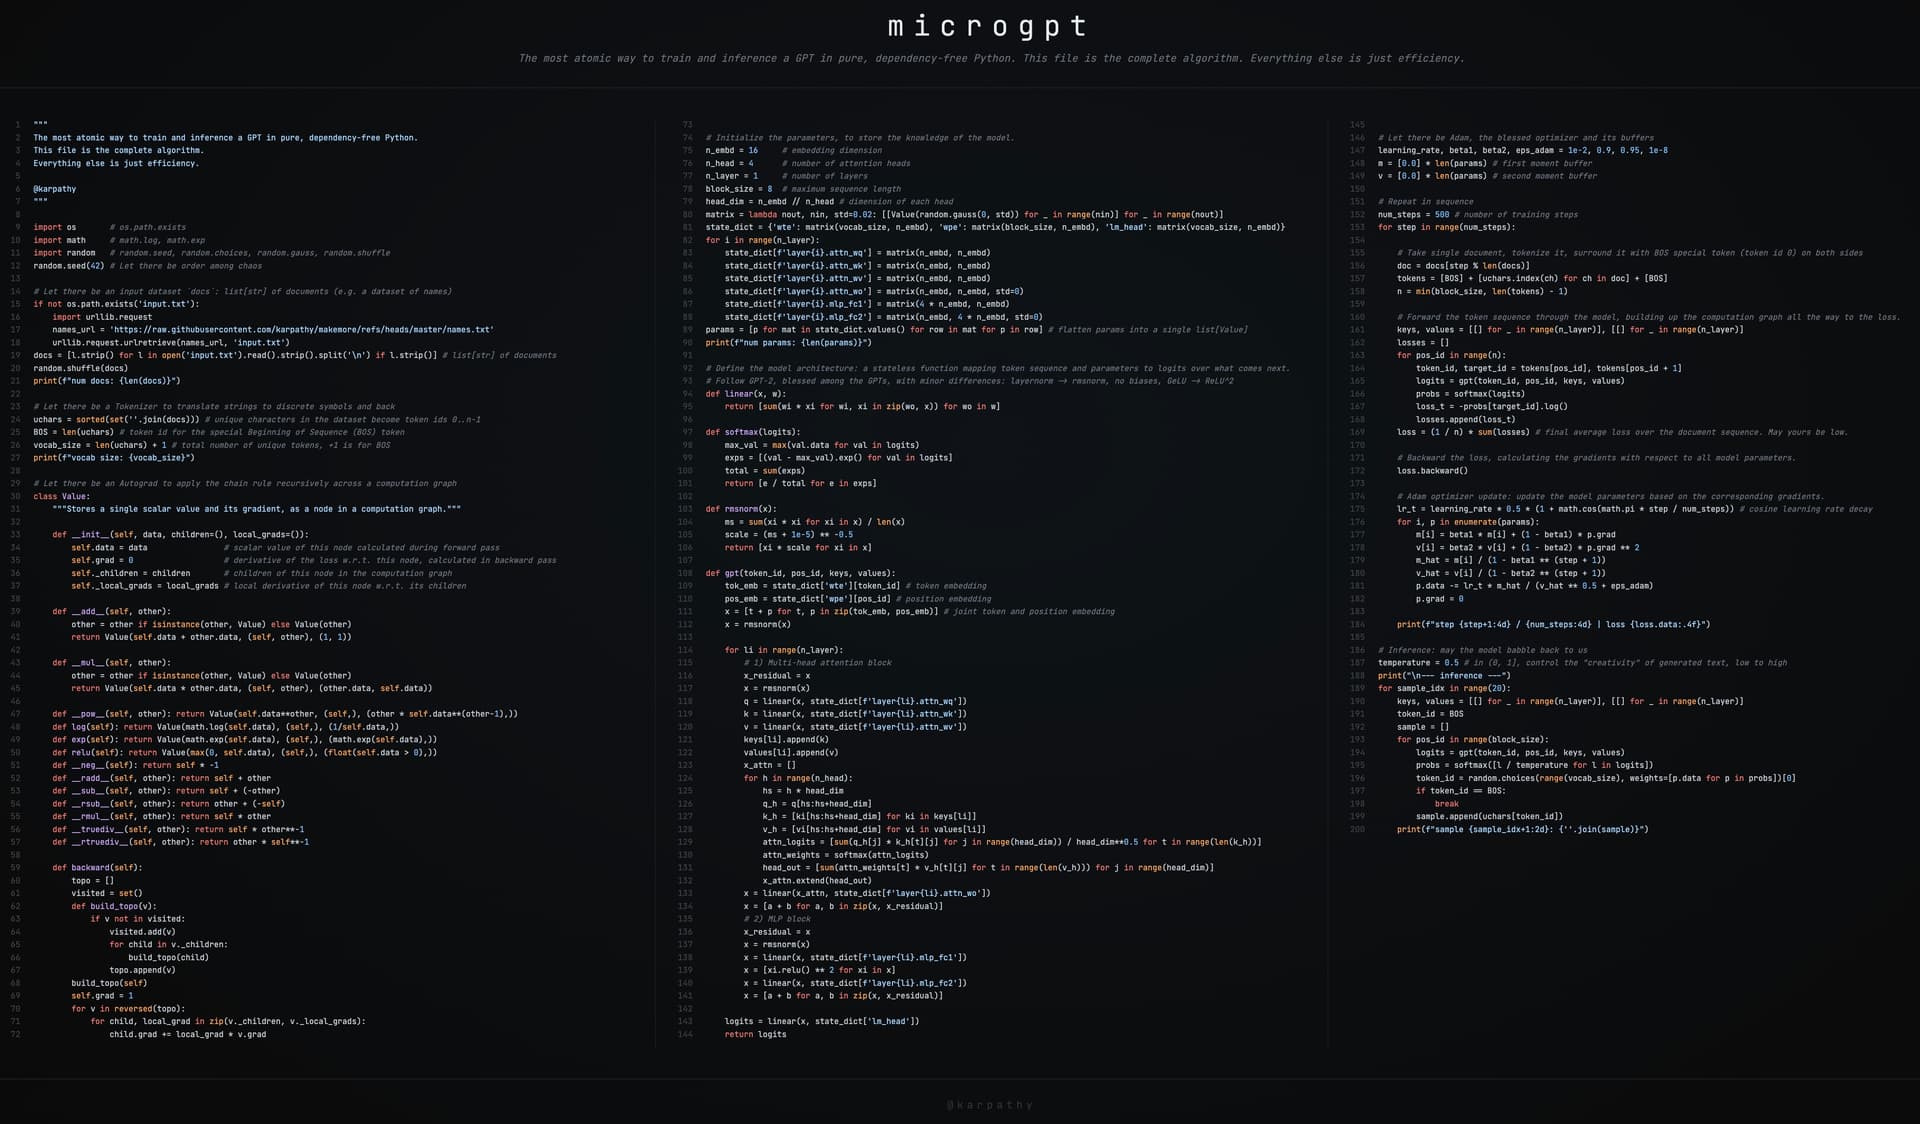
配图:Karpathy 的艺术项目 microgpt(2026-02),把 GPT 的全部算法压缩进 200 行纯 Python,是本课程理念的最终集大成。
如果你拿到一个 ChatGPT,只能看到它吐出的文字,看不见里面发生了什么。最容易的做法是当它是一个黑箱向导,问什么答什么。Karpathy 的课程反其道而行——先把黑箱拆成齿轮:
+、*、tanh 三种零件的钟表,零件之间用链条连起来,链条一拉(backward),每个零件的磨损量(梯度)就传回去了。仓库极简,只有三个顶层元素:LICENSE(MIT)、README.md、以及 lectures/ 目录。总计 7 个 Jupyter Notebook,代码量约 1200 余行(含大量逐行讲解型注释):
| 讲次 | Notebook | 代码行 | 核心依赖 |
|---|---|---|---|
| 1 | micrograd_lecture_first_half_roughly.ipynb | 236 | numpy, matplotlib, graphviz |
| 1 | micrograd_lecture_second_half_roughly.ipynb | 约 230 | numpy, matplotlib |
| 2 | makemore_part1_bigrams.ipynb | 240 | torch, matplotlib |
| 3 | makemore_part2_mlp.ipynb | 约 200 | torch |
| 4 | makemore_part3_bn.ipynb | 约 260 | torch |
| 5 | makemore_part4_backprop.ipynb | 约 200 | torch |
| 6 | makemore_part5_cnn1.ipynb | 265 | torch, random |
| 仓库同时是每个 notebook 的配套视频索引:README 中每一讲都给出 YouTube 链接、Colab 链接以及关联的独立仓库(micrograd / makemore / minBPE / nanoGPT)。这形成了一个完整的知识链:课程 → 视频 → 可运行的独立实现。 |
路径 A:本地 Jupyter(推荐)。git clone 后 pip install torch numpy matplotlib graphviz jupyter,逐个打开 notebook 跑。优点是能随意改参数做对照实验;缺点是 makemore 第 3 讲训练大 MLP 时纯 CPU 很慢,笔记本建议至少 16GB 内存。
路径 B:Google Colab(最省事)。README 直接给出了第 5 讲练习的 Colab 链接,免费 GPU 额度足够跑完全部 7 个 notebook,零环境配置。
路径 C:只看视频。适合时间紧的人,但 Karpathy 本人反复强调这讲不是设计来看的——练习才是精华,看视频不做练习基本等于没学。
硬件门槛本身极低:CPU 即可运行全部内容,无强制 GPU 要求,显存需求为 N/A(Colab 免费 T4 足够)。仓库无 Dockerfile、无 docker-compose、无 Web 服务端点,本质是教学资料而非可部署应用,因此平台标记为不支持一键部署是正确的。
第一,项目状态偏静态。仓库默认分支自 2024-08 之后没有新的提交,README 结尾是一句朴素的 Ongoing...。课程本身仍在持续(Karpathy 2026-02 还发布了 microgpt 这个集大成项目),但这个仓库更像一个静态的课程归档,而非活跃演进的代码库。想跟最新进展,得去跟 nanoGPT、microgpt 这条线。
第二,数学前置要求被低估。第 1 讲号称只需要高中微积分的模糊记忆,但第 5 讲手动反传 BatchNorm 时,涉及的量级推导对多数工程师仍然陡峭。54 个 open issue 里相当一部分是第 X 讲卡住了的求助。
第三,中文学习者存在额外门槛。课程视频全英文,无官方字幕,Notebook 注释也是英文;虽然社区有不少中文复刻笔记,但精度参差。
第四,工业界早已转向更高层抽象。2026 年的主流训练栈(nanoGPT、HF Transformers、DeepSpeed、Megatron)都已远超课程内容,课程里的手写一切在生产中是不划算的。它的价值不在于教你写生产代码,而在于给你一套不依赖任何框架的物理直觉。
第五,没有配套测试与 CI。Notebook 本身即测试(能跑通说明代码对),但从工程规范看缺乏断言、缺乏回归保护。
从数据看,这个仓库 2022 年 9 月创建,一年多内冲到 2 万星并稳定至今,25,255 stars / 3,678 forks / 54 open issues。提交历史仅 12 页、贡献者约 200 人,绝大多数是 issue 和练习提交——这正是课程型仓库的典型生态:它是流量中心,不是协作中心。
更值得注意的是它的溢出效应。micrograd、makemore、minBPE、nanoGPT、microgpt 这条线全部出自同一作者之手,构成了从标量自动微分 → 字符级语言模型 → BPE 分词 → 可训练 GPT 的完整技术谱系。Karpathy 2026-02 发布的 microgpt 用 200 行零依赖纯 Python 重写了完整 GPT 训练与推理(数据集、tokenizer、autograd、GPT-2 风格网络、Adam、训练循环、推理循环),并明确称之为这条十年路线的集大成。
这说明了一件事:这门课的价值不在代码本身,而在它塑造了一种思维方式——把任意复杂系统拆到不能再拆的原子,然后用最朴素的方式重新装回去。Karpathy 的博客正文里写道,他花了十年把 LLM 简化到最本质,并认为这种简化是美的。
如果你是研发团队负责人,这份材料适合作为新人神经网络原理培训教材:
loss.backward() 到底做了什么;karpathy/nn-zero-to-hero 用 2.5 万星证明了一件事:最好的入门材料不是最简单的,而是最诚实的。它不藏任何魔法,每一行反向传播、每一个张量形状都摊开给你看。30 年后当 Transformer 早已换了十代架构,这个仓库的思维方式依然不会过时——因为它教的从来不是某个架构,而是如何把一个复杂系统拆到原子再重建的能力。
