
llm-council
karpathy/llm-council加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
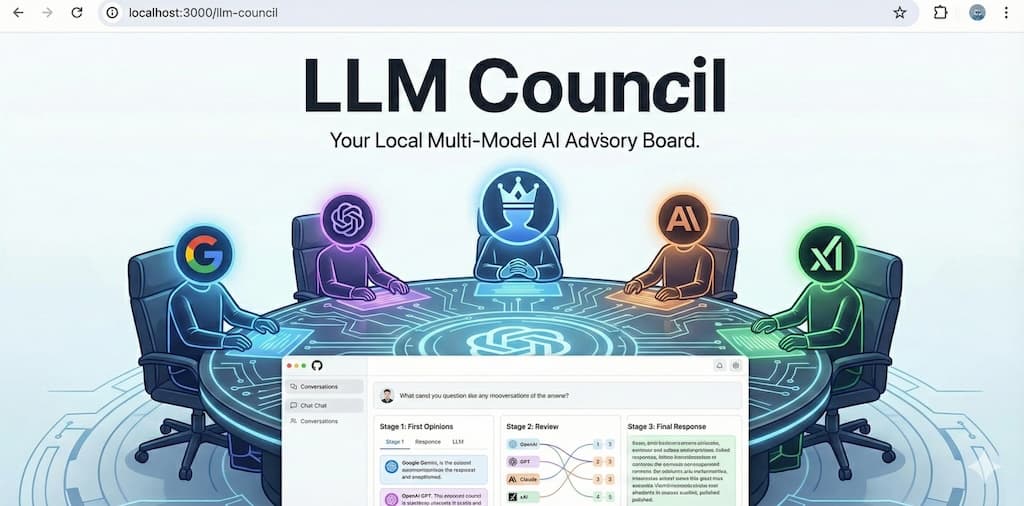
你有多少次遇到这种情况:问了一个复杂的 AI 问题,得到一个答案,深信不疑,结果第二天发现错了?
这正是 LLM Council 要解决的核心痛点。
LLM Council 是由 AI 领域传奇人物 Andrej Karpathy 在 2025 年 11 月用一个周末" vibe coded"出来的项目——他本人在 README 里直言不讳:"This project was 99% vibe coded as a fun Saturday hack"。结果一上线就在 GitHub 爆火,短短不到一年时间斩获 24,800+ Stars,成为 AI 社区的现象级项目。
它的核心洞察很简单:与其相信一个模型,不如让一群模型开会辩论。
Karpathy 将这个思路类比成现实中的委员会决策机制——做一个重大工程决策,你不会只问一个人的意见。你会让不同背景的专家各自发言、互相点评,最后由一个主审综合所有人的意见,形成一个更有依据的结论。LLM Council 把这个流程自动化了。
LLM Council 的工作流程分为严格的三个阶段:
第一阶段:各抒己见(Stage 1 - First Opinions)
用户提交问题后,系统同时(并行,用 asyncio.gather 实现)向所有 Council 成员模型发送相同的查询。每个模型独立生成回答,彼此不知道对方说了什么。这样得到的是最原始、最未受污染的观点集合。
第二阶段:匿名互评(Stage 2 - Peer Review)
这是整套机制最精妙的设计。系统将第一阶段的所有回答匿名化——"Response A、Response B、Response C"——抹掉模型品牌名称,重新发给每个模型。让它们以"不知道谁写的"为前提,对其他回答进行准确性和洞察力的排序与评价。
为什么要匿名?因为研究表明,模型也会"品牌崇拜"。GPT 写的答案,即使错了,人们也倾向于给更高分。匿名评审让评价回归内容本身。系统最后汇总所有模型的排名,计算加权得分。
第三阶段:主席定论(Stage 3 - Chairman Synthesis)
指定的 Chairman 模型(默认 Gemini 3 Pro Preview)接收:原始问题 + 所有第一阶段回答 + 所有第二阶段评审 + 聚合排名结果。它作为裁判,综合提炼出一个最终答案。
最终答案不是简单选 Winner,而是真正融合了各模型最强论点的合成结论。
LLM Council 的技术栈极为精简:
| 层级 | 技术选型 |
|---|---|
| 后端 | FastAPI + Python 3.10+,异步 httpx |
| 前端 | React + Vite + react-markdown |
| 模型网关 | OpenRouter(一套 API 调用所有模型) |
| 数据存储 | JSON 文件(data/conversations/) |
| Python 包管理 | uv(Astral 出品,比 pip 快 10-100 倍) |
项目没有直接对接 OpenAI、Anthropic、Google 的独立 API,而是通过 OpenRouter 作为统一网关。OpenRouter 是一个聚合了全球主流大模型的平台,用户只需一个 API Key,就可以同时调用 GPT-5.1、Gemini 3 Pro、Claude Sonnet 4.5、Grok 4 等多个模型。
这大大降低了配置复杂度,也方便用户根据需要随时替换 Council 成员。
后端结构清晰:
council.py:核心逻辑,包含三个 stage 的完整实现、parse_ranking_from_text() 排名解析、calculate_aggregate_rankings() 聚合算法openrouter.py:API 调用封装,支持并行查询(query_models_parallel)和优雅降级(某个模型失败不影响整体)storage.py:JSON 文件存储对话历史config.py:Council 成员配置、Chairman 模型选择前端同样清晰:ChatInterface(主对话界面)、Stage1/Stage2/Stage3(三阶段结果展示)、Stage3 最终结论以绿色背景高亮显示(#f0fff0),便于用户识别最终答案。
第一步:安装依赖
# 后端(使用 uv 管理 Python 环境)
uv sync

# 前端
cd frontend && npm install && cd ..
第二步:配置 API Key
在项目根目录创建 .env 文件:
OPENROUTER_API_KEY=sk-or-v1-xxxxxxxxxxxxxxxx
API Key 需要在 openrouter.ai 注册并充值。
第三步:启动服务
./start.sh
# 或手动:
# 后端:uv run python -m backend.main  (端口 8001)
# 前端:cd frontend && npm run dev     (端口 5173)
打开 http://localhost:5173 即可使用。
| 项目 | 说明 |
|---|---|
| Web UI | ✅ 有,React 界面 |
| 容器化 | ❌ 无 Dockerfile / docker-compose |
| 硬件需求 | 极低,CPU 即可,无 GPU 需求(纯 API 调用) |
| 快速部署 | ⚠️ 部分支持,需手动安装前后端环境 |
| 自定义模型 | 修改 backend/config.py 中的 COUNCIL_MODELS 和 CHAIRMAN_MODEL 列表 |
LLM Council 最重要的意义不是"多模型答案看起来更丰富",而是通过辩论机制系统性降低幻觉率。
为什么有效?因为模型是更好的评判者(Discriminator)而非生成者(Generator)。一个模型在生成答案时可能犯错,但在判断其他答案是否正确时,准确率更高。第二阶段的匿名互评正是利用了这一点——让模型互相挑毛病,而不是各自埋头输出。
有研究(如 MIT 相关实验)表明,让模型互相辩论可以将复杂问题的准确率从 70% 提升到 95% 以上。这是一个数量级的可靠性提升。
此外,项目设计天然无供应商锁定:换一个新模型只需在配置里改一行,框架不关心模型是谁。
LLM Council 代表了一种新兴的 AI 应用范式:Multi-Agent 协作 + 评判机制。它不是唯一一个尝试让模型互相评价的项目,但它是最简洁、最容易本地部署的参考实现之一。
对于 AI 爱好者而言,这是一个低门槛体验"让 AI 开会"的机会。对于开发者而言,它是一个极好的参考架构——如果你的业务场景需要高可靠性答案(如代码审查、法律分析、医疗建议),LLM Council 的三阶段辩论框架可以直接作为原型基础。
Stars:24,800+ | Forks:4,300+ | 语言:Python | 许可证:None
