
Grimore-MD
kahz12/Grimore-MD加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你的笔记库里有成百上千条笔记,随着时间推移,你甚至记不清自己写过什么。Grimore-MD 就像一个永不停歇的图书管理员,帮你的所有笔记自动打标签、建立语义索引,还能用本地大模型回答"我之前记过关于 XX 的内容吗"这样的问题——所有数据留在本地,无需任何 API Key。
随着 AI 工具爆发式普及,很多人开始将知识管理迁移到数字工具中。然而主流的 AI 知识管理方案存在两个根本问题:
隐私风险:用户的笔记内容会上传到云端,由第三方服务器处理。对于医生、律师、科研人员等需要处理敏感信息的从业者,这是不可接受的。
订阅依赖:云端 AI 服务意味着月费和供应商锁定。一旦服务商涨价或倒闭,所有基于它构建的工作流都会瘫痪。
Grimore-MD 的作者 kahz12 在 README 中明确表达了设计哲学:本地优先(Local-First)。整个系统运行在你的机器上,通过 Ollama 调用本地大模型(LLM)完成认知任务——什么也不发送到外网,不需要任何 API Key。
Grimore-MD 提供了完整的知识管理认知流水线,覆盖从文档入库到智能问答的全链路。
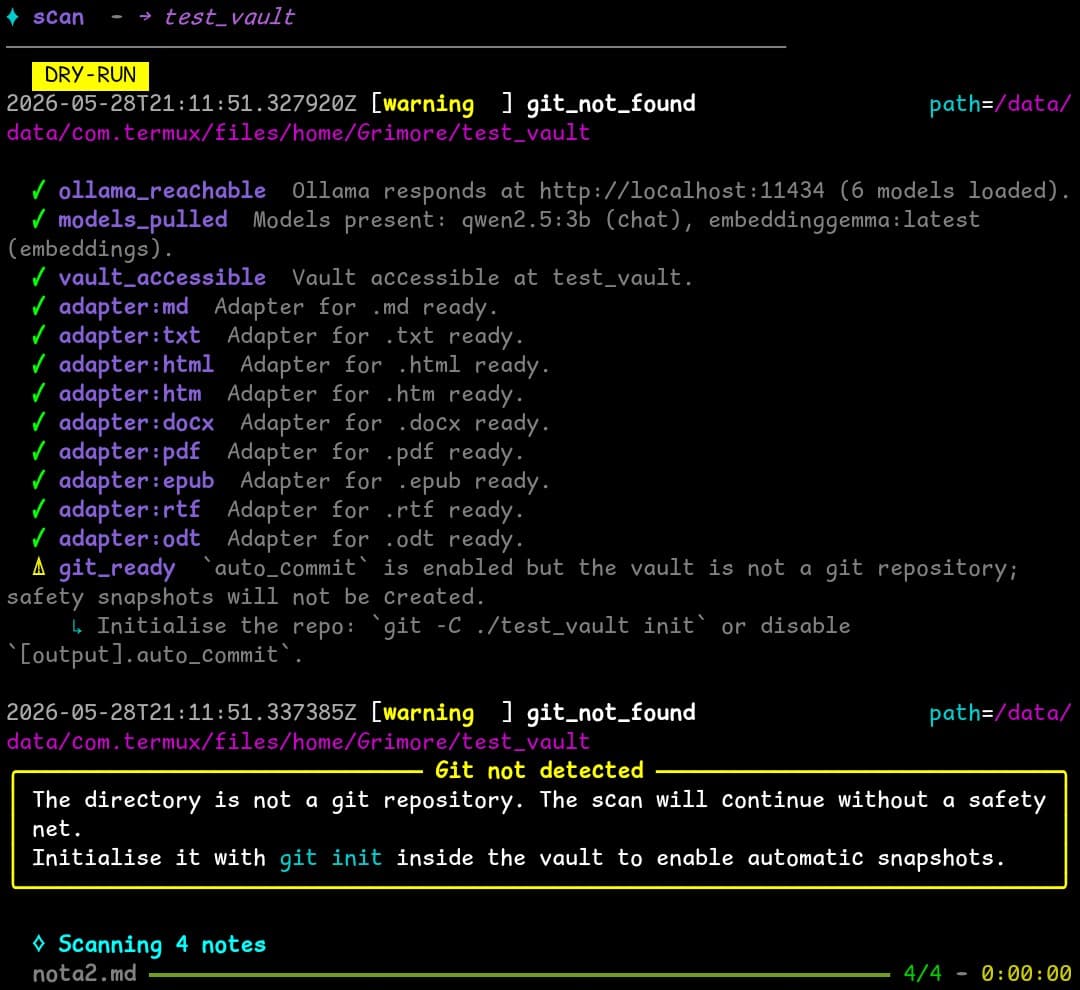
Grimore-MD 支持 Markdown、PDF、EPUB、DOCX、ODT、RTF、HTML、TXT 八种常见格式的文档。首次运行只需配置 vault 路径,执行 grimore scan 即可一键扫描整个知识库。系统内置 watchdog 模式,能在后台监控文件变化、实时增量更新索引,无需重复全量扫描。
预检机制(grimore preflight)会在扫描前验证所有适配器是否正常,这对混合格式的笔记库尤为重要。
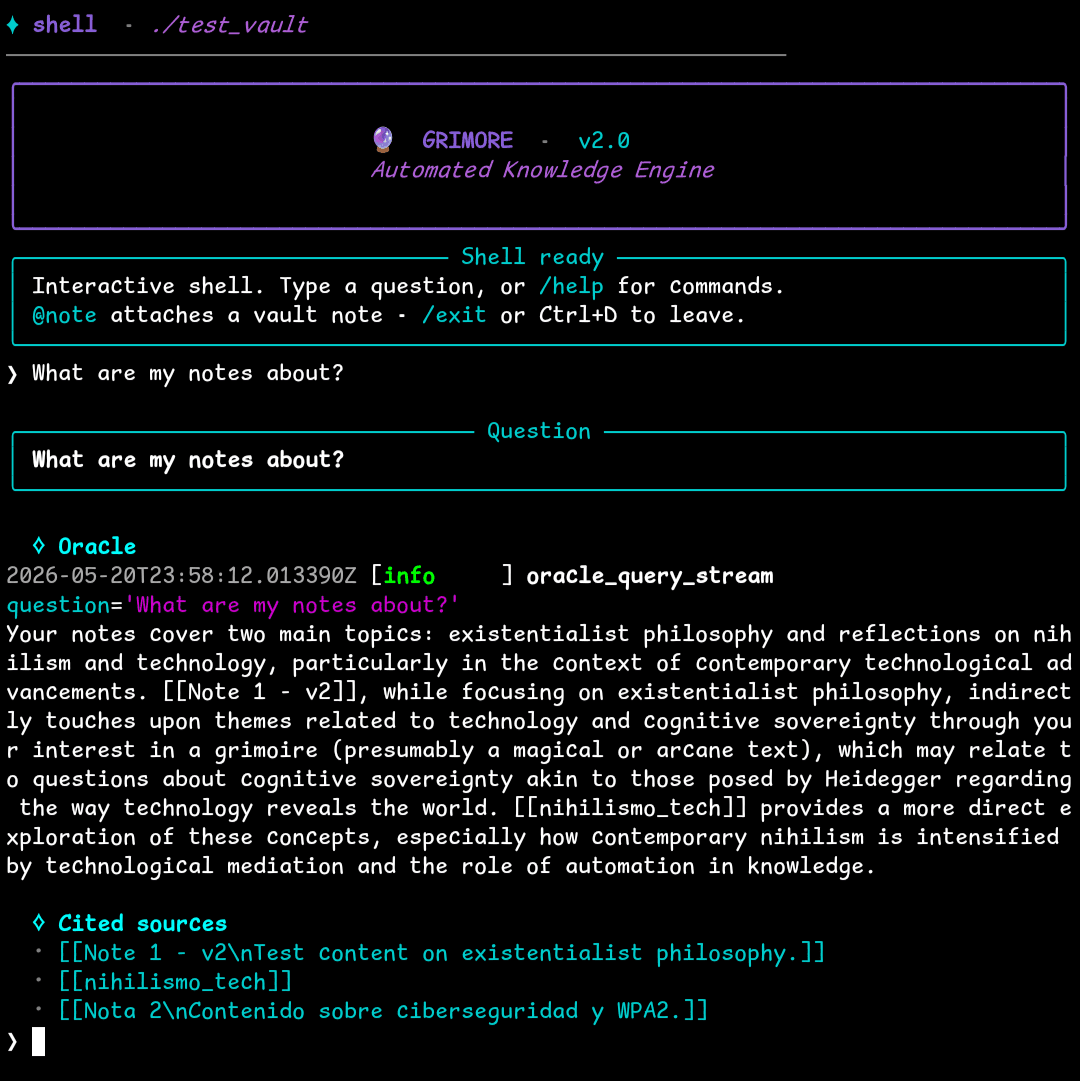
Grimore-MD 的检索层采用 BM25 关键词 + 向量语义 双路融合,通过 Reciprocal Rank Fusion(RRF)算法综合排名。Oracle 模块是系统的 RAG 引擎:接收用户问题 → 从向量数据库检索相关片段 → 构造提示词调用本地 LLM → 流式输出带溯源引用的回答。引用格式为 [[文档标题#页码]],可直接点击跳转到原始笔记位置。
更强大的是,Oracle 支持多维度过滤:按分类(--category)、标签(--tag)、文档格式(--format pdf)缩小检索范围,组合使用实现精准问答。
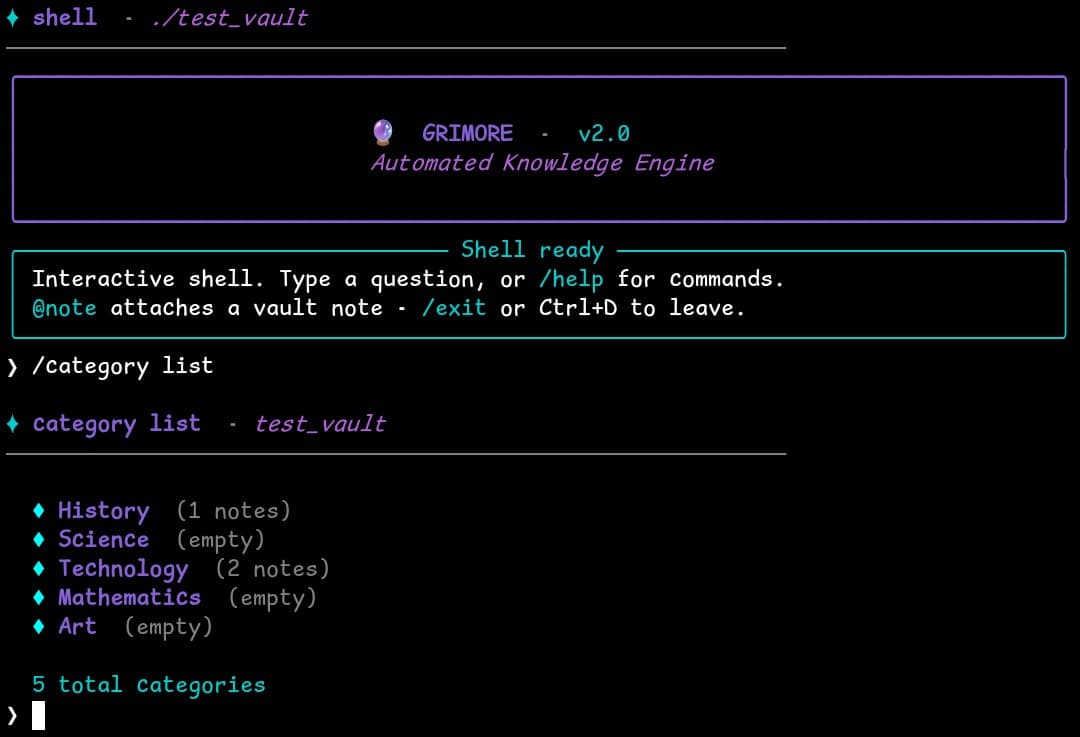
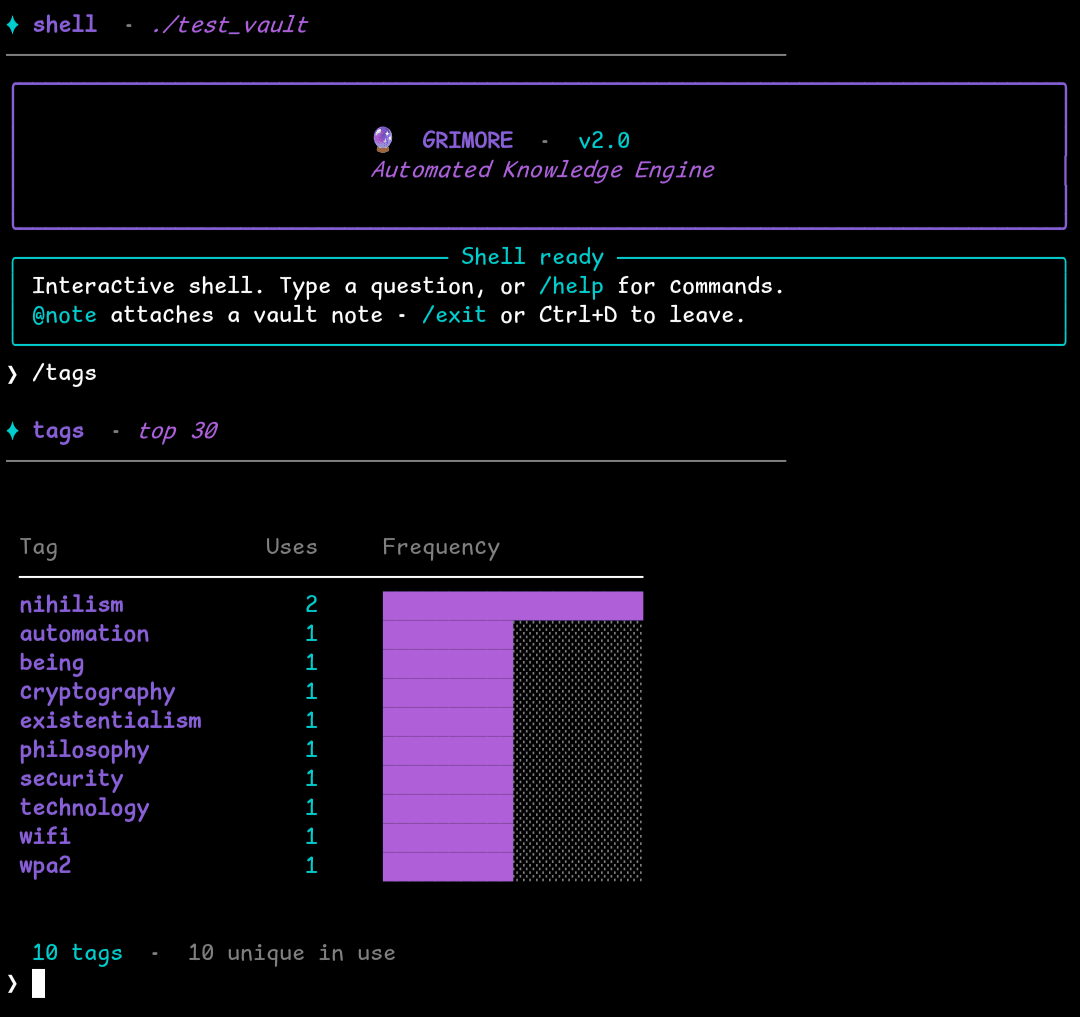
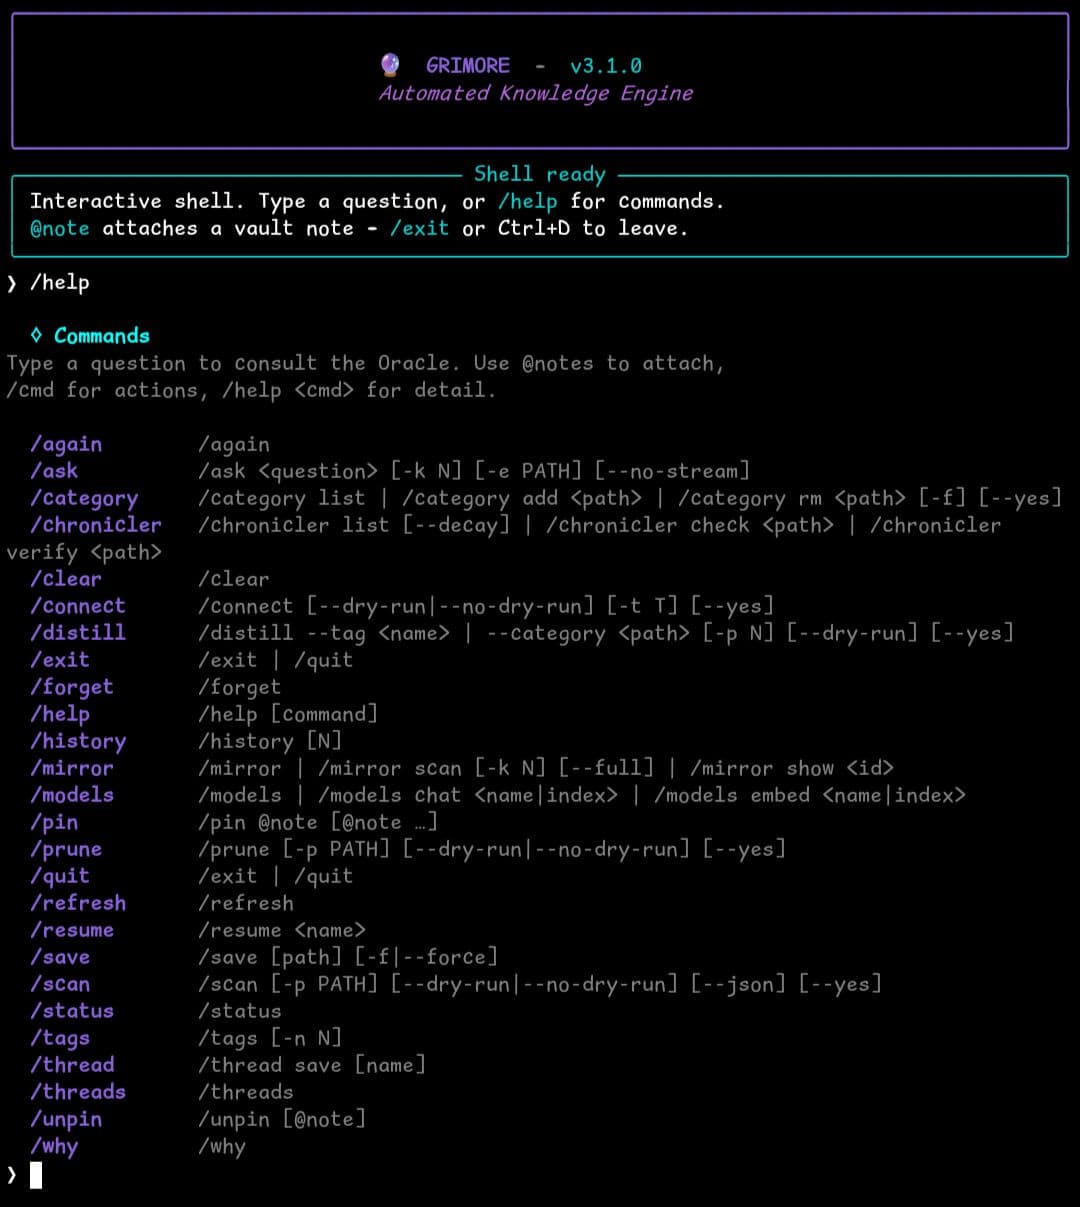
Grimore-MD 的 cognition pipeline 会自动分析笔记内容,生成标签(Tags)和分类(Categories)。这些元数据不是简单关键词提取,而是由 LLM 理解文档语义后生成的描述性标注。发现(Discover)功能允许你浏览整个知识库的主题结构:/category 列出顶层分类,/tags 显示标签频率图表,帮助你了解自己的知识分布。
Grimore-MD 的源码按职责划分为以下核心模块:
grimore/ingest:适配器层,负责解析多格式文档(PDF/EPUB/DOCX/Markdown 等),使用 python-frontmatter 处理 YAML frontmatter,pypdf 解析 PDF,beautifulsoup4 提取 HTML。grimore/cognition:认知层,是系统最核心的模块。包含:Chunker(文档分块)、Embedder(向量嵌入)、Connector(检索引擎)、LLMRouter(LLM 路由)、Oracle(RAG 问答引擎)、Tagger(自动标注)、Graph(图关系分析)。grimore/memory:存储层,使用 SQLite(WAL 模式 + FTS5) 存储文本和向量,按 sha256(model ‖ chunk) 作为向量键,支持模型热切换时自动失效旧向量。grimore/api:HTTP API 层,基于 Starlette(轻量 ASGI 框架)构建,提供 RESTful 接口和浏览器 UI。grimore/daemon:守护进程,管理后台任务和文件监控。grimore/shell:交互式 Shell,基于 prompt-toolkit 和 rich,提供类 CLI 的操作界面。Grimore-MD 的 RAG 实现有几个值得注意的设计决策:
上下文截断保护:_ORACLE_CONTEXT_MAX_CHARS = 16,000 硬上限,防止过大上下文压垮小模型。
条件重写(Conditional Rewrite):Oracle 在检索后可能对问题进行 LLM 重写,使查询措辞更贴近文档表达,提升检索召回率。重写有独立超时(60s),防止卡死。
混合检索降级:RRF 融合中,若 BM25 或向量检索有一方不可用,系统自动降级到单路检索,保证可用性。
通过 LLMRouter 支持多后端对接 Ollama,允许在配置中指定不同模型处理不同任务(如问答用 7B、标注用 3B),实现资源与效果的平衡。
项目在隐私设计上下了大量功夫:
cognition.allow_remote = false(默认):SecurityGuard 拒绝任何非 loopback 地址的 LLM 请求,并锁定 IP 防止 DNS 重绑定攻击。secrets.compare_digest,防止时序攻击。.grimore/sidecars/ 侧文件,完全不改动原文档。项目使用 Pydantic v2 做配置和接口建模,Typer 构建 CLI,structlog 做结构化日志,整体代码组织清晰。测试覆盖 benchmark(bench/)、评估(eval/)和单元测试(tests/)三部分。文档详尽(英文和西班牙语双语用户指南)。
git clone https://github.com/kahz12/Grimore-MD.git
cd Grimore-MD
python -m venv .venv && source .venv/bin/activate
pip install -e .

ollama pull qwen2.5:3b      # 聊天模型
ollama pull nomic-embed-text # 向量模型

cp grimore.toml.example grimore.toml
grimore preflight
grimore scan --no-dry-run
grimore daemon start
grimore shell
grimore serve                    # 仅本地访问
grimore serve --allow-lan       # 开放局域网
grimore serve --api-token TOKEN # 启用 Token 鉴权
Grimore-MD 提供 MCP(Model Context Protocol)服务器,通过 grimore mcp 命令接入 Claude Desktop、Cursor、Zed 等支持 MCP 的 IDE,将本地知识库作为 AI 助手的上下文来源。
资源消耗:本地运行 LLM 是 CPU/内存密集型任务。即使是 3B 参数的 qwen2.5:3b,在无 GPU 的设备上运行也会明显卡顿。推荐使用配备 GPU 的机器,或接受较慢的响应速度。
模型调优:默认配置依赖特定模型(qwen2.5:3b + nomic-embed-text)。虽然 LLMRouter 支持自定义模型,但不同模型的输出质量差异较大,需要一定调优经验。
无原生移动端:虽然支持 Termux(Android),但并非原生 App。Ollama 服务需要在后台运行,对移动端用户有一定门槛。
无 Docker 支持:项目未提供容器化方案,在没有 Python 3.11+ 环境的系统上部署相对繁琐。
Grimore-MD 代表了一个正在壮大的趋势:本地 AI(Local AI)工具链。随着 Ollama、llama.cpp 等工具成熟,在本地消费级硬件上运行中等规模模型已成为现实。隐私优先、知识自主的理念,正在从极客圈向更广泛的专业用户群体渗透。
作为 Obsidian 和 Roam Research 的有力补充,Grimore-MD 的 RAG 问答能力让"搜索笔记"升级为"向笔记提问"——这是一个质变。它模糊了"笔记工具"和"AI 助手"之间的边界,预示着未来知识管理工具的发展方向:每个用户的个人知识库,都将拥有一个专属的本地 AI 管家。
