
clifs
johanmodin/clifs加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
CLIFS 让你用一句自然语言描述(比如"一辆白色宝马"或"写着JCN的卡车"),从海量视频中精准捞出匹配的那一帧——背后靠的是 OpenAI CLIP 模型对图像和文本的双向理解能力。
想象一个城市监控中心,每天产生 PB 级别的视频数据。当警官想要查找"昨天下午在解放路出现的白色 SUV"时,传统做法是调出所有监控录像,一帧一帧人工回放——这不是在办案,这是在看恐怖片。
CLIFS 就是来解决这个痛点的。它把视频切分成帧,每帧通过 CLIP 图像编码器提取特征向量;用户输入的搜索文本则通过 CLIP 文本编码器转换为特征向量;两套向量一比对,余弦相似度最高的帧就是答案。
实际效果如何?项目作者用 UrbanTracker 数据集中的实拍交通视频做了测试:
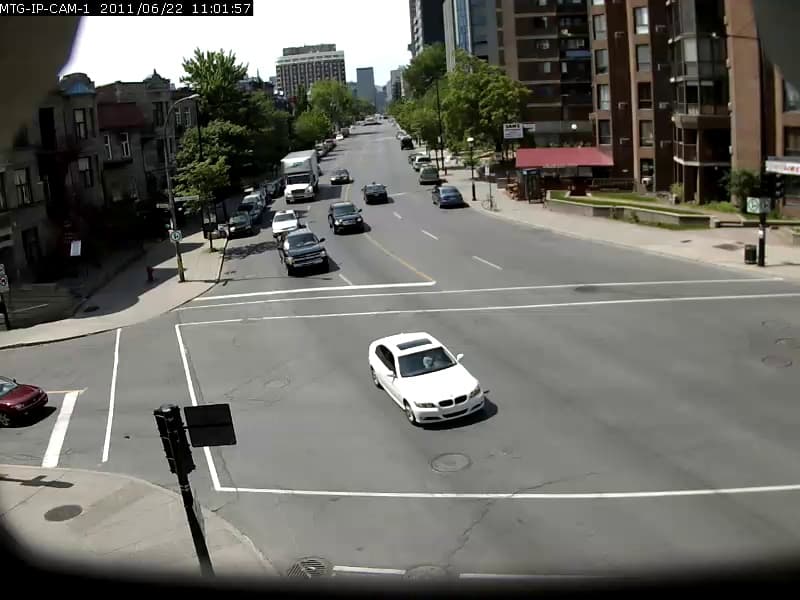
CLIFS 的核心依赖是 OpenAI 在 2021 年发布的 CLIP(Contrastive Language-Image Pre-training)。CLIP 的训练方式很独特:它同时接收图像和描述该图像的文本,将两者映射到同一个向量空间。训练目标是让"匹配的图文对"在向量空间中距离更近,"不匹配的图文对"距离更远。
这意味着 CLIP 天生具备 zero-shot 能力——你不需要针对"宝马"、"odwalla 标志"专门训练模型,只要能用文本描述出来,CLIP 就可能理解。这就是 CLIFS 能实现自由文本视频搜索的底层逻辑。
项目默认使用 RN50x4(ResNet-50x4)模型,这是 CLIP 系列中在图像-文本匹配任务上表现较强的变体。用户也可以通过 MODEL 参数切换为 RN50、RN101 或 ViT-B/32 等其他模型。
CLIFS 采用 Docker Compose 编排两个独立服务:
search-engine 容器:运行 Flask API + CLIP 推理引擎。核心逻辑在 search/app/clifs.py 中:
self.image_features)并记录 feature_idx_to_video 映射web 容器:Django Web 服务,提供搜索界面和结果展示。Django 版本锁定在 3.x(>=3.0,<4.0),这是一个比较老的技术选择,意味着后续维护可能需要处理依赖兼容性问题。
两者通过共享 volume 通信:./data/input 挂载视频文件,./data/output 挂载搜索结果图片。
CLIFS 的部署分为三步:
# 1. 下载测试视频(可选)
./setup.sh

# 2. 放入你自己的视频
cp your_video.mp4 data/input/

# 3. 一键启动
docker-compose build && docker-compose up
硬件层面,GPU 是必须的。search-engine 的 Dockerfile 基于 nvidia/cuda:11.2.2,运行 PyTorch 1.8.2 + CLIP,需要 6GB 以上显存。如果机器没有 NVIDIA GPU,CLIFS 会退回到 CPU 推理——但搜索速度会从秒级变成分钟级,体验差距明显。
好消息是官方提供了 GPU 版 docker-compose 配置,有 NVIDIA 驱动 + nvidia-container-toolkit 的机器可以直接使用。对于没有 GPU 的用户,可以考虑在 Gradient、Colab 或各类云 GPU 实例上部署。
CLIFS 作为一个 PoC(概念验证)项目,存在一些明显的局限:
1. 视频只能通过 volume 挂载上传,Web 界面上传功能"not fully implemented yet"(见 server.py 第13行注释)。每次新增视频都要重启容器,对于动态监控场景不太友好。
2. 特征全部存在内存中,重启即丢失。没有持久化索引机制,大规模视频库场景下内存压力会很大。
3. Django 版本过旧:>=3.0,<4.0 的约束意味着安全补丁和功能更新都会滞后。
4. 没有中文支持:CLIP 训练数据以英文为主,用中文搜索英文监控视频效果可能打折扣。
5. 无法精确定位时间戳:搜索结果返回的是"最相似的帧",但没有给出这一帧在原视频中的时间位置信息。
CLIFS 展示了一条不需要大规模预训练也能做视频语义搜索的技术路径。相较于传统的 OCR + 物体检测方案,CLIP 的 zero-shot 能力让系统可以理解更抽象的描述("可疑行为"、"情绪激动的人"),而不只是预定义的标签集合。
这类技术对以下场景有直接价值:
CLIFS 项目本身 star 不算高(483),但它代表的技术方向——"用自然语言解锁视觉大数据"——正在成为 CV + NLP 融合领域的热点。随着多模态模型的快速发展,这类工具的精度和易用性都在快速提升。
想亲自动手试试?前置条件:
git clone https://github.com/johanmodin/clifs.git
cd clifs
./setup.sh  # 下载测试视频
docker-compose -f docker-compose.gpu.yml build && docker-compose -f docker-compose.gpu.yml up
# 浏览器打开 http://localhost:8000,输入搜索文本
