PRISM
jingyip-cat/PRISM加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
试着回忆一下:你上周五下午三点,和同事聊了什么?
对一个正常人来说,这个问题需要翻遍聊天记录。但对一个大型语言模型(LLM)来说,难度远不止"记不住"——它从一开始,就根本没有真正的记忆能力。每一次对话,它都从空白状态开始,所有的"经历"只存在于对话窗口关闭前的上下文里。
这不只是 ChatGPT 的问题,而是所有 LLM 的根本局限:它们是"无根"的智能"。
然而,在现实场景中——客服对话、医疗记录、法律咨询——"上下文窗口"(Context Window)迟早会被填满。填满之后怎么办?早期做法很简单:把所有历史对话都塞进去。代价是成本飙升,且超过一定长度后,LLM 会像人一样"记混了"。
PRISM,就是来解决这个问题的。
PRISM 全称 Pareto-Efficient Retrieval over Intent-Aware Structured Memory,中文可译为"基于意图感知结构化记忆的帕累托高效检索框架"。这个名字里的每个词都值得拆解:
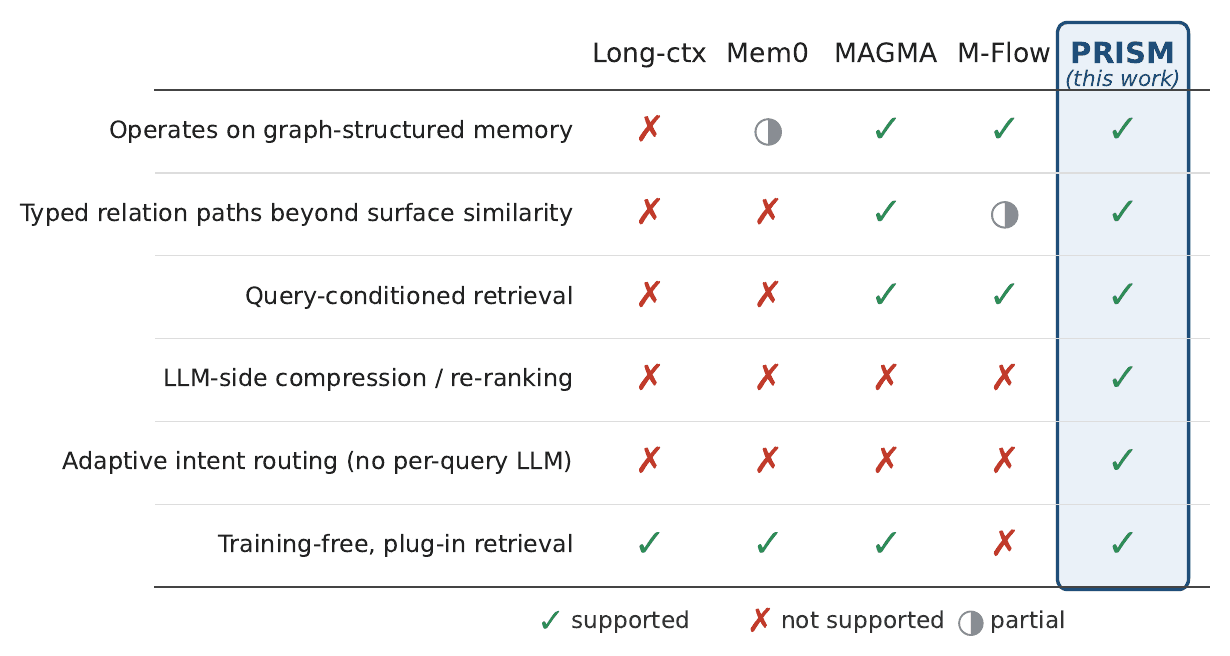
Pareto-Efficient(帕累托高效)——这是关键。工程中不存在免费的午餐,提升准确率往往意味着增加计算成本。帕累托高效指的是:在同样的成本预算下,达到了最高的准确率;或者说,在同样的准确率目标下,用了最少的成本。PRISM 追求的是这个最优点。
Intent-Aware(意图感知)——用户的问题背后有不同的"意图"。比如"我上周做了什么"是时间意图;"为什么会这样"是因果意图;"帮我找相关内容"是语义意图。PRISM 能识别这些意图,并针对性地调整检索策略。
Structured Memory(结构化记忆)——不是把对话当文本块存起来,而是构建一张多层级知识图谱。最小的记忆单元是"实体"(Entity),实体组成"方面"(Facet),多个方面组成"事件"(Episode)。这些单元之间,通过时间、因果、语义等多种关系连接。
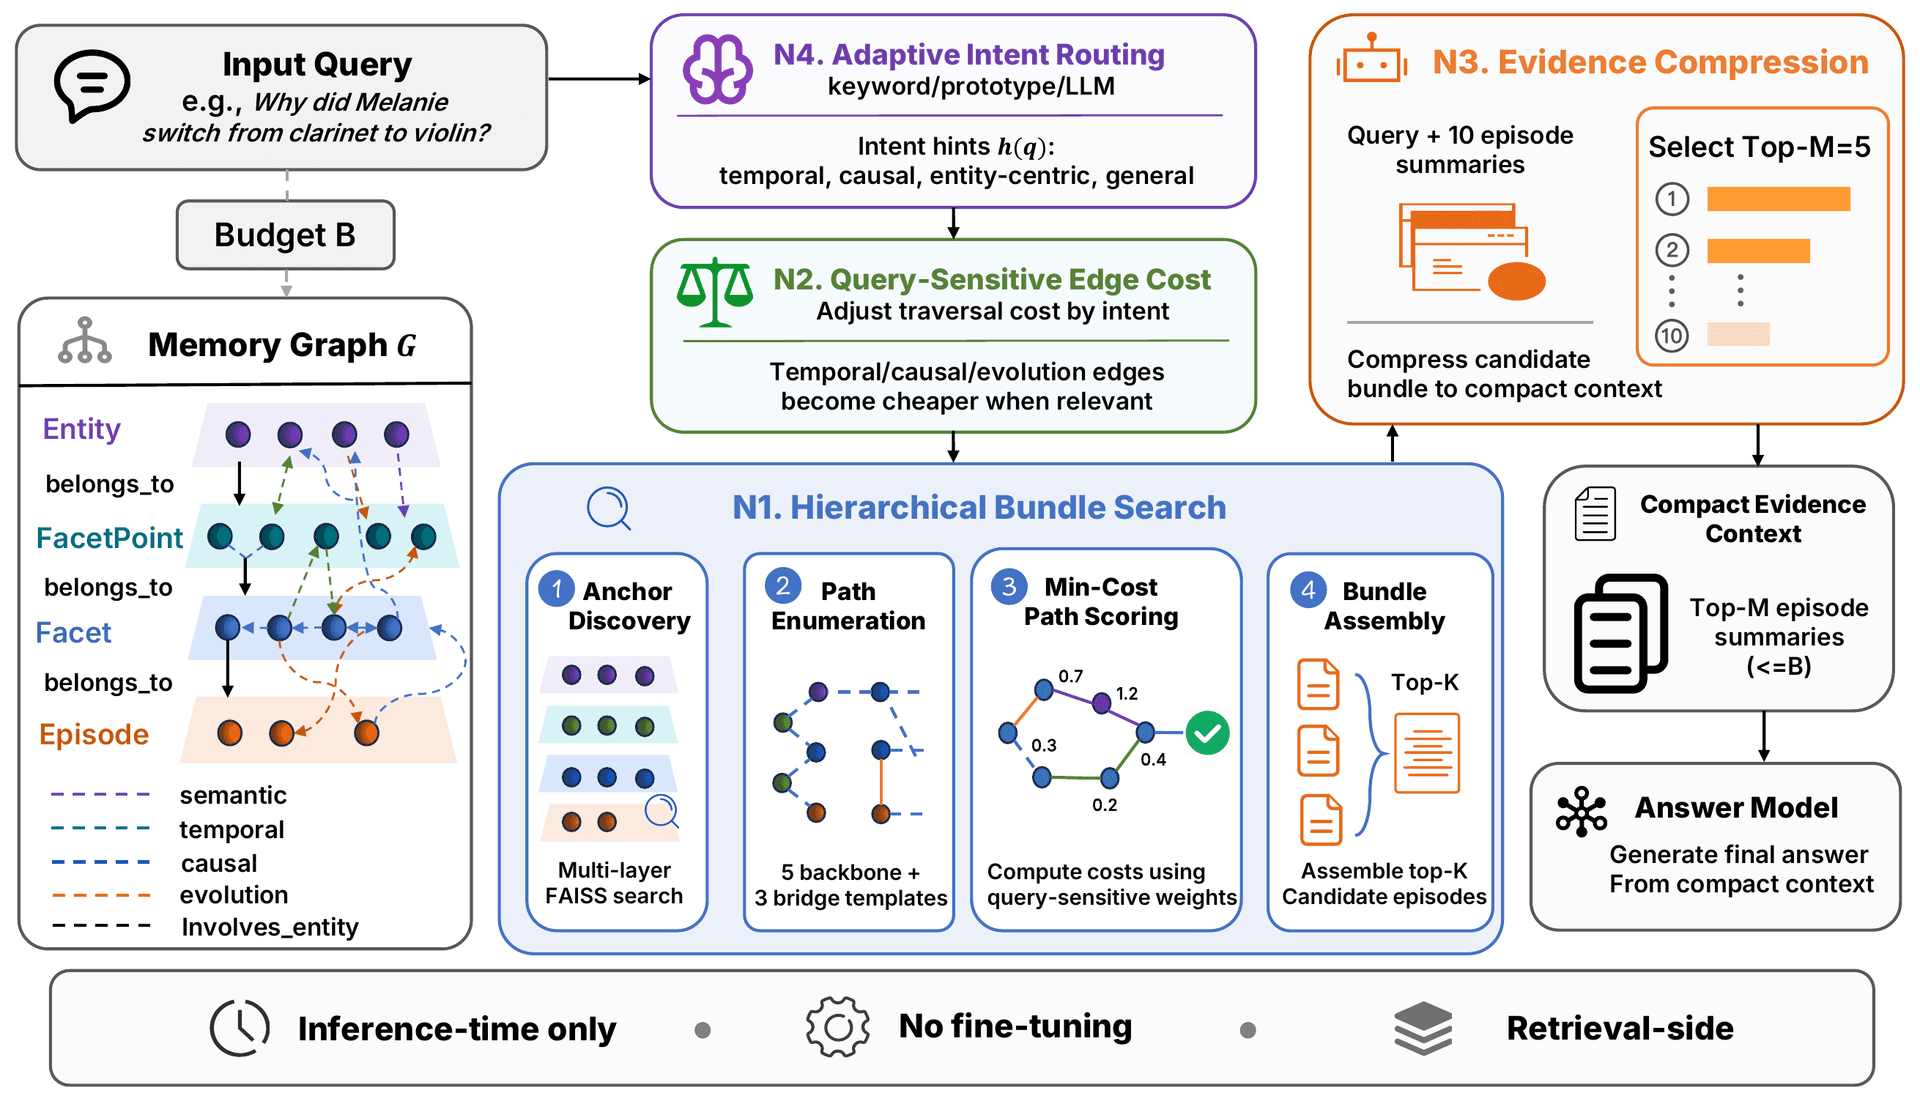
PRISM 的核心创新在于四个推理时模块,它们像一条流水线,依次协作:
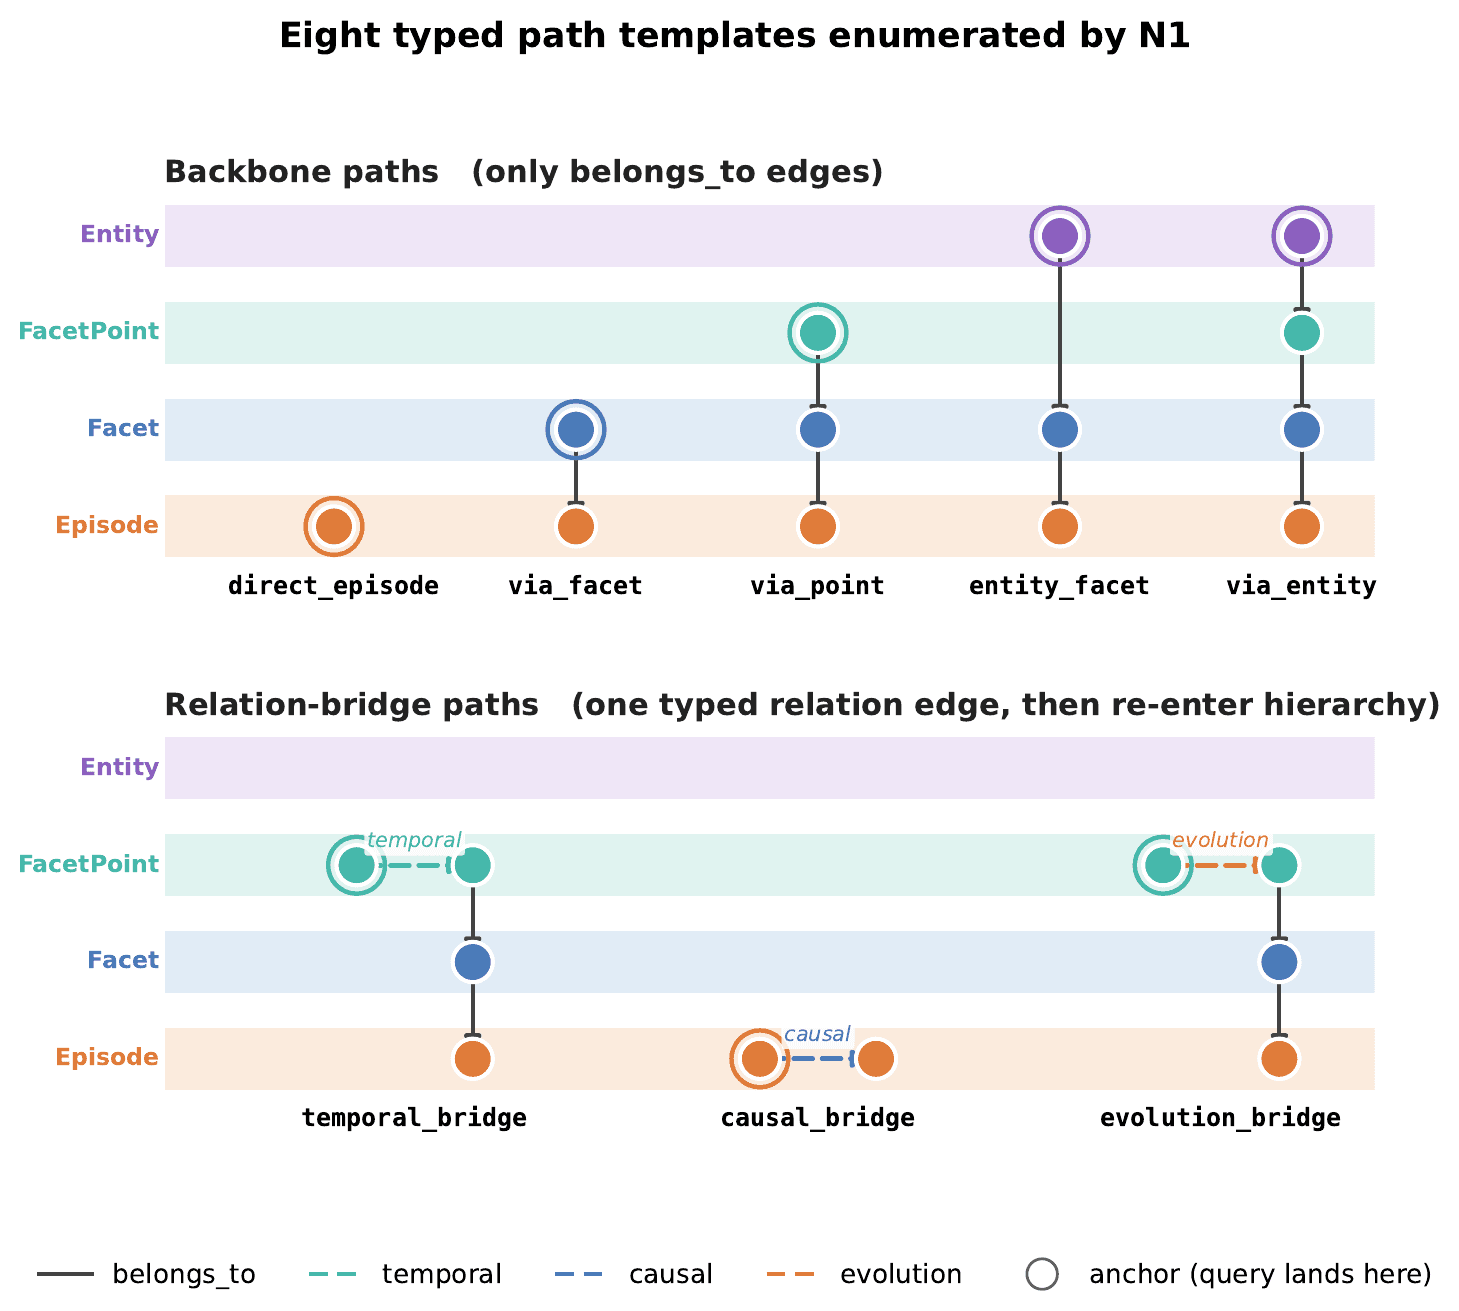
这是整个流水线的入口。当用户提问时,系统首先通过向量检索(FAISS)在各层知识图谱中定位候选节点。但关键在于——它不仅仅做简单的相似度匹配,而是沿关系模板的"最小成本路径"扩展,找到那些字面不相似、但逻辑上有关联的内容。
类比一下:普通的向量检索像是"看脸找人",而 N1 做的是"根据社会关系网找人"——即使你换了个发型、化了妆,关系网依然能把你找出来。
关系图谱中的边(Edge)代表不同类型的关系——时间关系、因果关系、语义关系。N2 根据查询意图,对这些边进行动态加权。
比如问"为什么会下雨"时,因果边的代价被降低,系统优先沿因果路径扩展;问"上周发生了什么"时,时间边的权重提升。同样是走一条路,但根据目的地不同,选择的路线完全不同。
找到候选证据后,N3 负责最重要的一步:用一次 LLM 调用对候选集进行重排序和压缩。
具体来说,系统把所有候选证据打包发给 LLM,让它判断哪些是最相关、最有价值的,然后输出一个精简版的答案上下文(Answer-side Context)。这一步大幅减少了最终送往答案模型的 token 数量。
消融实验表明,移除 N3 模块后,ER@5 指标下降 6.8 个百分点,上下文 token 数量几乎翻倍(从 2,023 → 4,108)。这是整个系统中最关键的一个杠杆。
这是一个聪明的"分流器"。系统首先用零 LLM 成本的方式(关键词匹配、语义原型匹配)尝试处理大多数简单查询——这些查询根本不需要调用 LLM。只有当简单方法无法处理时,才降级到 LLM 分类器。
实测中,N4 可以消除 42.3% 的分类端 LLM 调用,且对准确率没有可测量的影响。
PRISM 在 LoCoMo(Long-Context Memory)基准上进行了测试,包含 1,540 个 QA 对,覆盖多跳推理、时间推理、开放域和单跳四种类型。
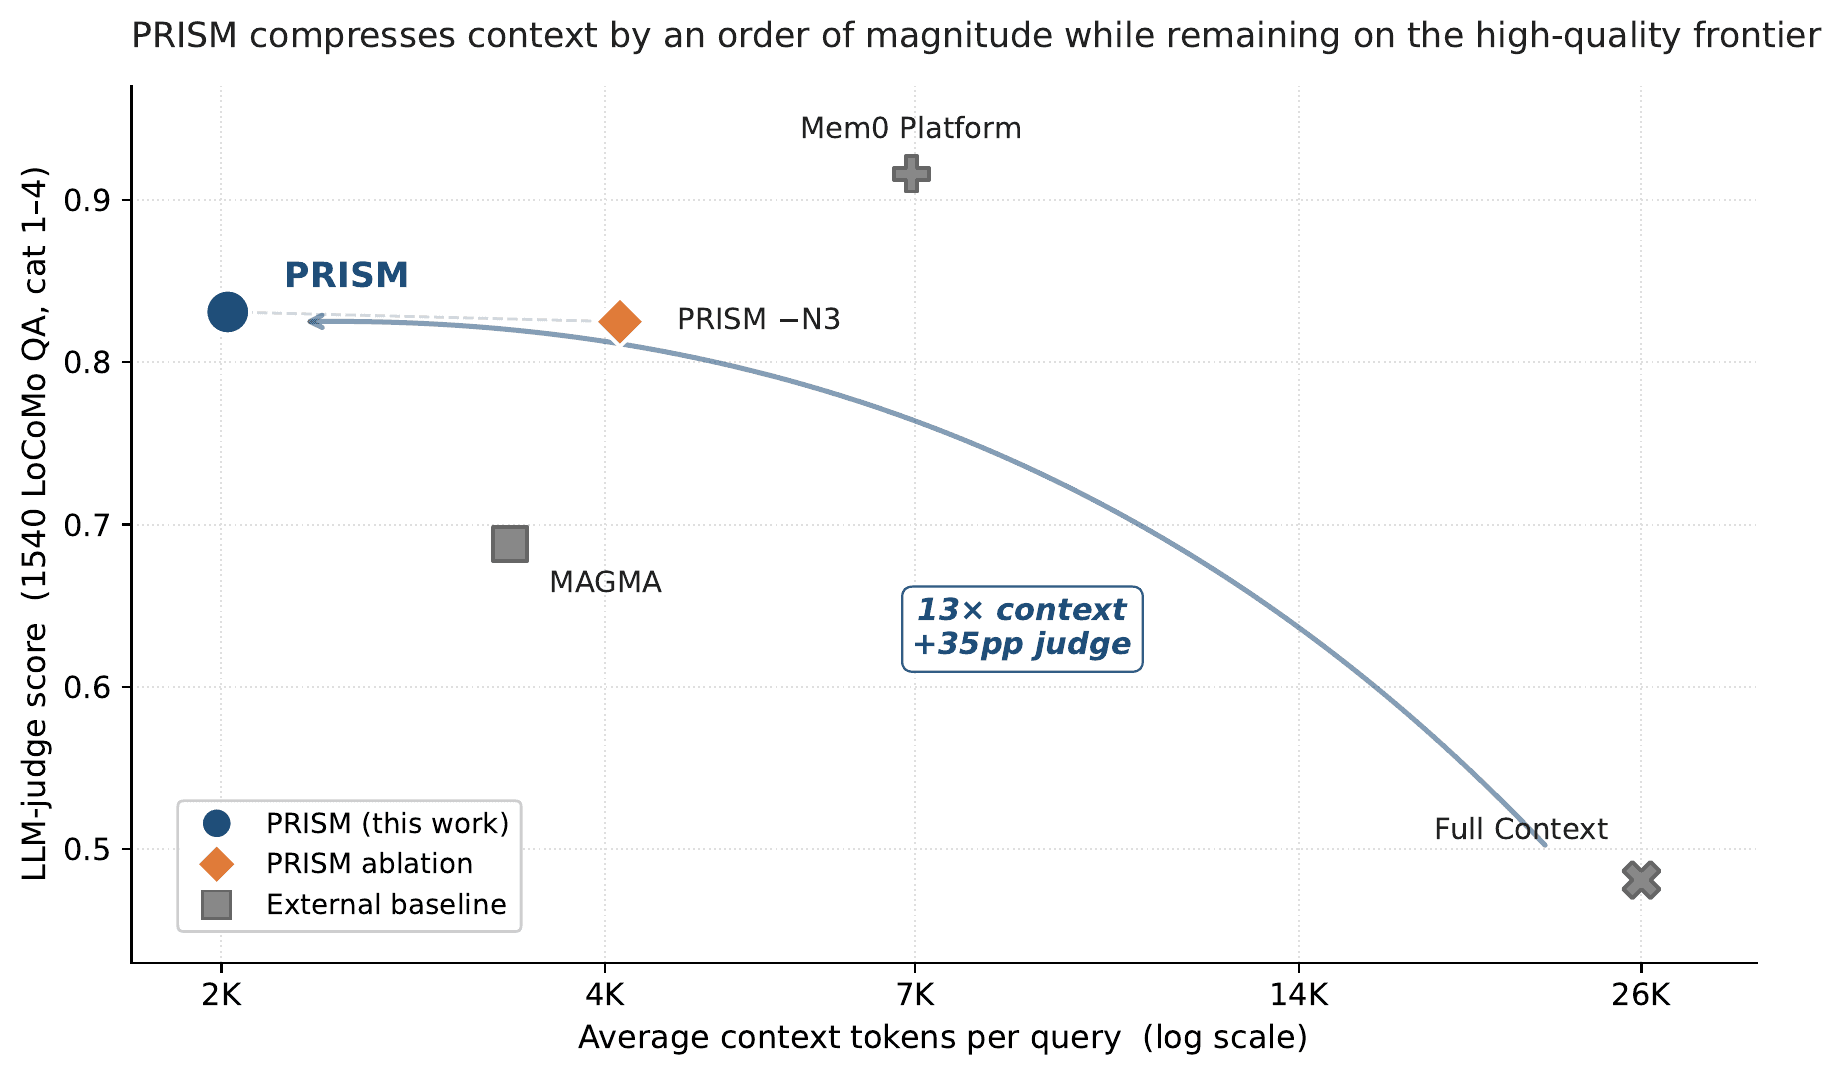
关键结果(使用相同的 gpt-4o-mini 作为答案模型和评判模型):
| 方法 | 总体准确率 | 每千 token 效率 | 上下文 token 数 |
|---|---|---|---|
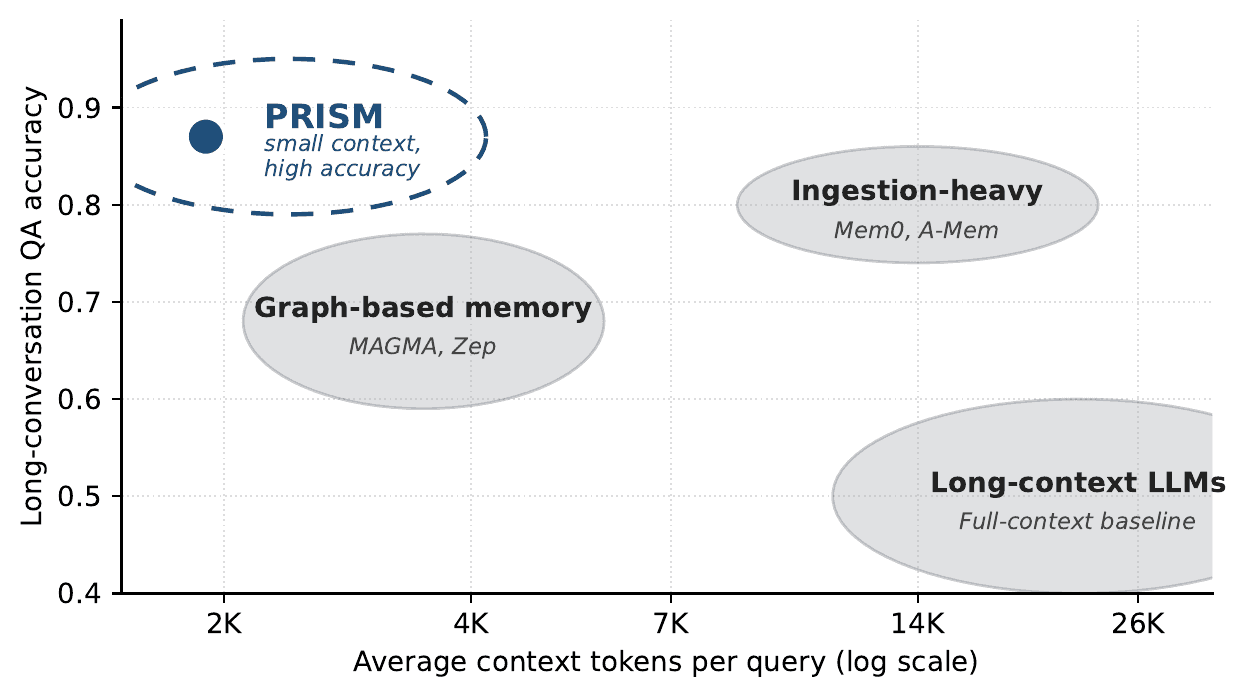
| Full Context(全塞入) | 48.1% | 0.018 | 26,031 |
| MAGMA | 68.8% | 0.204 | 3,370 |
| Mem0 | 66.9% | 0.379 | 1,764 |
| PRISM | 83.1% | 0.411 | 2,023 |
PRISM 的总体准确率达到 83.1%,比次优方法 Mem0 高出 14.2 个百分点;同时,它的每千 token 效率(0.411)也是所有方法中最高的。
对比全塞入(Full Context)方案,PRISM 实现了 13 倍的上下文压缩(从约 26K token 压缩到约 2K token),同时准确率反而提升了 35 个百分点。
如果把答案模型换成更强的 GPT-5.5,PRISM 的准确率进一步提升到 89.1%,效率达到 0.440——而上下文 token 数完全不增加。
PRISM 的 Python 包名为 mmem(Multi-level Memory),代码结构清晰:
核心依赖:faiss-cpu、sentence-transformers(all-MiniLM-L6-v2,384维)、openai、networkx、pydantic。
值得强调的是:PRISM 完全 CPU 运行,不需要 GPU。所有向量检索(FAISS IndexFlatIP)和图遍历都是 CPU 操作,大幅降低了部署门槛。
git clone https://github.com/jingyip-cat/PRISM.git
cd PRISM
python -m venv .venv && source .venv/bin/activate
pip install -r requirements.txt
cp .env.example .env  # 填入 OPENAI_API_KEY

# 离线冒烟测试(无需 API key)
python scripts/smoke_test_alice.py

# 完整 LoCoMo 评测
PYTHONHASHSEED=0 python -m scripts.eval.run_locomo --mode full
注意:PYTHONHASHSEED=0 是必须设置的环境变量。
1. 强依赖 LLM 作为抽取器:写入时需要用 LLM 从对话历史中抽取结构化信息,对 API 质量有依赖。
2. 只支持已有图谱检索:PRISM 假设已有构建好的图谱记忆,从零开始需要配合其他 ingestion pipeline。
3. 评测基准局限性:LoCoMo 中 73.4% 的问题属于"锚点可发现"类型,多跳复杂场景效果尚未充分验证。
4. 记忆漂移风险:长期运行后图谱可能积累过时或错误信息,需要额外维护。
PRISM 的核心贡献,是一种范式转变:将记忆管理从"尽可能塞入更多上下文"的蛮力思维,转变为"精确召回最优证据集合"的智能思维。它的四个模块(N1-N4)是正交的,可以单独启用或组合使用,给了实践者很大的灵活性。
更重要的是,PRISM 证明了准确率和效率可以同时提升,而不是必须二选一。这个结论对整个 Agent memory 领域都有启发意义。
随着 LLM Agent 在企业场景的落地,长程记忆管理将成为决定用户体验的核心能力。PRISM 为这个方向提供了一个有竞争力的开源方案,值得关注。