
OnnxOCR
jingsongliujing/OnnxOCR加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你所在的公司需要在一批国产服务器上批量部署 OCR 识别服务。这些服务器跑的是 ARM 架构,CUDA 版本混乱,运维团队每次安装 PaddlePaddle 都像在拆盲盒——依赖冲突、编译报错、GPU 适配焦头烂额。项目进度卡在环境配置上,一周过去了连 demo 都跑不起来。
这就是许多团队在生产环境中使用 PaddleOCR 时面临的真实困境:训练框架太重、部署依赖复杂、跨平台支持差。OnnxOCR 正是为解决这个痛点而生——它将 PaddleOCR 训练好的模型转换为 ONNX 格式,彻底摆脱 PaddlePaddle 运行时,用 ONNXRuntime 取而代之,在任何能跑 Python 的环境下实现"拿来即用"。
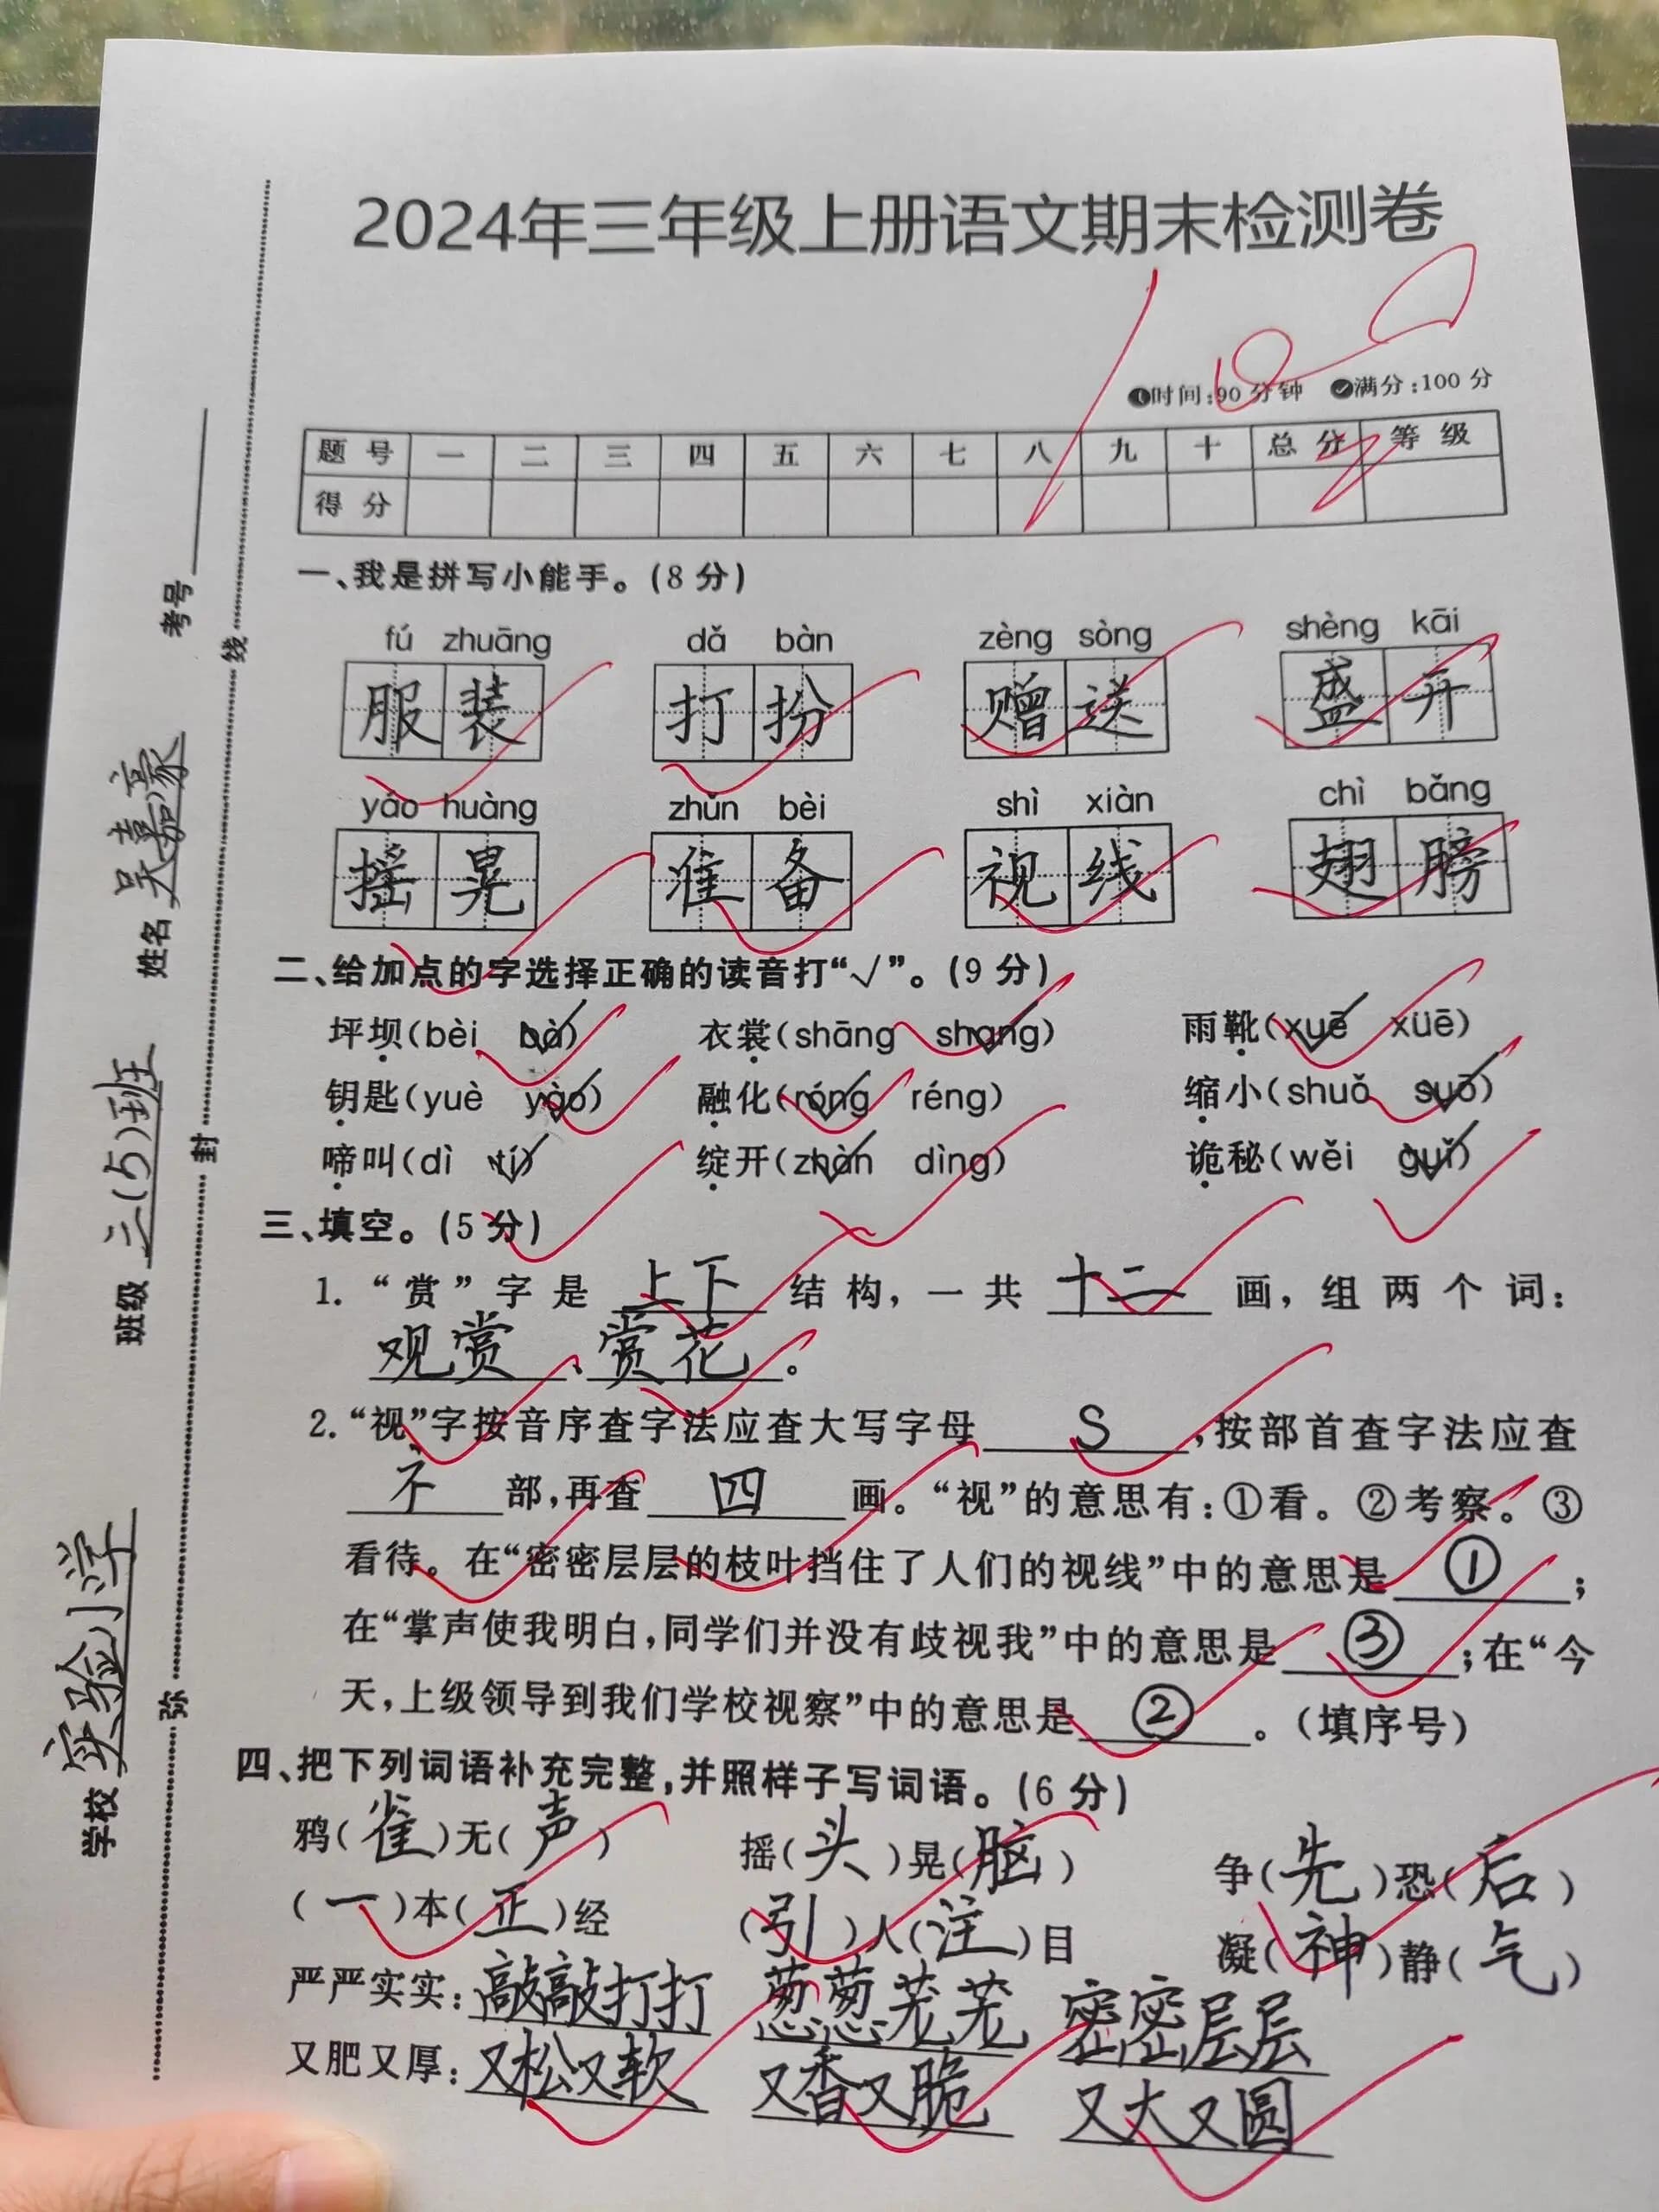 通用 OCR 对复杂文档的识别效果(来源:项目测试图片)
OnnxOCR 的核心思路非常清晰——不做训练,只做推理。
项目作者 jingsongliujing 基于 PaddleOCR 训练好的模型,通过 paddle2onnx 工具将模型导出为 ONNX 格式,然后围绕 ONNXRuntime 构建完整的推理工程。这意味着:
项目最早可追溯到 2023 年,随着 PP-OCRv4(2024)和 PP-OCRv5(2025)的发布持续跟进,最新版已支持 PP-OCRv5,在简体中文、繁体中文、中文拼音、英文、日文五类文字上实现了精度提升。2026 年 5 月,项目新增了 Qwen3.5-2B ONNX 信息抽取能力,OCR 识别结果可直接交给本地 LLM 抽取结构化字段(如身份证号、发票金额等),打通了从"图片→文字→结构化数据"的完整链路。
通用文字识别是项目的核心。使用方式极其简洁:
from onnxocr.onnx_paddleocr import ONNXPaddleOcr
ocr = ONNXPaddleOcr(use_angle_cls=False, use_gpu=False)
result = ocr.ocr(img)
背后运行的是 PP-OCRv5 检测+识别模型,默认模型约 10MB(通用版),足以应对印刷体文档、名片、截图等常见场景。如需更高精度,可替换为 PP-OCRv5 Server 版模型。
集成车牌检测和车牌号识别两个 ONNX 模型,只需一行代码开启:
plate_model = ONNXPaddleOcr(use_plate_recognition=True, plate_min_score=0.4)
适用于停车场管理、违章识别、道路监控等场景。
基于 RapidTable 的表格结构还原能力,输出 HTML 表格和单元格坐标:
table_model = ONNXPaddleOcr(use_table_recognition=True, table_model_type="slanet_plus")
table_result = table_model.ocr(img)
print(table_result["html"])  # 输出 HTML 表格
基于 RapidLayout 识别文档中的标题、正文、表格、图片等区域:
layout_model = ONNXPaddleOcr(use_layout_analysis=True, layout_model_type="pp_layout_cdla")
支持中英文两种版面模型(CDLA 用于中文文档,PubLayNet 用于英文文档)。
基于 RapidDoc,根据版面分析结果将 PDF 或图片转换为 Markdown 文件,保留标题层级、段落、表格等结构:
converter = LayoutMarkdownConverter(layout_model_type="pp_doclayoutv2")
result = converter.convert_file("input.pdf", output_md_path="output.md")
对于需要将大量历史文档数字化存档的企业,这是一项非常实用的功能。
这是 2026 年新增的最具想象力的能力。OCR 识别结果交给本地 Qwen3.5-2B ONNX 模型,由 LLM 抽取结构化字段:
from onnxocr.qwen35_2b import QwenScenarioExtractor, ExtractionTemplate

invoice_template = ExtractionTemplate(
    name="invoice_basic",
    fields=["发票号码", "销售方", "购买方", "价税合计", "开票日期"],
    rules=["只根据 OCR 文本抽取,不要编造。", "缺失字段填空字符串。"]
)
extractor = QwenScenarioExtractor(model_dir="onnxocr/models/qwen_2b")
fields, raw = extractor.extract(ocr_text, template=invoice_template)
用户可通过定义 ExtractionTemplate 扩展发票、营业执照、合同、快递面单、医疗报告等垂直场景。项目提供了一个身份证识别的完整端到端示例(examples/id_card_extract_with_qwen.py),下载 Qwen3.5-2B ONNX 模型后直接运行即可。
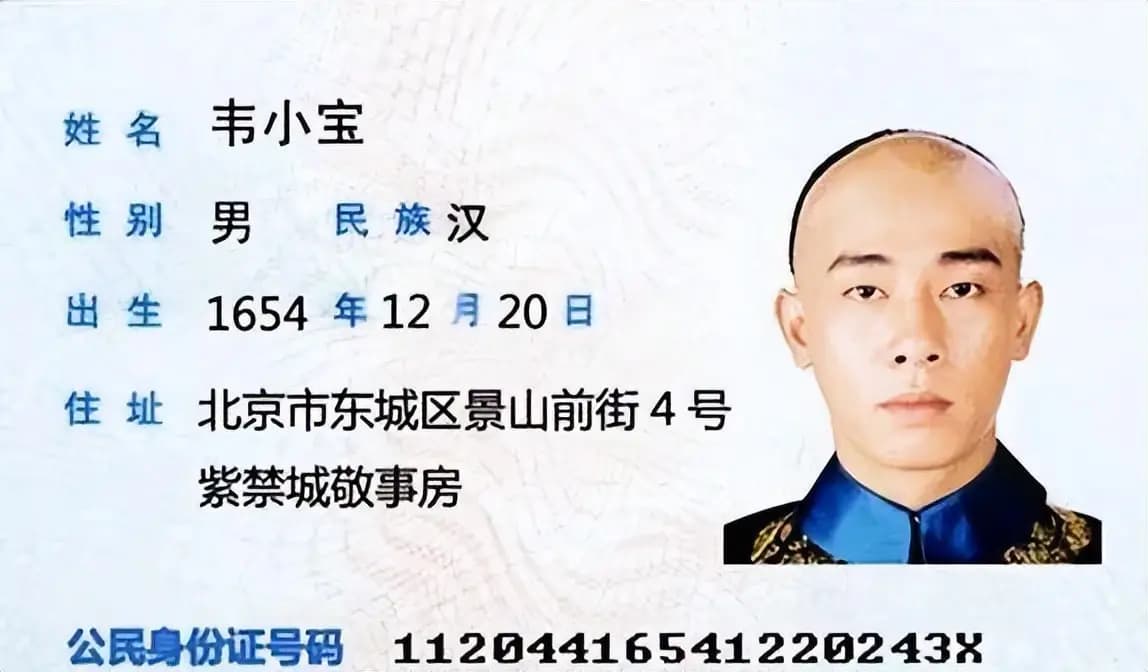 身份证正反面 OCR 识别与结构化字段抽取(来源:项目测试图片)
OnnxOCR 的代码组织体现了良好的工程设计:
onnxocr/
├── inference_engine.py      # 统一 ONNXRuntime Session 管理(核心)
├── onnx_paddleocr.py        # 主入口,ONNXPaddleOcr 类
├── predict_det.py           # 文字检测推理
├── predict_rec.py           # 文字识别推理
├── predict_cls.py           # 方向分类
├── db_postprocess.py        # 检测后处理(DBNet 概率图转文字框)
├── rec_postprocess.py        # 识别后处理(CTC 解码)
├── layout_recognition.py    # 版面分析
├── table_recognition.py     # 表格识别
├── layout_markdown.py       # 文档转 Markdown
├── rapid_layout/            # RapidLayout ONNX 模型推理
├── rapid_table/             # RapidTable ONNX 模型推理
├── rapid_doc/               # RapidDoc 模型
├── models/                  # ONNX 模型文件(ppocrv5/, license_plate/, table/, layout/, qwen_2b/)
└── qwen35_2b/               # Qwen3.5-2B ONNX 推理封装
统一推理引擎是架构的核心设计——所有 ONNX 模型(文字检测、文字识别、方向分类、车牌、表格、版面分析、Qwen LLM)统一通过 inference_engine.py 创建 ONNXRuntime Session,国产化适配时只需修改这一个文件即可切换推理后端(GPU/NPU)。
Web 服务层通过 app-service.py 提供 HTTP 接口,涵盖 /ocr、/plate、/table、/layout、/layout_markdown 等端点,满足 API 集成需求。webui.py 则基于 Flask 提供 Web 界面,适合无 CLI 经验的用户快速体验。
项目提供官方 Dockerfile,基于 python:3.10-slim,一行构建运行:
docker build -t onnxocr .
docker run -p 5005:5005 onnxocr
镜像约 2-3GB(包含所有模型后体积更大),CPU 推理无需 GPU。
pip install -r requirements.txt  # 推荐使用清华镜像
python scripts/download_models.py  # 下载 ONNX 模型(国内优先 ModelScope)
python test_ocr.py                 # 一键运行通用 OCR
requirements 约 30+ 依赖,主要包括:
扩展模型(车牌、表格、版面分析、Qwen LLM)需要额外下载,ModelScope 优先,国内网络友好,总体积约 1-3GB。
| 规格 | 要求 |
|---|---|
| CPU | 任意 x86/ARM,支持 AVX2 加速效果更佳 |
| GPU | 可选,ONNXRuntime GPU 版本支持 CUDA 加速 |
| 内存 | CPU 推理 512MB+;含 Qwen LLM 需 8GB+ |
| 存储 | 代码 50MB;PP-OCRv5 模型 10-50MB;扩展模型 1-3GB |
| 维度 | 评分 | 说明 |
|---|---|---|
| 代码质量 | 8/10 | 模块化清晰,inference_engine.py 统一管理推理入口;但部分文件(如 postprocess)逻辑较密集,缺少单元测试 |
| 文档质量 | 9/10 | 中英日三语 README,详尽的 API 示例,常见坑(模型下载、GPU 版本安装)均有说明 |
| 活跃度 | 8/10 | 2026.05 刚更新 PP-OCRv5 + Qwen3.5-2B 功能,commit 持续活跃 |
| 生产就绪 | 7/10 | 有 Dockerfile、Web API、错误处理;但无 docker-compose,容器编排需自行处理 |
| 可扩展性 | 9/10 | ExtractionTemplate 设计优雅,用户可低成本扩展新场景 |
主要局限:
OnnxOCR 的价值不在于算法创新,而在于工程化落地。在它出现之前,将 PaddleOCR 部署到非 NVIDIA GPU(如华为 NPU、寒武纪、瑞芯微)或 ARM 嵌入式设备上,是一件极费周折的事。OnnxOCR 用 ONNX 中间格式作为"桥梁",让训练和部署解耦——训练用飞浆,推理用 ONNXRuntime,两端独立演进。
从行业趋势看,端侧 OCR + 本地 LLM 结构化抽取正在成为文档数字化的主流范式。OnnxOCR 率先将这条路走通:PP-OCRv5 做文字识别 → Qwen3.5-2B ONNX 做信息抽取,两步都在本地完成,无需调用云端 API,数据不出本地,在金融、医疗、政务等强数据安全要求的场景中具有独特价值。
python test_ocr.py,无需下载额外模型,3 分钟看效果docker build . && docker run -p 5005:5005,服务器部署首选python scripts/download_models.py,再取消 test_ocr.py 中对应行的注释python examples/id_card_extract_with_qwen.pyExtractionTemplate 用法,在应用中扩展发票、合同等模板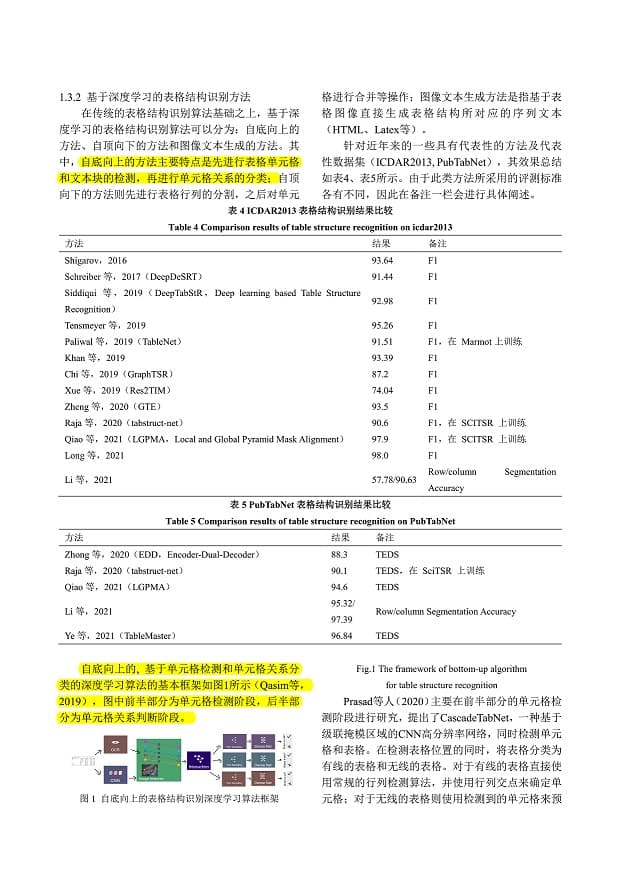 版面分析识别标题、正文、表格、段落等区域(来源:项目测试图片)
