
jax
jax-ml/jax加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2020年,Google Research 的一个团队发布了一个名为 JAX 的 Python 库。它的开篇介绍非常朴素:「Composable transformations of Python+NumPy programs: differentiate, vectorize, JIT to GPU/TPU, and more」。
这句话听起来平淡无奇——不就是给 NumPy 加点自动微分功能吗?但如果你真正理解 JAX 的设计哲学,就会发现它的野心远比表面看起来要大:JAX 想要成为数学函数变换的"乐高积木",让研究者和工程师能够像搭积木一样,自由组合自动微分、JIT 编译、向量化等变换,构建出前所未有的数值计算流水线。
这个项目在 Google 内部迅速扩散——AlphaFold 团队用它实现了蛋白质结构预测的极致并行化;JaxMD 团队用它模拟分子动力学;DeepMind 的多支研究团队将它作为默认研究平台。短短几年,JAX 在 GitHub 上积累了超过 36,000 颗星,成为机器学习框架生态中一个不可忽视的存在。
要理解 JAX 的独特之处,我们先来谈谈现有框架的设计思路。
PyTorch 采用命令式编程(imperative programming)模型:每写一行代码,GPU 上发生了什么几乎是"所见即所得"。这种模式对调试极为友好——你可以在任意位置打印中间结果,随时检查梯度是否正确。PyTorch 的动态计算图让它成为学术研究的首选,全世界超过 80% 的顶会论文都基于 PyTorch 实现。
TensorFlow 则走了另一条路——静态图。早期 TensorFlow 要求用户先定义计算图,再提交给 Session 执行。这种设计在生产部署时效率很高,但开发体验糟糕。Keras 的介入和 Eager Execution 的引入大幅改善了这个问题,但 TensorFlow 整体仍偏向"工程化"的架构。
JAX 则剑走偏锋:它本质上不是一个"深度学习框架",而是一个"数值计算变换系统"。 JAX 的 API 几乎与 NumPy 完全一致——如果你会写 NumPy,你就能写 JAX。但 JAX 的魔力在于,它允许你对这些 NumPy 程序施"魔法":
这四个变换可以任意组合叠加。你可以先 jit 再 grad,也可以先 vmap 再 jit。这种可组合性让研究者能够探索传统框架中几乎不可能实现的算法——比如"批量化反向传播的同时进行二阶优化",用 JAX 只需要几行代码。
用生活化的比喻:如果 PyTorch 是一辆拉力赛车(灵活、响应快,适合各种地形),TensorFlow 是一辆特斯拉(自动化程度高,适合高速公路巡航),那么 JAX 就是一辆F1 赛车——速度极快,但需要专业车手才能驾驭。它的优势在于极致性能,代价是学习曲线陡峭,需要较强的数学功底和函数式编程思维。
JAX 的高性能来源于两个关键技术:XLA 编译器和函数式编程模型。
JAX 底层使用 XLA(由 Google 开源的线性代数加速编译器)将 Python+NumPy 代码编译为高度优化的底层代码。在 GPU 上,XLA 可以做跨操作融合(fusion)——传统框架中需要多次显存读写的操作,XLA 可以合并为一次,减少显存带宽压力。在 TPU 上,JAX+XLA 的组合更是达到了接近硬件峰值的计算效率。
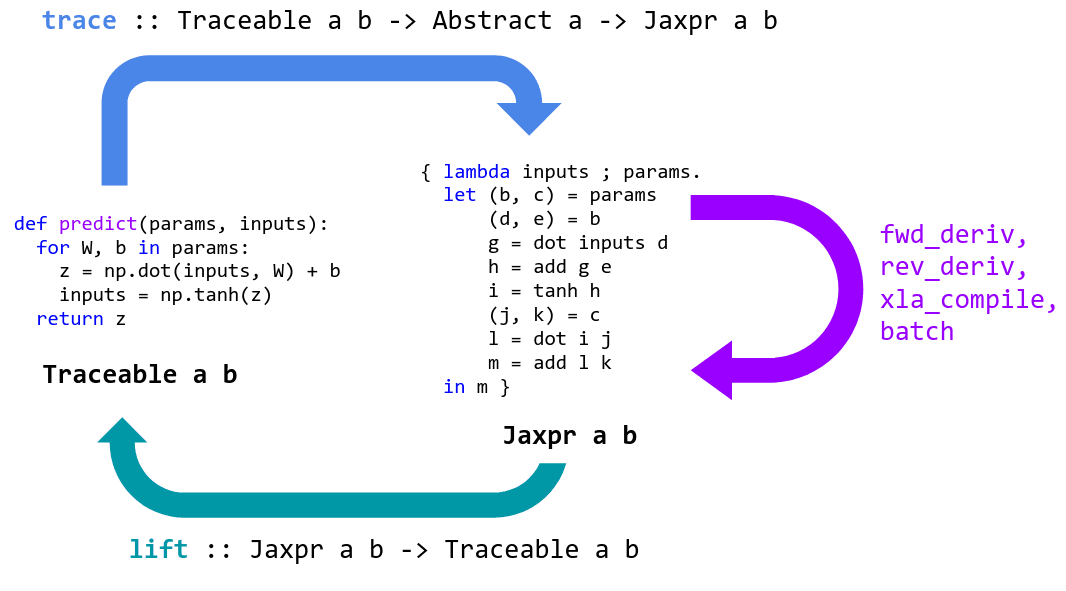
JAX 要求用户尽量编写纯函数(pure functions)——没有全局状态,没有原地修改(in-place mutation)。这个约束初看是负担,实际上是解放:
对于需要可变状态的场景(比如带有 BatchNorm 的模型),JAX 的解决方案是用函数式状态传递(functional state threading):把状态作为参数传入,把新状态作为输出返回。这套模式初学需要适应,但一旦习惯,就能体会到它的优雅。
JAX 本身只负责底层数值计算,上层生态由一系列互补库组成:
| 库名 | 定位 | 作用 |
|---|---|---|
| Flax | 神经网络库 | 提供层、模型、训练循环等高层抽象 |
| Haiku | 神经网络库 | 更轻量,支持 PyTorch 风格的模块定义 |
| Optax | 优化器库 | 提供丰富的一阶/二阶优化器(Adam, SGD, RMSProp 等) |
| Jraph | 图神经网络库 | 处理图结构数据的标准化工具 |
| RLax | 强化学习库 | 强化学习常用算法的 JAX 实现 |
| JAX-Privacy | 隐私机器学习 | 差分隐私训练,2025年 Google 发布 1.0 版本 |
这些库全部基于 JAX 的可组合变换构建,本身也完全支持 jax.jit 和 jax.vmap。用户可以根据需求自由组合——不需要整个 Flax,只需要一个优化器?直接用 Optax;需要图神经网络?Jraph 可以无缝嵌入。
JAX 是一款纯编程库,没有 Web-UI 界面。初次接触的用户需要通过 pip 安装:
# CPU 版本(最简单)
pip install jax

# NVIDIA GPU 版本(需要 CUDA 12+ 和 cuDNN)
pip install jax[cuda12_pip]

# Google TPU 版本
pip install jax[tpu]
安装本身非常直接,但真正的挑战在于使用方式。JAX 要求开发者具备以下能力:
好消息是,JAX 的入门门槛虽然高于 PyTorch,但入门后的天花板也更高。一旦掌握 jit+grad+vmap 的组合技巧,很多在 PyTorch 中需要复杂工程技巧才能实现的优化,在 JAX 中变得极为简洁。
JAX 不是银弹,以下场景可能不适合选择 JAX:
1. 生产部署复杂 PyTorch 有 TorchServe,TensorFlow 有 TFX,而 JAX 的生产部署生态相对薄弱。Google 内部有 Cloud TPU 的深度集成,但面向一般用户的托管服务选择有限。如果你的模型最终需要部署到 Kubernetes 集群或边缘设备,JAX 的配套工具不如 PyTorch 完善。
2. 动态控制流的不对称性
PyTorch 的动态图允许你在 for 循环中随意加入 if 语句,调试器可以停在任意位置。JAX 虽然也支持控制流(lax.cond, lax.scan),但可读性和调试体验不如 PyTorch 自然。
3. 社区规模和资源差距 PyTorch 拥有全球最大的 ML 社区,几乎任何论文都有 PyTorch 实现。JAX 的社区虽然增长迅速,但资源密度仍有差距——遇到问题时,Google 的官方文档是最佳求助渠道,而非 StackOverflow。
4. 差分隐私和量化训练的配套不完善 虽然 JAX-Privacy 在 2025 年发布了 1.0 版本,但与 PyTorch 的 Opacus(差分隐私)和 PyTorch 的量化工具链相比,JAX 的隐私保护工具链仍处于追赶阶段。
如果用一句话总结 2025 年 ML 框架的格局:PyTorch 主宰学术研究,TensorFlow 占据生产部署,JAX 正在成为前沿研究的新标配。
这个判断来自多个维度的数据:Google DeepMind 的核心研究成果(AlphaFold 2、AlphaCode、AlphaTensor)几乎全部基于 JAX;过去两年顶会论文中 JAX 的使用率显著上升;越来越多工业界团队开始将 JAX 用于大规模科学计算(气候模拟、药物发现、金融建模)。
JAX 的崛起也代表了 ML 框架的一种趋势:从"大而全的框架"转向"可组合的基础设施"。JAX 不试图提供所有功能,而是把底层变换做到极致,让社区在上层自由构建。这与 Unix 的设计哲学——"做一件事,做到极致"——不谋而合。
JAX 是一个面向有追求的研究者和追求极致性能工程师的工具。它不是最容易上手的框架,但它的设计哲学——函数式、可组合、硬件感知——恰好契合了当前大模型时代对数值计算的新需求。
如果你正在进行大规模训练、科学模拟或需要探索全新的算法架构,JAX 值得你花时间学习;如果你需要一个快速原型工具或依赖丰富的社区资源,PyTorch 仍是更稳妥的选择。
框架的选择从来没有绝对的优劣,只有适合与不适合。JAX 的出现让这场讨论多了一个值得认真考虑的选项。
