加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你接手了一家跨境电商的客服系统。每天涌入几万张工单:「鞋子晚了两周到货,尺码还不对,另外我看到卡上被扣了两次款。」
你需要的不是一篇描述这个工单的作文,而是三个可以直接进代码的答案:
传统做法是调一个大模型,让它「分析一下」。但这类任务有个尴尬特性:它的正确答案天生带概率。分给退换货的概率是 0.47,账务 0.25,物流 0.28——三档都不高,说明这条该让人过目,而不是自动路由。可如果换成只输出一个标签的分类器,这个「不确定」的信息就被抹掉了,你只能拿到一个自信的、可能错的答案。
TypeSafe 商业化的 Jev 模型正是干这个的:输入文本 + 一组结构化问题,输出每个问题的概率分布。效果很好,但它是闭源托管服务——数据出你的机房,每百万输入 token 计费,模型权重和训练方法你永远拿不到。
2026 年 9 月 17 日,TypeScript 生态知名作者 Jared Palmer(也是 TypeSafe 生态里活跃的独立开发者)把这件事做了个开源版本:Kev。
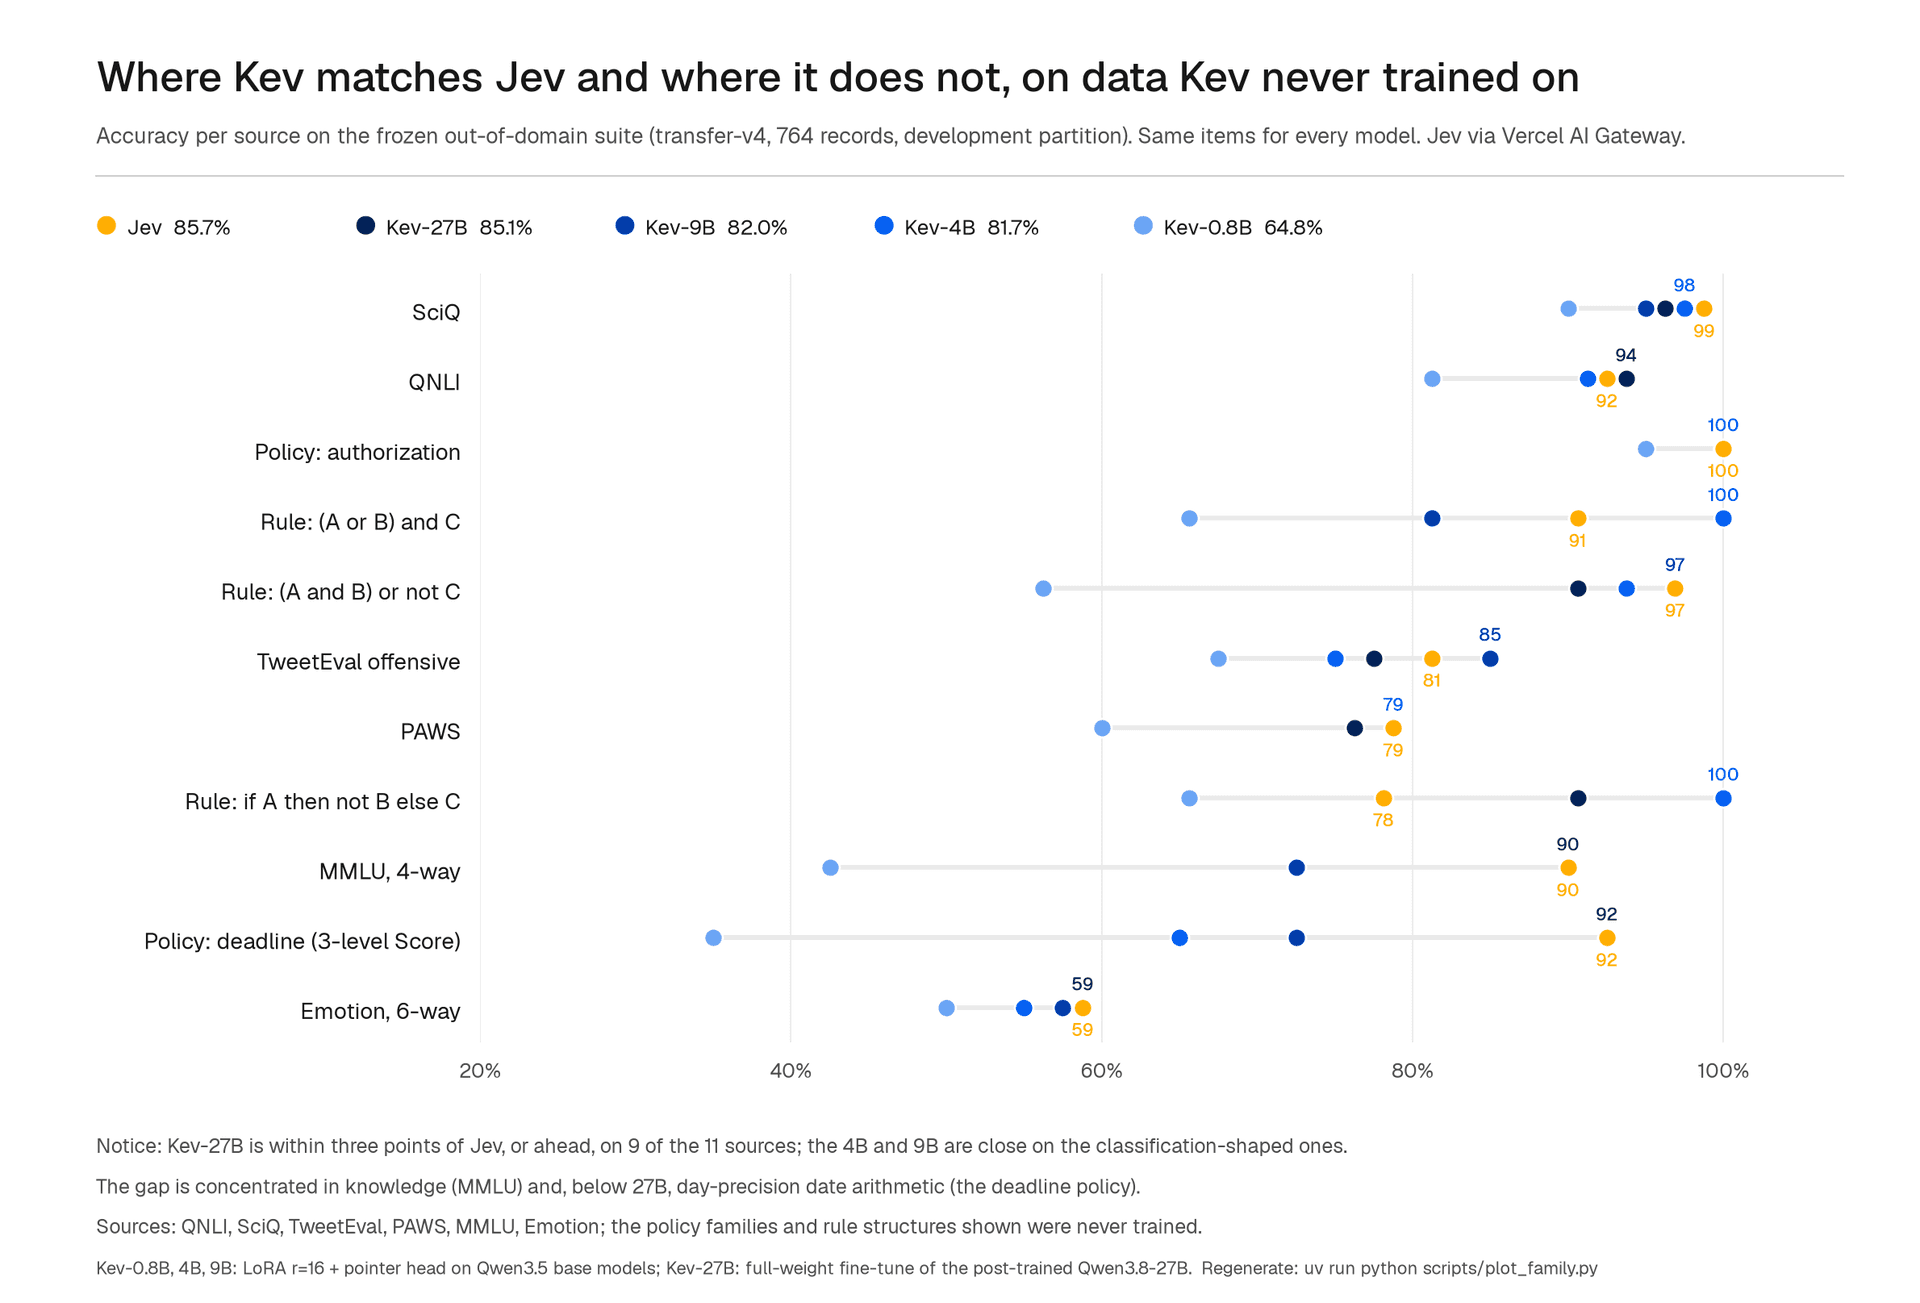
图:Kev 1.0 的四个尺寸,0.8B / 4B / 9B / 27B,基座分别为 Qwen3.5 与 Qwen3.8
Kev 的架构来源是一篇公开文章——《Jev's Architecture Unmasked》(作者 Archer Hume)。作者通过分析 TypeSafe 客户端与 Jev 服务之间的交互,反推出了 Jev 的关键设计:一个冻结基座模型 + 轻量适配器 + 指针头(pointer head)。
这和「用大模型直接生成 JSON」的思路有本质区别。以 Kev-4B 为例,它的具体形态是:
推理时的文本排布是这样的:
<state> …文档内容…
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
<q> instructions <opt> option 1 </opt> <opt> option 2 </opt> … <decide>
关键设计是问题隔离:每个问题只能读到状态和自己的选项,读不到别的问题。指针头拿每个选项 </opt> 的隐状态,去和该问题 <decide> 的隐状态做打分,softmax 得到概率。
这里有个容易被忽略的工程细节:Qwen3.5/3.8 是混合架构,注意力层与 Gated DeltaNet 递归层混用,而递归层无视 attention mask。所以 Kev 不靠 mask 实现隔离,而是让每个问题跑成独立的一行,行间完全独立,隔离是精确的。服务端会算一次状态、复用 KV cache 给所有行,因此加问题不会线性增加开销。
类比一下:传统大模型像一个读过整本卷子的考生,你问它「这道题选 A 还是 B」,它得把题目重读一遍。而 Kev 像一个手电筒,只能照亮卷子上你要的那一小块区域——同一份卷子,多个手电筒可以同时照不同段落,效率高得多,答案之间也不会互相干扰。
Kev 1.0 一次性发布四个尺寸,共享同一套评测和卡片:
| 模型 | 基座 | 显存需求 | 验证上下文 | 新来源准确率(dev/test) |
|---|---|---|---|---|
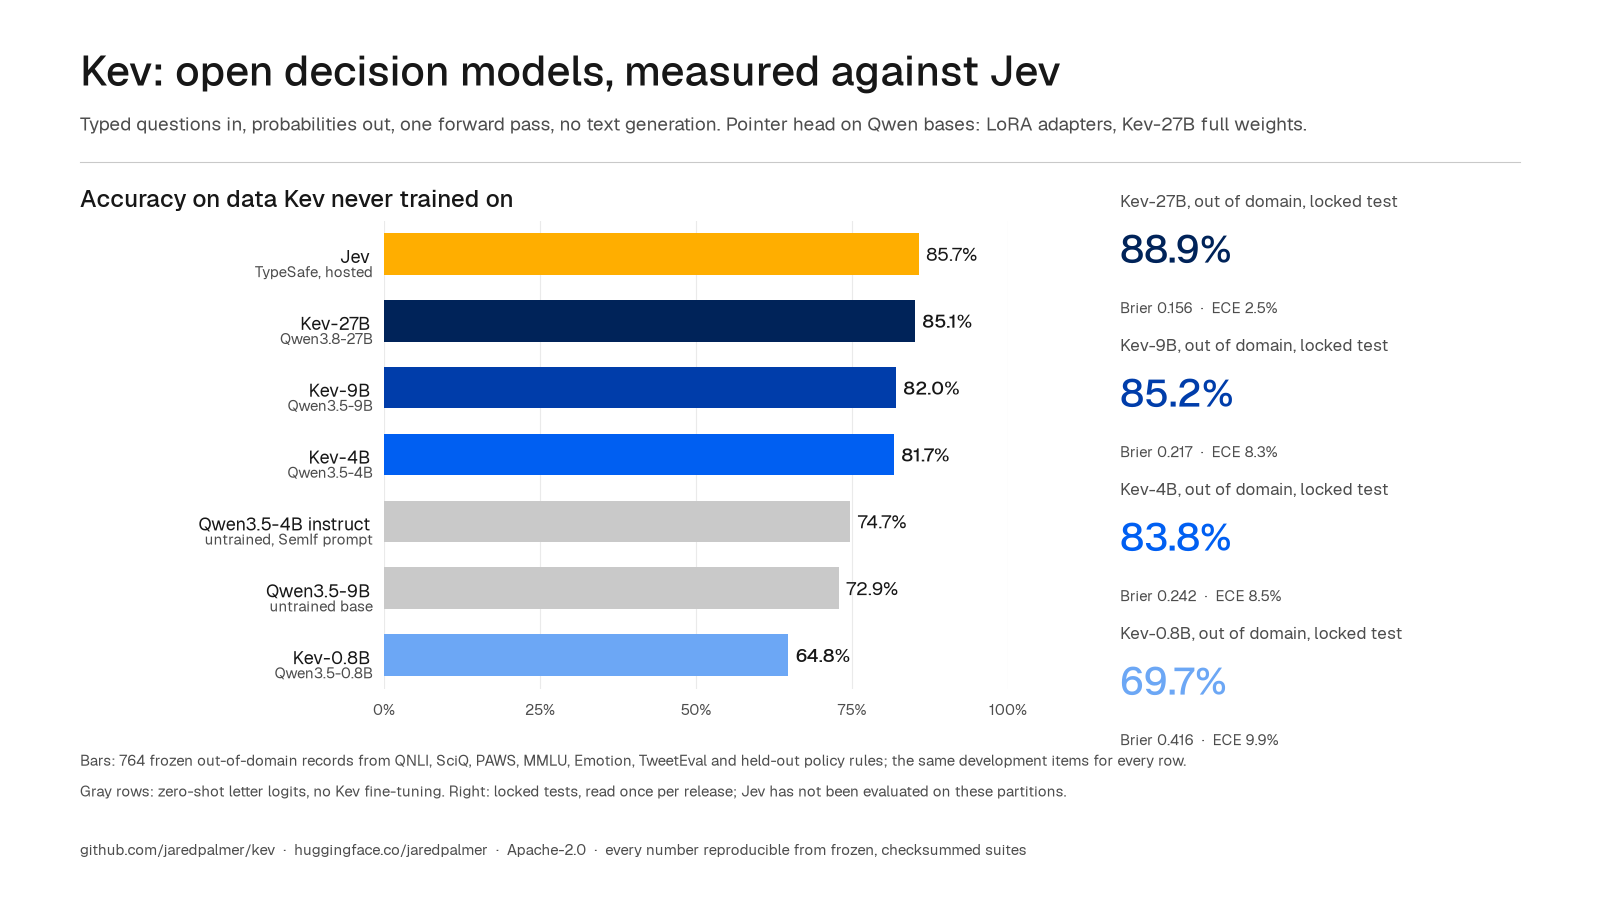
| Kev-0.8B | Qwen3.5-0.8B-Base | 任意 4GB 显卡 / 任意 Apple Silicon Mac | 8,192 | 0.648 / 0.697 |
| Kev-4B | Qwen3.5-4B-Base | L40S / H100;32GB Mac | 8,192 | 0.817 / 0.838 |
| Kev-9B | Qwen3.5-9B-Base | L40S / H100;32GB Mac | 8,192 | 0.820 / 0.852 |
| Kev-27B | Qwen3.8-27B(后训练版,全参数微调) | B200/H200/H100 80GB | 65,536 | 0.851 / 0.889 |
作为参照,闭源的 Jev 在同一套「社区决策指数」上得分 54.0,Kev-27B 是 52.3——差距在 2 分以内,而 4B 和 9B 落后约 4 分。作者自己也提醒:这不是严格的对照实验,因为没人知道 Jev 训练用了什么数据。
图:不同尺寸在「已训练来源」与「新来源」上的准确率与 Brier 分数
如果你打算把 Kev 接进自动路由,「模型自信但错」是最贵的失败模式。Kev 在这点上做了硬功夫:每个 checkpoint 都随附一个拟合好的温度(Kev-0.8B 是 2.35,4B 是 2.41,9B 是 2.19,27B 是 1.32),加载时由指针头施加。
温度不会改变哪个答案胜出,但会显著改变概率的可信程度。在新来源上,它把 Kev-9B 的校准误差从 0.103 降到 0.041,把「自信的错误」(概率 ≥ 0.9 但答错)从 8.2% 降到 2.4%——低于 Jev 的 3.7%。
此外还有个细节:4B 和 9B 的概率按声明的选项顺序索引,选项越多越容易出现偏置。作者提供了 /v1/systemone/permute 端点,可以对同一问题做选项顺序置换(最多 64 种),用来量化这种偏置。
HuggingFace Space 上有 Kev-4B 和 Kev-0.8B 在线演示,不用装任何东西。
需要 Python 3.12/3.13 和 uv:
git clone https://github.com/jaredpalmer/kev.git && cd kev
uv sync --extra serve
uv run --extra serve python -m kev.serve --run jaredpalmer/kev-4b --port 8009
服务默认绑定 127.0.0.1,暴露 /v1/systemone、/v1/models、/v1/systemone/permute、/v1/systemone/separate 四个端点。超过 65,536 token 的状态会返回 422 并明确报出 token 数,绝不静默截断。
如果你已经在用 TypeSafe 的 Python SDK,改个 base_url 就能接着用,业务代码一行不动——这是 Kev 最有杀伤力的地方。
这是 Kev 相对托管 API 的真正差异化:你可以用自己标注的数据微调。
uv run python -m kev.train --n_per_source 40 --accum 4 --out runs/smoke   # 冒烟测试,约1分钟
uv run python -m kev.train --suite evals/v7/decision-v7 --base Qwen/Qwen3.5-0.8B-Base \
    --epochs 2 --lr 1e-4 --batch 8 --dtype bf16 --p_none_pair 0.25 --device cuda --out runs/kev-0.8b
训练用的基础数据集是 decision-v7:来自十个公开数据集的 10,000 条样本、896 条生成的策略样本、1,680 条来自 60 种生成规则结构的样本。评测套件在 evals/ 下冻结(manifest 记录了版本与文件校验和),测试集需要 --allow-test 才能读,且每个发布模型只读一次。
仓库还自带两个 coding-agent skill:kev-finetune(从找问题到服务结果的完整闭环)和 kev-deploy(一键部署脚本),配合 Modal 可以在 H100 上跑完整个训练研究。
pip install modal==1.5.5 && modal setup
curl -LO https://raw.githubusercontent.com/jaredpalmer/kev/main/skills/kev-deploy/scripts/kev_serve.py
KEV_API_KEY=$(openssl rand -hex 24) modal deploy kev_serve.py
闲置时缩容到零,不花钱;冷启动约 35 秒。
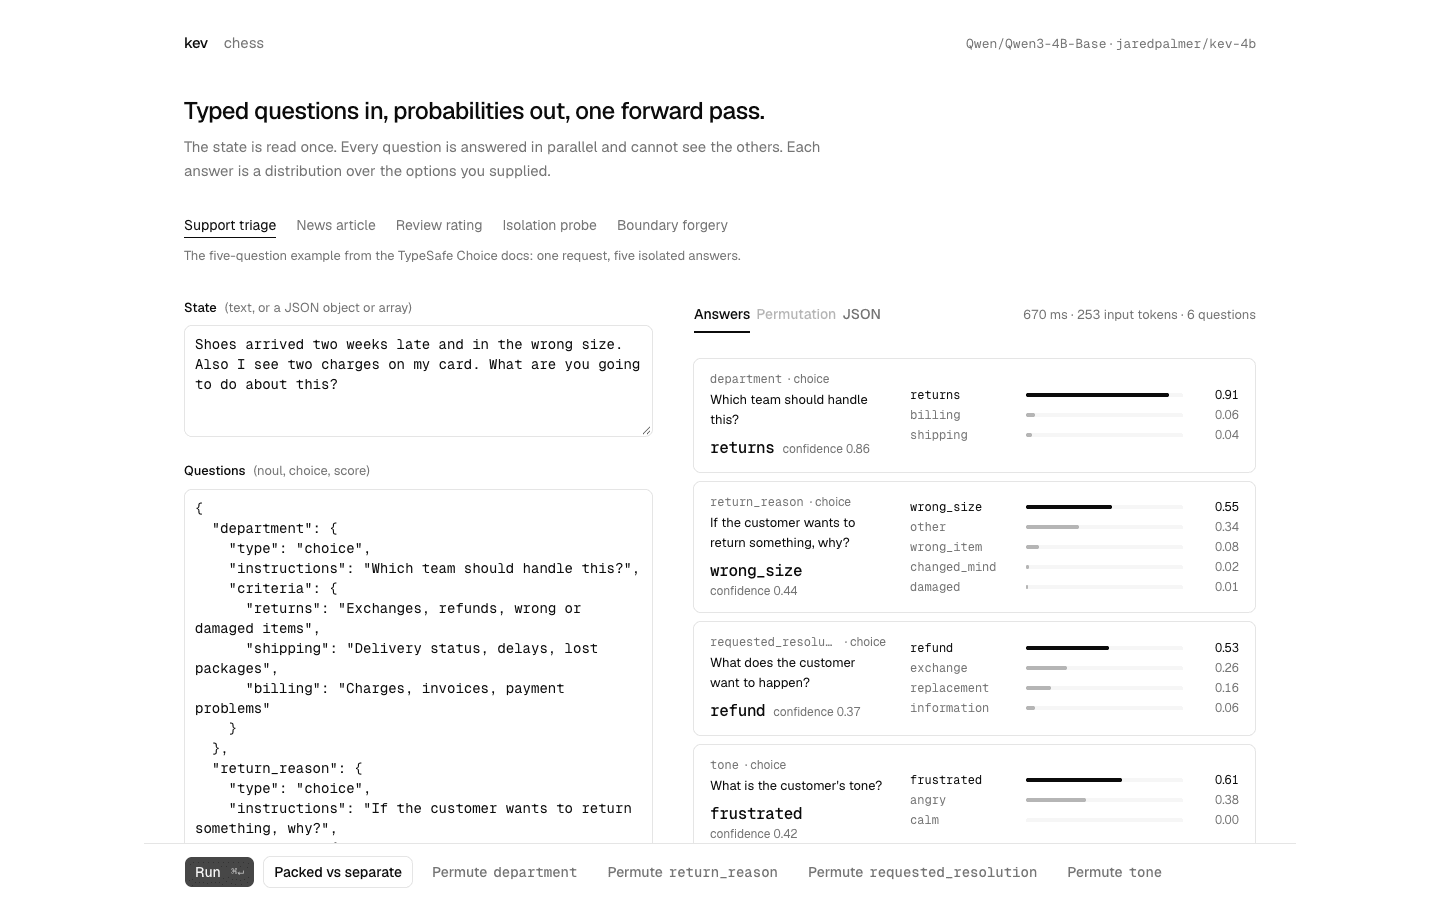
图:仓库内置的 Next.js Playground,可视化试玩决策模型
作者很坦诚,README 的 Limitations 一节把雷点全列了出来:
KEV_DATE_FACTS=1 才能救回来。github.com/jaredpalmer/kev),非公司产品,长期维护性需要自行评估。还有一点要提醒:PyPI 上有同名包。pip install kev 装到的是 2016–2021 年的 K.E.V. ORM,完全不是这个项目——本项目未发布到 PyPI,必须从源码装。
Kev 表面是一个模型项目,实质上踩在三条趋势的交叉点上:
趋势一:专用小模型 vs 通用大模型。 2024 年的 Nemotron、Phi、2025 年的 Flash、Qwen3 的各种蒸馏变体,都在证明「为特定任务训练的小模型」能在特定任务上逼近通用旗舰,且成本低一个数量级。Kev 把这个逻辑推到极致——基座完全冻结,只训一个 rank-16 适配器和一个指针头。
趋势二:决策模型的标准化。 Kev 的 API 直接对齐 TypeSafe 的 System One,已经有至少三个第三方项目(DecGuard、Nucleo 等)把它当作标准 System One 后端接入。这意味着「决策模型」正在形成像 OpenAI Chat Completions 那样的接口事实标准,模型可替换性大幅提升。
趋势三:可本地微调成为选型硬指标。 第三方博客明确指出,选择本地部署 Kev 的首要理由不是省钱,而是不想用别人的模型训练自己的数据。当数据合规成为采购门槛,「权重开放 + 可自训」就从加分项变成了准入项。
Jared Palmer 在博客里写道,Kev 是用 Devin 构建的。整个项目的代码、README、模型卡片、评测报告的工程完整度 unusually 高——4096 行的 AGENTS.md、332KB 的 PLAN.md(逐轮记录实验)、docs/claims.json 里把 README 每一个数字都锁进 CI 校验。这是一个把「科研可复现」当成产品特性来做的小项目。
如果你在做客服工单路由、内容审核、线索分级:Kev-4B 是最务实的起点。它在 32GB Mac 上就能跑,L40S 上 41.5ms 出结果,TypeSafe SDK 直连,不用改架构。
如果你在做需要自己数据的场景:这才是 Kev 真正的价值。用 kev-finetune skill 走完微调闭环,配合冻结的评测套件验证不回归——这套「不回归验证」的基础设施比自己搭省事得多。
如果你要选 27B:先确认你的问题需要 65K 上下文,且你手上有 80GB 显存的卡。51GB 的 bf16 权重不算小,推理时约 66GB 常驻。
如果你完全不需要概率分布:那你可能不需要决策模型,用普通分类器或提示工程更划算。
一句话总结:Kev 把一个原本闭源托管的商业 API(TypeSafe 的 Jev)用 Apache-2.0 的权重和代码完整复刻了出来,并且额外提供了最关键的增量能力——在你自己的数据上微调。它不是最强的决策模型,但在「开源 + 可自训 + 本地部署 + API 兼容」这四项同时满足的组合里,目前几乎找不到第二个选项。