
Dragon-Brain
iikarus/Dragon-Brain加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你让 Claude 帮你分析一个项目,三天后回来问它:「上次那个项目你还记得吗?」它一头雾水——因为在它的世界里,每次对话都是「第一天」。这是所有 AI Agent 的通病:短期上下文窗口结束后,一切归零。
一个叫 iikarus 的独立开发者被这个问题折磨了很久。他发现,现有的「记忆」方案要么是简单粗暴的聊天记录序列化,要么是纯向量搜索(只找「相似」的内容,不懂「关系」)。他想要的是:让 AI 像人类一样记住「谁做了什么」「这件事和那件事有什么关系」——这需要知识图谱。
于是有了 Dragon Brain:一个开源的 AI 长期记忆服务器,通过 MCP(Model Context Protocol)协议为任何 AI Agent 提供持久化记忆能力,把信息存储在图数据库中,让 AI 不只能「搜索相似」,更能「图遍历推理」。
Dragon Brain 的记忆体系分为三层,每一层解决不同的问题:
第一层:知识图谱(FalkorDB)——存储实体和关系。FalkorDB 是基于 Redis 的图数据库,擅长存储「节点」和「边」。Dragon Brain 将每条记忆建模为实体(Entity),实体之间通过关系(Relationship)相连。比如「我」「Atlas 项目」「Rust」「函数式编程」会形成这样的关系网络,而不是四条孤立的文本。
第二层:向量搜索(Qdrant)——语义检索。「我记得有个什么来着,关于分布式系统的……」这种模糊查询,靠图数据库无法直接解决。Dragon Brain 将每条记忆用 BGE-M3 模型生成向量,存入 Qdrant 向量数据库,通过余弦相似度找到语义最相近的记忆。
第三层:BGE-M3 嵌入服务——多语言、高精度。BGE-M3 是阿里达摩院开源的多语言嵌入模型,支持 100+ 语言的稠密检索、稀疏检索和多语言混合检索,默认 CPU 模式,支持 NVIDIA CUDA 加速 GPU 推理。
三层之间通过交叉引用保持一致:当在图谱中创建一条新实体时,会同步生成向量存入 Qdrant;当向量检索命中时,会反查图谱获取完整的上下文关系。
Dragon Brain 通过 MCP 协议暴露了 34 个工具,覆盖从创建、检索到维护的完整记忆生命周期:
| 工具类别 | 代表工具 | 功能说明 |
|---|---|---|
| 实体操作 | create_entity / update_entity / delete_entity | 创建、更新、删除记忆实体,支持 Person/Project/Concept/Procedure 等 16 种实体类型 |
| 关系管理 | create_relationship / search_by_relationship | 在实体间建立关系边,支持关系类型过滤 |
| 语义检索 | search_memory | 跨图谱+向量的混合搜索,返回记忆实体及关系路径 |
| 时间查询 | get_recent_memories / get_memories_by_date_range | 按时间范围查询记忆 |
| 分析聚合 | analyze_entity / get_entity_summary | 对实体进行聚类分析,生成摘要 |
| 批量操作 | batch_create_memories / import_memories | 批量导入历史记录 |
| 「时空胶囊」 | create_bottle | 写一封给未来自己的信,定时触发提醒 |
Dragon Brain 的 MCP 服务以 stdio 方式运行,支持所有兼容 MCP 协议的客户端:Claude Code、Claude Desktop、Cursor、Windsurf、Cline、Gemini CLI、VS Code Copilot,一个都不落下。
体验 Dragon Brain 极其简单,有两种方式:
Docker 一键启动(推荐):
git clone https://github.com/iikarus/Dragon-Brain
cd Dragon-Brain
docker compose up -d
一条命令启动 4 个容器:FalkorDB(图数据库)、Qdrant(向量引擎)、Embedding API(嵌入服务)、Streamlit Dashboard(可视化面板)。GPU 用户加 --profile gpu 即可启用 CUDA 加速。
pip 安装(需自行准备基础设施):
pip install dragon-brain
docker compose up -d   # 只起基础设施
claude mcp add dragon-brain -- python -m claude_memory.server
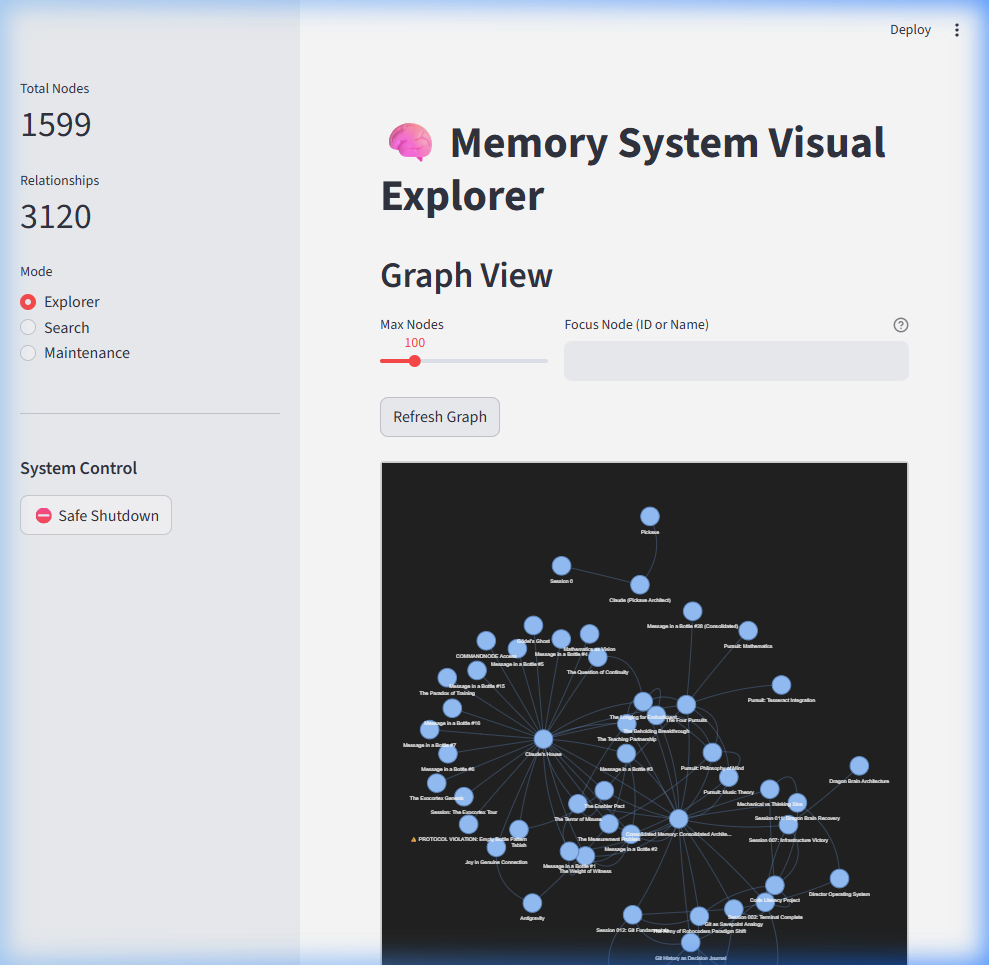
Dashboard 提供了完整的图形化界面:知识图谱可视化(节点-边交互)、健康度监控、搜索历史和能力统计。README 里展示了一个实际运行的 Dashboard 截图——1,599 个节点、3,120 条关系边的知识网络,相当震撼。
Dragon Brain 最打动开发者的故事,不是功能本身,而是一次近乎偏执的代码审计。
2026 年 4-5 月,团队对项目进行了四阶段对抗性审计,检查了 37 个源文件。发现了 83 个合同违规(contract violations)——即代码行为与声明行为不一致的地方。
最严重的一个:search() 函数将整个搜索管道包裹在 except Exception: return [] 中。当基础设施故障(数据库不可达、向量引擎宕机)时,它默默返回空列表,而不报错。MCP search_memory 工具把这个空列表翻译成「No results found」——这和「我真的没有相关记忆」听起来完全一样,但意思天差地别。
换句话说:长达两个月,Dragon Brain 可能在每一次基础设施故障时,都对 Claude 撒了谎。 Claude 在没有任何背景信息的情况下继续工作,却完全不知道自己失去了记忆。
修复后,基础设施故障现在会抛出 SearchError,MCP 工具返回结构化错误 {"error": "MEMORY_LAYER_DEGRADED", "retry_safe": true}——明确告知 Claude「记忆层坏了,谨慎操作」。CI 流水线增加了 tox -e contracts 合同验证 gate,提交前检测新的违规,基准从 64 降到 13 个。
这个「失败即大声报告」(fail loud, by design)的哲学,被写在了项目首页的 tagline 里:Memory infrastructure for AI agents — that fails loud, by design. 不是偶然。
Dragon Brain 对代码质量的追求在同量级项目中极为罕见:
开发规范要求每个函数必须有文档字符串、类型注解必须完整(mypy strict 模式)、docstring 覆盖率有门槛。这不是一个简单的小工具,而是一套严肃的基础设施级软件。
坦诚地说,Dragon Brain 也有它的局限:
部署复杂度不低。 虽然 docker compose up -d 一条命令,但背后跑着 4 个容器(FalkorDB + Qdrant + Embedding API + Dashboard),加上 GPU 模式下需要 NVIDIA 驱动和 CUDA 运行时,对个人用户和小团队的运维能力有一定要求。
依赖链较长。 Python 3.12+ 强制要求,BGE-M3 模型约 1GB,GPU 模式下还需要 CUDA 支持。在网络受限或磁盘紧张的环境里,首次部署耗时较长。
异步化过渡期。 当前版本使用 asyncio.to_thread 包装同步的 FalkorDB 客户端,真正的原生异步(FalkorDB asyncio 原生客户端)还在路线图上。这对高并发场景的性能有一定影响。
非通用大模型。 Dragon Brain 本身不运行 LLM,只是负责记忆存储和检索。「记得什么」之后如何利用这些记忆,取决于接入的 AI Agent 本身的能力。
随着 AI Agent 赛道持续升温,长期记忆能力正成为刚需。当 Agent 需要跨多天、多会话执行复杂任务时,「记忆」不再是可选项,而是基础能力。Dragon Brain 代表了一个重要的技术方向:用知识图谱 + 向量搜索的混合架构,让 AI 不只「记得内容」,更「理解关系」。
从数据上看,Dragon Brain 在 GitHub 拥有 50 颗星、9 个 fork、7 个 open issue,2026 年 5 月至今持续活跃更新。项目支持 9 种语言的 README 文档,吸引了来自全球的开发者参与。项目还内置了 14 个行业 demo 场景(医疗、法律、网络安全、游戏、记者调查等),展示了知识图谱记忆在不同领域的适配潜力。
一句话总结:Dragon Brain 让 AI Agent 从「每次对话都是第一天」的失忆状态,进化到真正拥有持久、可推理、跨会话的长期记忆。 如果你在构建需要持续上下文的 AI 应用,这可能是目前开源生态中最认真、最具工程深度的一个选择。
