
Blended-RAG
ibm-self-serve-assets/Blended-RAG加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你是某大型医疗集团的 IT 负责人,需要在数十万份病历、研究报告和药品说明书中,用自然语言快速找到「某药物对特定基因突变患者的疗效数据」。传统关键词检索(BM25)要么漏掉同义词(如"高血压"搜不到"血压升高"),要么被近义词误导(如"心梗"匹配到大量无关心电图报告)。而单纯的向量检索在专业术语密集的领域又容易「一知半解」,把边界模糊的结果也推给大模型,最终生成的回答似是而非。
IBM Research 团队发表的论文《Blended RAG》就是来解决这个问题的——通过混合多种检索策略,让 RAG 系统在真实企业数据集上实现可用的精度,而不是在学术数据集上刷分。
这篇论文的研究动机直指 RAG 领域的一个尴尬现实:很多 RAG 方案在标准学术基准(如 Natural Questions、SQuAD)上表现不错,但在真实企业场景——术语专业、数据私有、规模庞大——却频频失准。原因在于现有方案过度依赖单一检索范式(要么纯 BM25,要么纯向量检索),无法适应不同类型查询的需求。
IBM 团队的核心洞察是:不同类型的查询需要不同的检索策略,而一个「聪明的混合器」可以动态判断该用哪种方式。具体而言,他们引入了三种检索器:
然后通过混合查询策略(Hybrid Query)——Match Query(匹配查询)和 Best Field(最佳字段查询)——来组合这些检索器,找出最相关的文档片段。
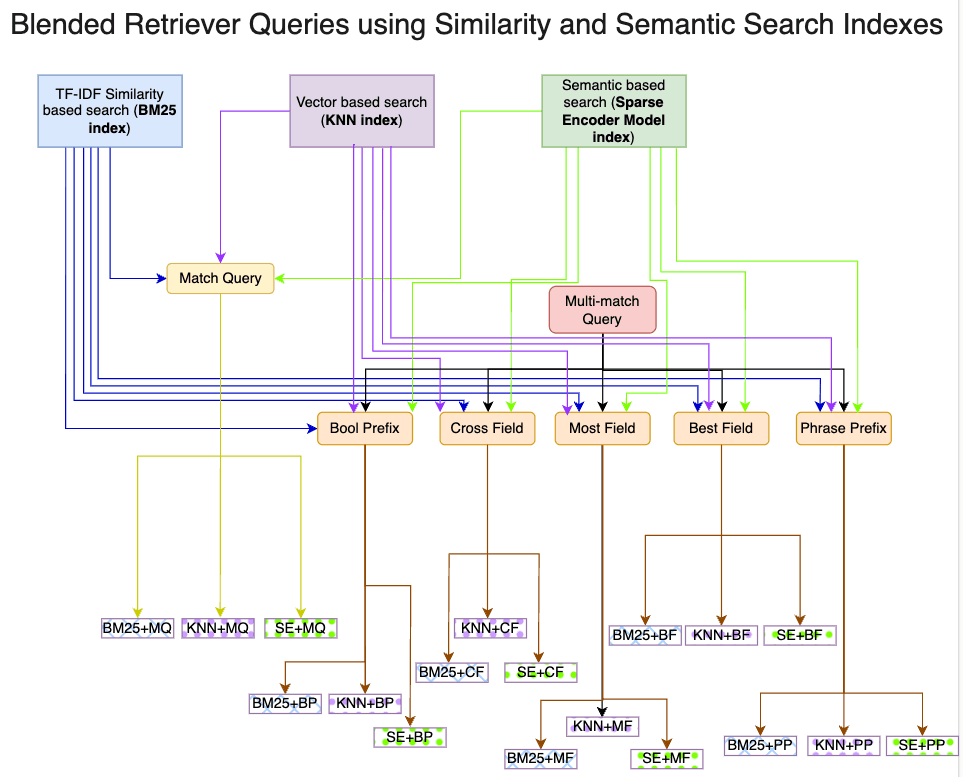
图注:Blended RAG 核心流程:用户查询 → 并行多路检索器 → 混合排序 → 精选 Top-K 文档 → 送入 LLM 生成答案
把一个 RAG 系统想象成一个图书馆管理员:
Blended RAG 的「混合器」就是让这两个馆员同时工作,互相补充,最终给你最精准的那几本书,而不是让你在几百本书里自己挑。
这是论文最令人印象深刻的部分——Blended RAG 在零微调的情况下,在 SQuAD 数据集上超越了经过专门微调的 RAG 系统:
| 模型/方案 | EM | F1 | Top-5 召回 | Top-20 召回 |
|---|---|---|---|---|
| RAG-Original | 28.12 | 39.42 | 59.64 | 72.38 |
| RAG-End2End | 40.02 | 52.63 | 75.79 | 85.57 |
| Blended RAG | 57.63 | 68.4 | 94.89 | 98.58 |
在信息检索(IR)基准上,Blended RAG 的 NDCG@10 得分同样亮眼:TREC-COVID 数据集达到 0.87(vs COCO-DR Large 的 0.804),NQ 数据集达到 0.67(vs monoT5-3B 的 0.633)。
这个结果说明:精心调优的检索策略,可以在不额外训练模型的情况下,显著提升 RAG 系统的实际表现——这对无法负担 LLM 微调成本的企业来说,是极具吸引力的方向。
项目代码库结构清晰,分为三个核心模块:
索引构建(code/indexing.py)
负责将文档语料转换为可检索的向量索引和 BM25 索引。依赖 Elasticsearch 作为底层检索引擎,使用 sentence-transformers/all-MiniLM-L6-v2 模型将文本转为 384 维稠密向量,存入 Elasticsearch 的 dense_vector 字段。代码中还包含数据清洗(正则过滤、乱码处理)和批量导入逻辑。
检索评估(code/evaluation_retrieval.py)
对比 6 种检索方案(BM25/KNN/SERM × Match Query/Best Field)在 NQ、TREC-COVID、SQuAD、CoQA 四个数据集上的 Top-5/10/20 准确率。评估指标涵盖精确率、NDCG、MRR 等。代码中还实现了 Simhash 去重和 Perplexity 评分用于结果质量过滤。
RAG 评估(code/evaluation_blended_rag.py)
将精选出的 Top-K 文档拼接为上下文提示,送入 FlanT5-XXL(11B 参数)LLM 生成答案。评估指标覆盖 EM(精确匹配)、F1、BLEU、ROUGE、METEOR、BERTScore、BLEURT 等多个维度,全面衡量生成质量。
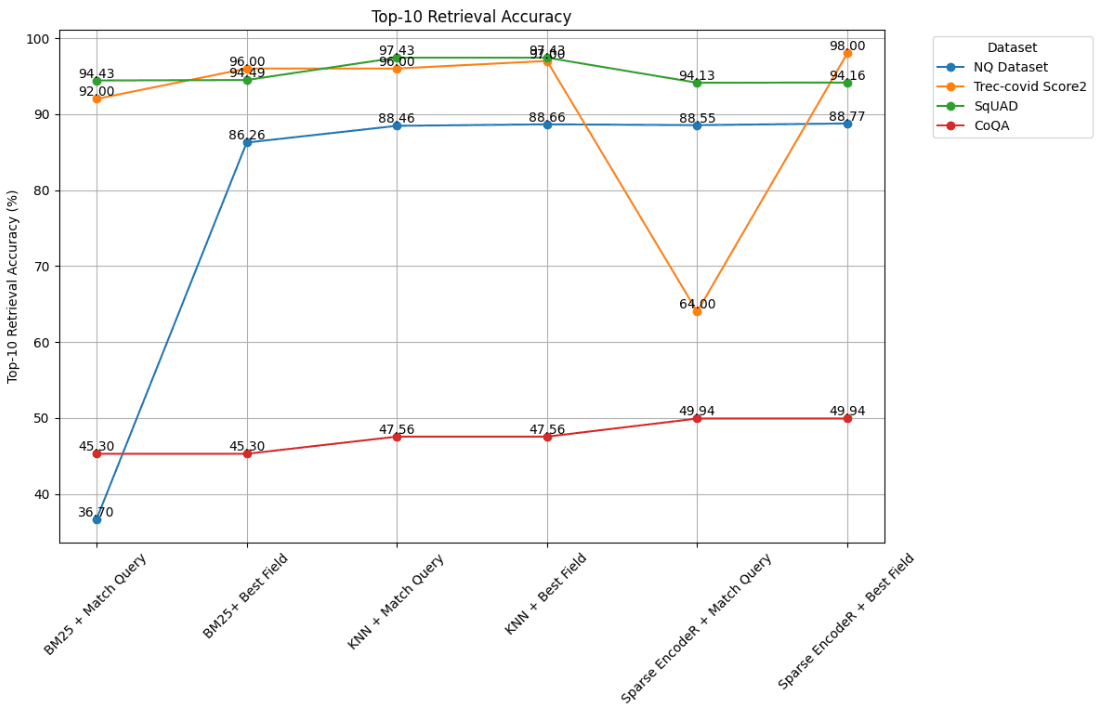
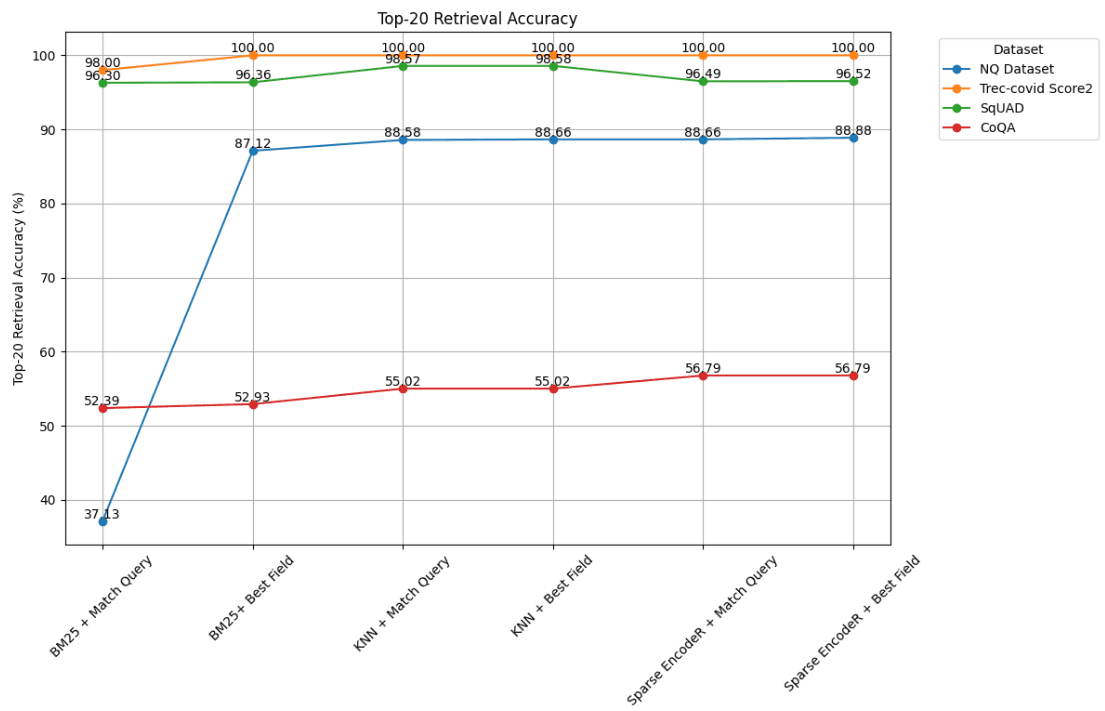
图注:上图展示了在 NQ、TREC-COVID、SQuAD 数据集上,KNN+BestField 组合始终保持领先——这是 Blended RAG 的核心检索策略
优势:
input/mapping/)可直接使用,无需从零构建索引挑战:
论文的局限性值得注意:
Blended RAG 最重要的贡献不在于某个具体的准确率数字,而在于证明了「混合检索」策略在 RAG 系统中的有效性。它让研究者和企业意识到:与其花大力气微调 LLM,不如在检索环节下功夫——因为 LLM 的能力再强,如果喂进去的上下文本身就是错的,生成结果也好不到哪去。
这个思路正在被后续工作(如 HybridRAG、Self-RAG、Corrective-RAG)广泛借鉴,推动 RAG 从「简单拼接」走向「智能编排」。
项目基本信息
