
scholar-agent
hxcm-cre/scholar-agent加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下这样的场景:你正在准备一篇关于 Transformer 效率优化的文献综述,导师要求一周内整理出近三年顶会的核心论文。你打开 Google Scholar,搜索关键词,逐一打开论文页面,复制摘要,记录引用量……半小时后,你的浏览器标签页已经堆到第 47 个,而 Google Scholar 返回的相关结果还在不断刷新。
Scholar-Agent 正是为解决这一痛点而生。它是一个基于大语言模型的对话式学术研究助手,用户可以用自然语言与它对话,让它自动完成论文检索、全文抓取、指标提取和深度分析——整个过程就像在和一个知识渊博的图书馆管理员对话。
传统的文献调研依赖人工逐篇检索,效率低下且容易遗漏。2024 年以来,随着 GPT-4、Qwen 等大模型能力的飞跃,多 Agent 系统开始进入学术研究场景。Scholar-Agent 的作者受到 OpenClaw 架构启发,设计了一套"中控大模型 + 专项 Skill"的框架,让一个总控 LLM 根据用户意图自主调用搜索、阅读、分析等专项工具。
该框架的核心是 LangGraph——一个用于构建有状态、多步骤 LLM 应用的工作流引擎。相比单次调用的 RAG 系统,Scholar-Agent 的对话式架构支持多轮追问和上下文关联,用户可以针对某篇论文追问方法细节,也可以让 AI 对比两篇论文的实验设计。
Scholar-Agent 采用 Hub-and-Spoke(中心辐射型)架构,核心组件包括:
中控管理器(ChatManager):基于 LangGraph 构建的状态机,负责理解用户意图、决定调用哪个 Skill、维护对话历史。状态管理采用 TypedDict 定义的 AgentState,包含查询、候选论文、已处理标题、实验结果、分析报告等字段,支持灵活的字段扩展。
学术搜索 Skill(ScholarSearchSkill):LangGraph 工作流封装,完整执行"查询扩展 → arXiv 检索 → Zotero 本地检索 → 候选论文过滤 → 评分排序"的流水线。内置加权评分机制,综合考虑相关性、发表 venue、引用量、可复现性四个维度。
深度阅读 Skill(ReadPaperSkill):使用 Docling 库提取 PDF 全文内容,支持表格、公式、参考文献的语义解析,并将提取结果存入 SQLite 数据库供后续分析。
LLM 后端:默认使用通义 Qwen 系列模型(qwen3-coder-30b-a3b-instruct),通过 LangChain OpenAI 兼容接口接入,base_url 指向 DashScope API。
| 层级 | 技术选型 | 说明 |
|---|---|---|
| 后端框架 | FastAPI + Uvicorn | 异步 REST API + WebSocket 支持实时流式输出 |
| 前端框架 | React 19 + Vite + TailwindCSS | 现代响应式对话界面 |
| Agent 框架 | LangGraph ≥1.0.7 | 状态机工作流引擎,支持 Checkpoint 断点续跑 |
| LLM 接口 | LangChain OpenAI 兼容层 | 解耦底层模型,支持切换 OpenAI/Qwen 等 |
| PDF 解析 | Docling 2.76.0 | 结构化文档解析,支持表格和公式 |
| 异步任务 | Celery + Redis | 后台论文搜索与 PDF 处理 |
| 数据持久化 | SQLite + SQLAlchemy | 轻量级本地存储 |
| 检查点存储 | LangGraph Checkpoint SQLite | 支持多轮对话的线程级状态持久化 |
部署方面,项目要求 Python 3.11+ 和 Node.js 18+,不提供 Docker 支持,需要手动启动 Redis、Celery Worker、Uvicorn 后端和 Vite 前端四个独立进程。对于有 Docker 使用习惯的用户来说,这一点较为不便。生产环境部署建议自行编写 Dockerfile,将 Redis 和 Celery 集成到 docker-compose 中。
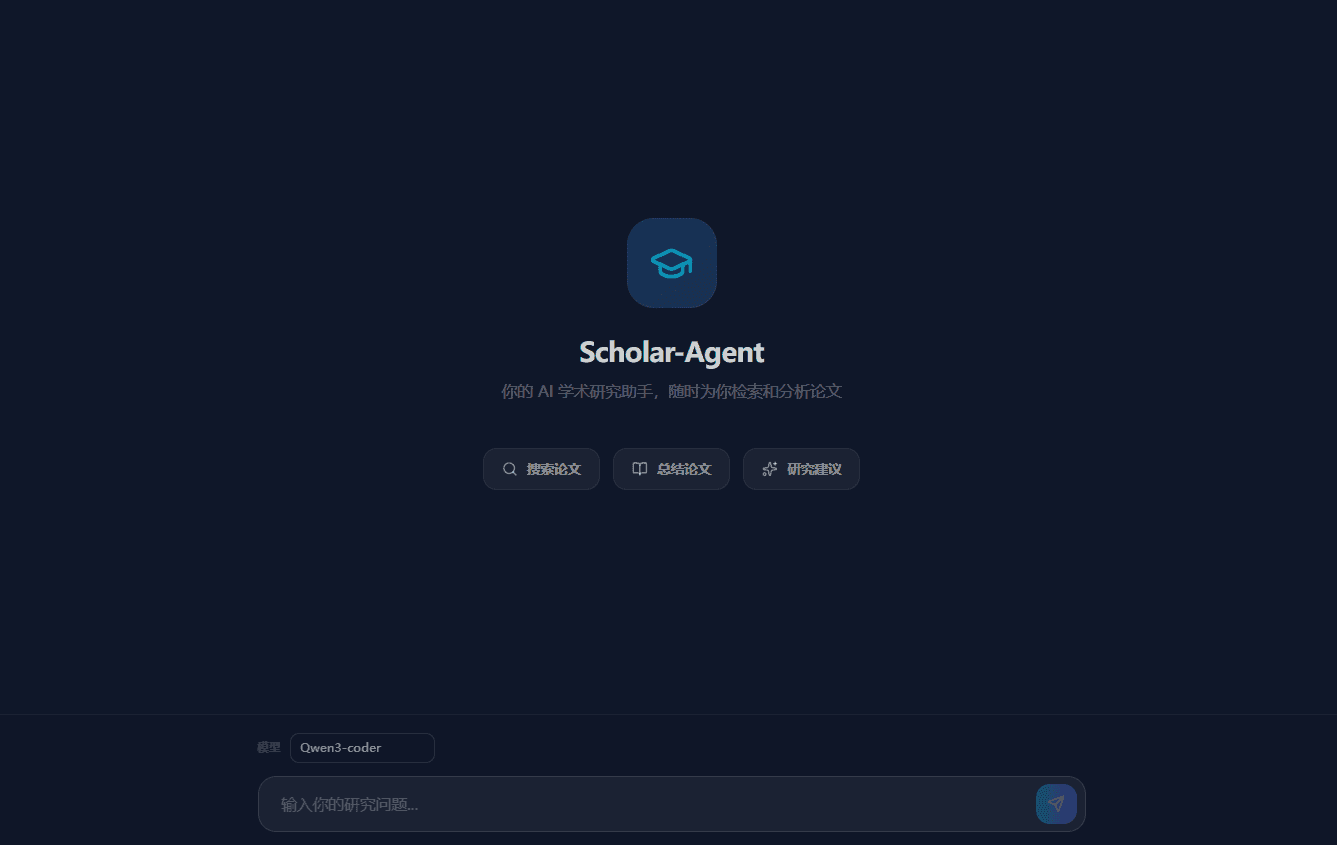
本地安装步骤清晰:首先复制 .env.example 为 .env,填入 OPENAI_API_KEY;然后依次启动 Redis 服务、Uvicorn 后端、Celery Worker 和前端开发服务器。首次使用时,在浏览器访问 http://localhost:3000,点击"新建对话",输入类似"帮我搜索关于 Transformer 效率优化的最新论文"的指令,Scholar-Agent 会自动调用 arXiv 搜索、筛选排序,并在侧边栏展示论文列表和全文预览。
AI 会自动为每篇论文分配引用编号(如 [1]、[2]),用户可以在后续对话中直接说"详细解释第 2 篇论文的实验设计",Scholar-Agent 会调用 ReadPaperSkill 提取 PDF 内容并进行深度解读。
需要客观指出的是,Scholar-Agent 目前还处于早期阶段(38 stars),功能稳定性有待验证。主要局限包括:
ZOTERO_API_KEY 和 ZOTERO_USER_ID 需要用户在 Zotero 官网申请,对非 Zotero 用户不友好。Scholar-Agent 代表了一个值得关注的方向:用多 Agent 协作替代单次 LLM 调用,来解决需要多步骤、工具调用的复杂任务。随着 LLM API 成本的持续下降和模型能力的提升,这类工具的实用价值将不断增长。其"中控 LLM 自主决策工具调用"的架构设计,与 OpenAI 的 Tool Use、Anthropic 的 Computer Use 在理念上一脉相承,是对"LLM as OS"愿景的一次具体实践。
对于研究人员而言,Scholar-Agent 的价值不在于替代人工阅读,而在于大幅降低文献筛选阶段的认知负担——让 AI 先读完 200 篇论文的摘要和指标,再由人类做最终判断。
