self-hosted-ai-stack
hwdsl2/self-hosted-ai-stack加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
如果你曾经为了在本地跑通一个「能聊天的 AI」,需要依次安装 Ollama、装向量数据库、装向量模型、配前端界面、处理互相冲突的端口和 API Key、被各种依赖版本问题折磨到深夜——这个项目就是从那个泥潭里爬出来的人做的。
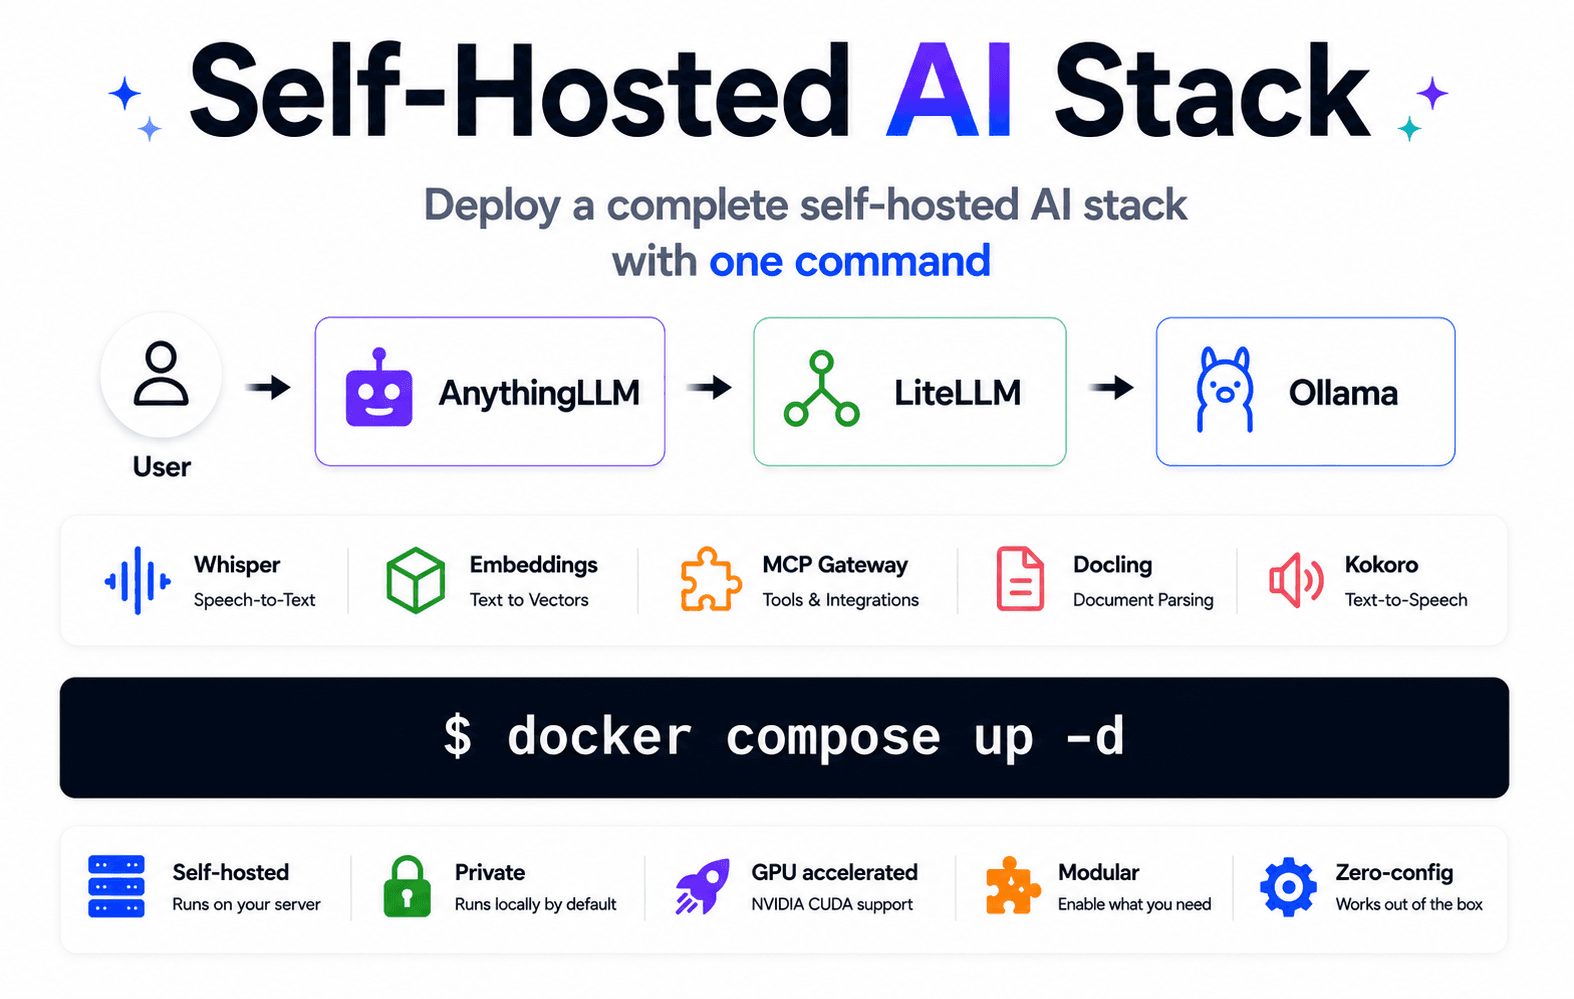
hwdsl2/self-hosted-ai-stack 用一份 Docker Compose 编排文件,把本地大模型推理、网页聊天界面、文档解析、文本向量化、语音转文字、文字转语音、MCP 工具网关这 7 类能力打包成 9 个互相协作的容器,克隆下来 docker compose up -d 就能拉起整个栈。截至 2026 年 10 月,它在 GitHub 上已积累 170 star、34 fork,采用 MIT 协议,同时支持 amd64 与 arm64 架构。
作者 hwdsl2 是一个 28k star 项目的作者(Setup IPsec VPN),README 提到该项目出自一位长期做「一条命令装好一切」的基础设施工程师之手。这类项目的价值不在于发明新算法,而在于消解集成的摩擦。
当下想自建本地 AI 的普通人/小团队,真实痛点是这样的:
0.0.0.0、默认无密码,是这类自建服务最常见的翻车点。这个项目的答案不是「再写一个框架」,而是写好一份组装说明书。
项目的服务命名很讲究,用统一的「Crate(集装箱)」隐喻串起来:
| 服务 | 底层组件 | 职责 | 默认端口 |
|---|---|---|---|
| InferCrate | Ollama | 本地大模型推理(llama3 / qwen / mistral 等) | 11434(内网) |
| GatewayCrate | LiteLLM | AI 网关 + Admin UI,统一路由 100+ 模型供应商 | 4000 |
| AnythingLLM | mintplex-labs | Web 聊天界面(工作区 / RAG / Agent),默认密码保护 | 3001 |
| EmbedCrate | HuggingFace TEI | 文本向量化,支撑语义检索与 RAG | 8000 |
| ScribeCrate | Whisper | 语音转文字 | 9000 |
| ScribeCrate Live | Whisper Live | WebSocket 实时语音转写 | 9090 |
| SpeakCrate | Kokoro | 文字转自然语音 | 8880 |
| UplinkCrate | MCPHub | MCP 工具服务(文件系统 / fetch / GitHub / 搜索 / 数据库) | 3000(内网) |
| ParseCrate | Docling | PDF / DOCX 等文档解析为结构化 Markdown | 5001 |
底座是 pgvector/pgvector:pg18-trixie(PostgreSQL 18 + 向量扩展),既做 LiteLLM 的配置库,也(在可选配置下)承载 AnythingLLM 的向量存储。
数据流非常清晰:
语音 → ScribeCrate ─┐
文档 → ParseCrate → EmbedCrate → pgvector ┐
                                         ├→ GatewayCrate → InferCrate → 回答 → SpeakCrate → 语音
AnythingLLM(聊天界面)──────────────────┘        ↑
goose / Cline / Claude Code 等 AI 客户端 ──MCP──→ UplinkCrate
关键设计取舍:InferCrate 的 11434 和 UplinkCrate 的 3000 默认不映射到宿主机,所有外部访问必须经过 GatewayCrate(4000)这一道统一网关。这样一来,鉴权、配额、计费、路由策略只需在一个地方配置,也为接入外部模型供应商留了同一个口子。
项目没有把密码写死在 compose 文件里,而是引入一个一次性的 ai-stack-init 容器(alpine:3.24),在服务启动前生成 PostgreSQL 密码和 LiteLLM master key,写入共享卷 ai-stack-shared,再由 db、litellm 以 *_FILE 方式读取文件而非环境变量。
好处很实在:密码不落进 docker-compose.yml、不落进 shell history、不落进 docker inspect 的环境变量;postgres 服务通过 condition: service_completed_successfully 依赖初始化完成,避免了竞态。
AnythingLLM 首次启动会自动生成随机管理员密码,打印到 docker logs anythingllm 一次,并保存在数据卷的 /app/server/storage/.initial_admin_password 里,容器升级后依然有效。配合可选的 Caddy HTTPS overlay(docker-compose.proxy.yml),可以把所有直连 HTTP 端口绑到 127.0.0.1,只对外暴露 443。这套「默认安全 + 可选加固」的分层设计,符合生产运维的最佳实践。
全量栈 9 个服务内存开销不小。项目因此在 stacks/ 目录提供了 8 个预设子集:
| 组合栈 | 服务构成 | 内存 | 典型场景 |
|---|---|---|---|
| chat-only | InferCrate + GatewayCrate | ~4.5 GB | 最小本地 ChatGPT 替代 |
| chat-ui | InferCrate + GatewayCrate + AnythingLLM | ~5 GB | 网页聊天界面 |
| rag-pipeline | + EmbedCrate | ~5 GB | 语义检索 + LLM 问答 |
| rag-pipeline-full | + ParseCrate | ~6 GB | 文档解析 + RAG 全链路 |
| voice-pipeline | ScribeCrate + SpeakCrate | ~6 GB | 语音进、语音出 |
| voice-chat | + AnythingLLM | ~6.5 GB | 带语音输入输出的聊天 UI |
| code-assistant | + UplinkCrate + EmbedCrate | ~5 GB | 带工具的 AI 编码 + 代码语义检索 |
| ai-tools | InferCrate + GatewayCrate + UplinkCrate | ~5 GB | 轻量 Agent 工具集 |
注意这些组合共享默认容器名、端口和卷名,一次只能跑一个变体——这个限制在 README 中被明确标红,属于已知的粗糙之处。
最简路径:
git clone https://github.com/hwdsl2/self-hosted-ai-stack
cd self-hosted-ai-stack
docker compose up -d
docker exec ollama ollama_manage --pull llama3.2:3b   # 必须手动拉模型
./stack-check.sh                                        # 健康检查
之后:http://<server-ip>:3001 打开 AnythingLLM(密码见上文),http://<server-ip>:4000/ui 打开 LiteLLM Admin UI(用户名 admin,密码是 master key)。
CLI 与 Web-UI 的分工:命令行侧主要靠 stack-check.sh(19KB 的健康巡检脚本,逐个探活服务并做一次 LiteLLM 路由测试)、docker exec ... _manage --showkey 系列管理命令(ollama_manage / litellm_manage / mcp_manage / embed_manage)以及 docker compose logs 排障;Web-UI 侧负责真正的日常使用——聊天、RAG 工作区、Agent 配置、虚拟密钥管理与用量统计。
GPU 加速:另用 docker-compose.cuda.yml,需要 NVIDIA 驱动 575.57.08+ 与 NVIDIA Container Toolkit,且 CUDA 镜像仅 amd64。README 也提醒 Podman 会忽略 compose 的 deploy: GPU 块,需要改用 CDI。
其他细节:项目还提供 Podman 兼容说明、docs/backup-restore.md 备份恢复指南(多语言,含简中/繁中/俄文),以及配套电子书《The Self-Hosted AI Builder's Guide》。
必须承认的问题:
mintplexlabs/anythingllm:1.14.1(CUDA 版为 1.16.2)等带 tag 的镜像,但大部分 hwdsl2/*-server 镜像未固定 digest。上游 AnythingLLM 或 Ollama 发布破坏性更新时,本项目可能被动受影响。这个项目折射出开源 AI 部署的一条清晰趋势:竞争焦点正从「模型能力」转向「集成体验」。当 Llama、Qwen、Mistral 等开源模型本身足够强、下载门槛足够低时,真正的稀缺性就转移到了——把九个异构组件接成一条能跑通的链路,并让这个链路对普通人足够不烦人。
从数据上看这个方向确实被验证了:仓库 2026 年 5 月创建,到 10 月已积累 170 star / 34 fork,README 里带有 Docker Hub 拉取量徽章、配套付费电子书、邮件订阅(beehiiv)、Reddit 社区(r/selfhostedstack)和官方文档站(selfhostedaistack.com),已经形成了「项目 + 文档 + 社区 + 周边产品」的完整运营结构,而非单纯的技术玩具。
对企业的现实价值在于:数据不出内网是这套栈最硬的卖点。当数据合规成为采购前置条件,一套开箱即用、默认密码保护、可选 TLS、支持 CUDA 与 ARM 架构、且能在 4.5GB 内存的小机器上跑的私有 AI 中枢,比「自己拼 Ollama + 某 RAG 框架」的方案能节省大量工程量。
推荐场景:个人开发者想在本地搭建私有 AI 工作台;小团队需要一个不外传数据的内部知识库问答;边缘设备(ARM 机器、4~8GB 内存)需要轻量 AI 服务;想学习 AI 系统整体架构的工程师——这个仓库的 compose 文件本身就是一份高质量的架构教材。
不推荐场景:需要高并发生产级 SLA;团队规模大、需要多人协作维护;已有成熟 K8s/MLOps 体系;或所在网络无法稳定拉取这些镜像。
建议路径:先从 stacks/chat-only 或 stacks/rag-pipeline 这类轻量组合起步,跑通模型拉取和对话链路,再按需扩展功能;部署到公网前务必启用 Caddy HTTPS overlay 并更换 AnythingLLM 密码;定期备份 anythingllm-data、litellm-data、litellm-db 三个卷。
分析基于 GitHub 仓库 hwdsl2/self-hosted-ai-stack 于 2026-10-24 的代码与文档状态。