
patent-disclosure-skill
handsomestWei/patent-disclosure-skill加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
做过核心技术研发的人,大概都经历过这种憋屈:代码是自己一行行敲的,架构是自己设计的,项目文档堆满了设计细节——但轮到写专利交底书时,发明人那一栏,从来没有自己的名字。不是不想申报,而是交底书这道坎,实在太难迈过去。
技术出身的人普遍不擅长写专利文体:发明点怎么提炼?权利要求书和说明书有什么区别?"查新"怎么写才能既不暴露技术方案又让审查员看懂?结构框图用什么工具画、画成什么风格?好不容易憋出一版,代理人说"需要改",改完又改,来回折腾七八轮,文件版本满天飞,到最后都不知道哪版是定稿。
更别提那些已经公开的专利文献——权要绕、术语密、附图和说明书之间的逻辑关系散落在各处。普通人想读懂一篇专利,没有专利代理人的背景知识,几乎是看天书。
中国专利.Skill(patent-disclosure-skill)正是为解决这个痛点而生。它将 AI Agent 工作流引入专利交底书编写的全流程,把"挖专利点→查新→成文→自检→迭代"串成一条可自动执行的流水线,让真正做技术的人,也能把贡献写进可交付的交底书里。
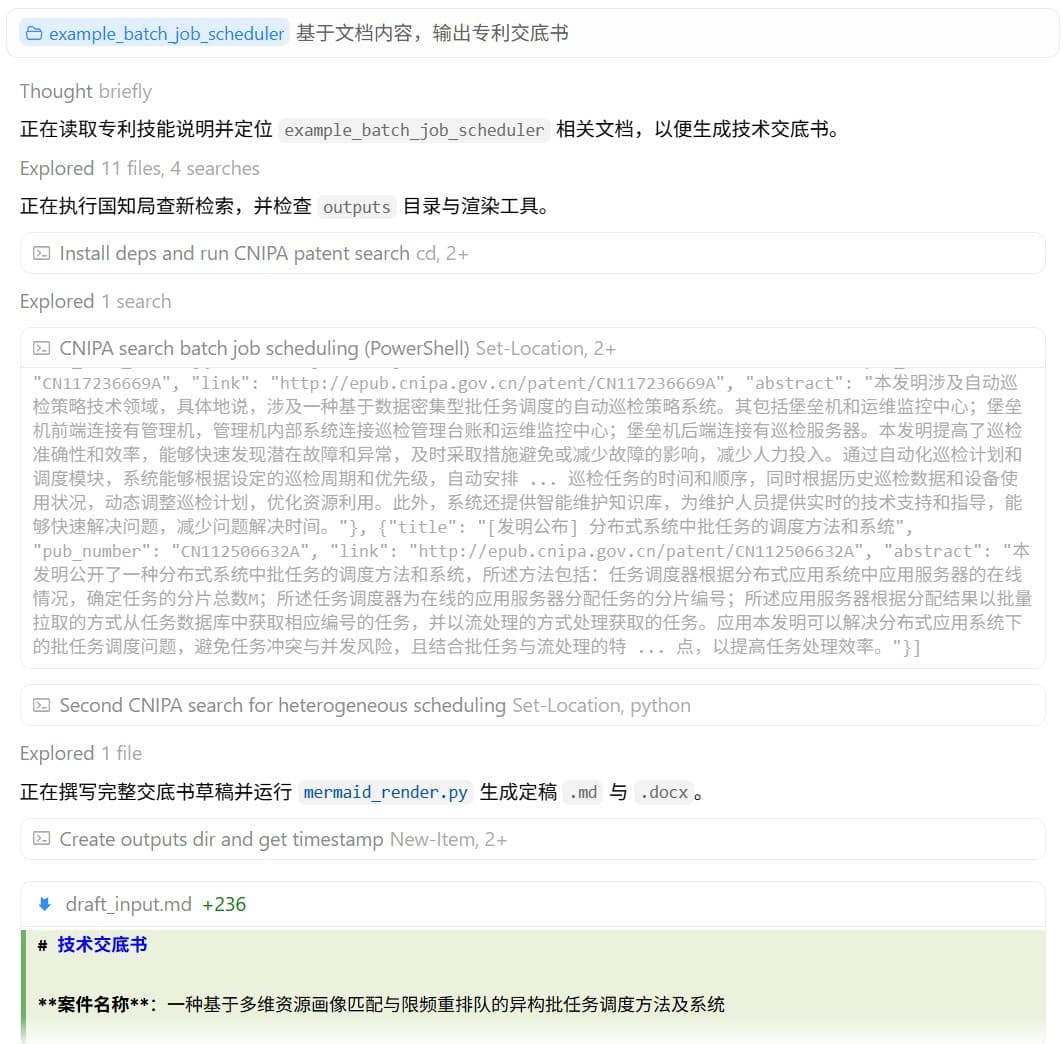
中国专利.Skill 的本质是一个模块化的 AI Agent 技能包,通过预置的 Prompt 模板和工作流指令,引导大语言模型按固定步骤完成专利交底书编写,而不是让模型"一口气生成一整篇"——后者往往结构飘、与仓库事实对不齐、图片难以嵌入 Word。
这是技能包的主线流程。以发明交底书为例,工作流分为 8 个步骤:
Step 1-2:录入与项目扫描。 用户只需提供项目目录(包含代码、设计文档、PPT 等材料),AI Agent 自动识别其中的技术创新点,生成专利点候选清单。
Step 3-4:专利点挖掘。 分为发明、实用新型、外观设计三条支线。系统内置了 invention/(发明)、utility_model/(实用新型)、design/(外观设计)三个子目录的 Prompt 模板,分别对应不同类型专利的挖掘逻辑。同时支持结构图线稿(CAD 提取)、外观专利视图(产品图→线稿)自动生成,以及 Word/PPT 中的公式解析(LaTeX → MathML → OMML)。
Step 5:轻量查新。 调用国知局(CNIPA)公布站 API,生成 3-4 个手段短语的检索式,按摘要相似度排序,AI 自动摘要并筛选最接近的对比文件,锁定 D1(最接近现有技术)并标注区别特征。这一步替代了过去工程师手动去国知局网页检索的低效流程。
Step 6-8:预览、成文与自检。 交底书 Markdown + Word 双格式输出,系统内置自检清单(禁止假 D1、未披露部件写入 uncertain),确保稿件质量底线。每次交付带时间戳,不默认覆盖旧稿,保留完整的修改历史。
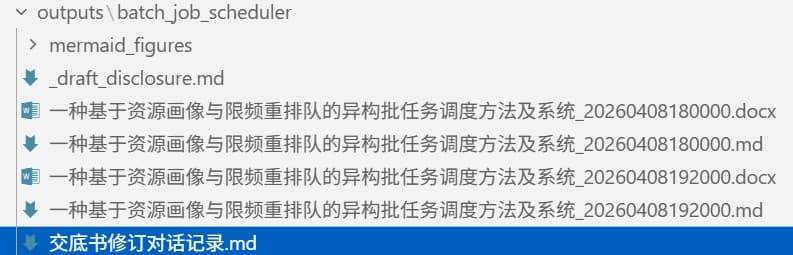
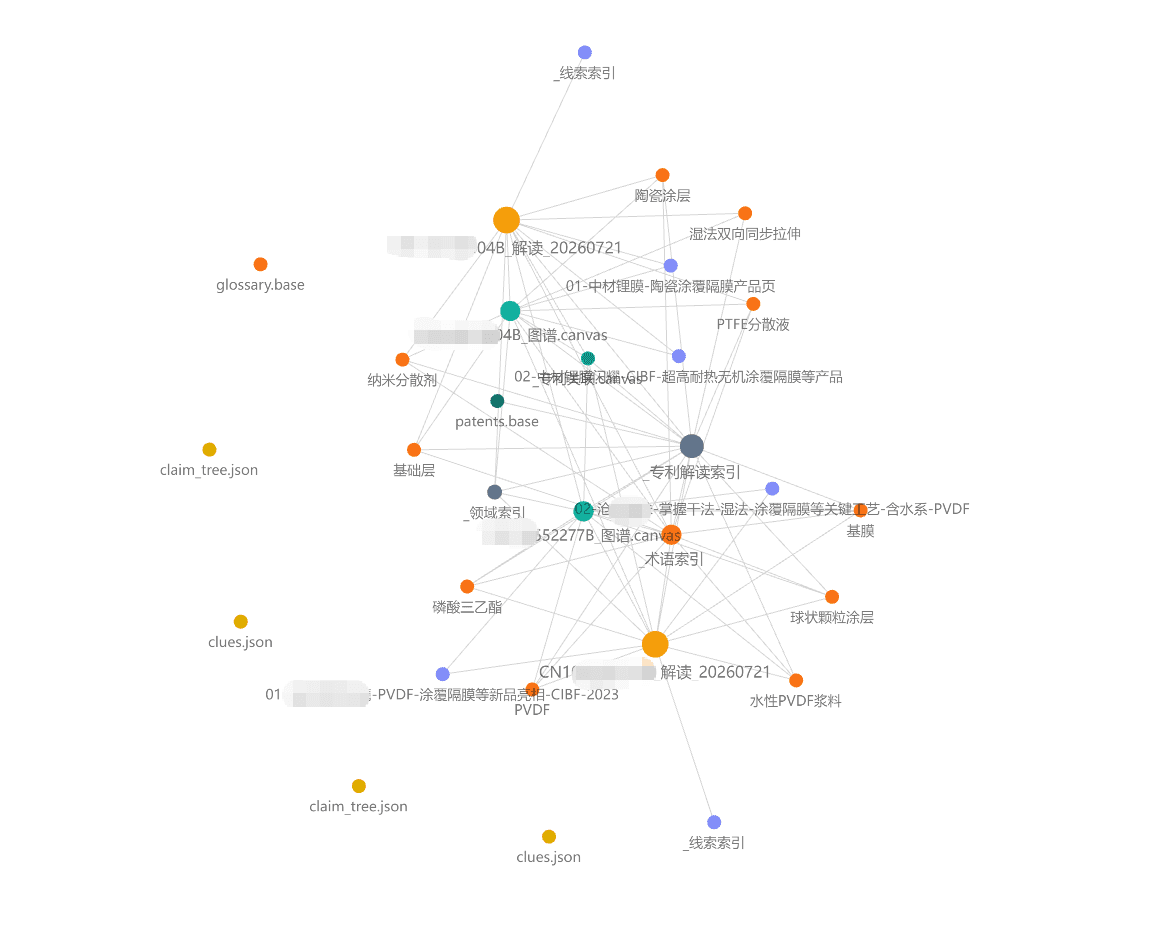
公开专利晦涩难懂是另一个普遍痛点。patent-disclosure-skill 的专利解读包(patent-reader)提供了从公开号或 PDF → 通俗笔记 + 图谱 → 入库 Obsidian 的完整链路。
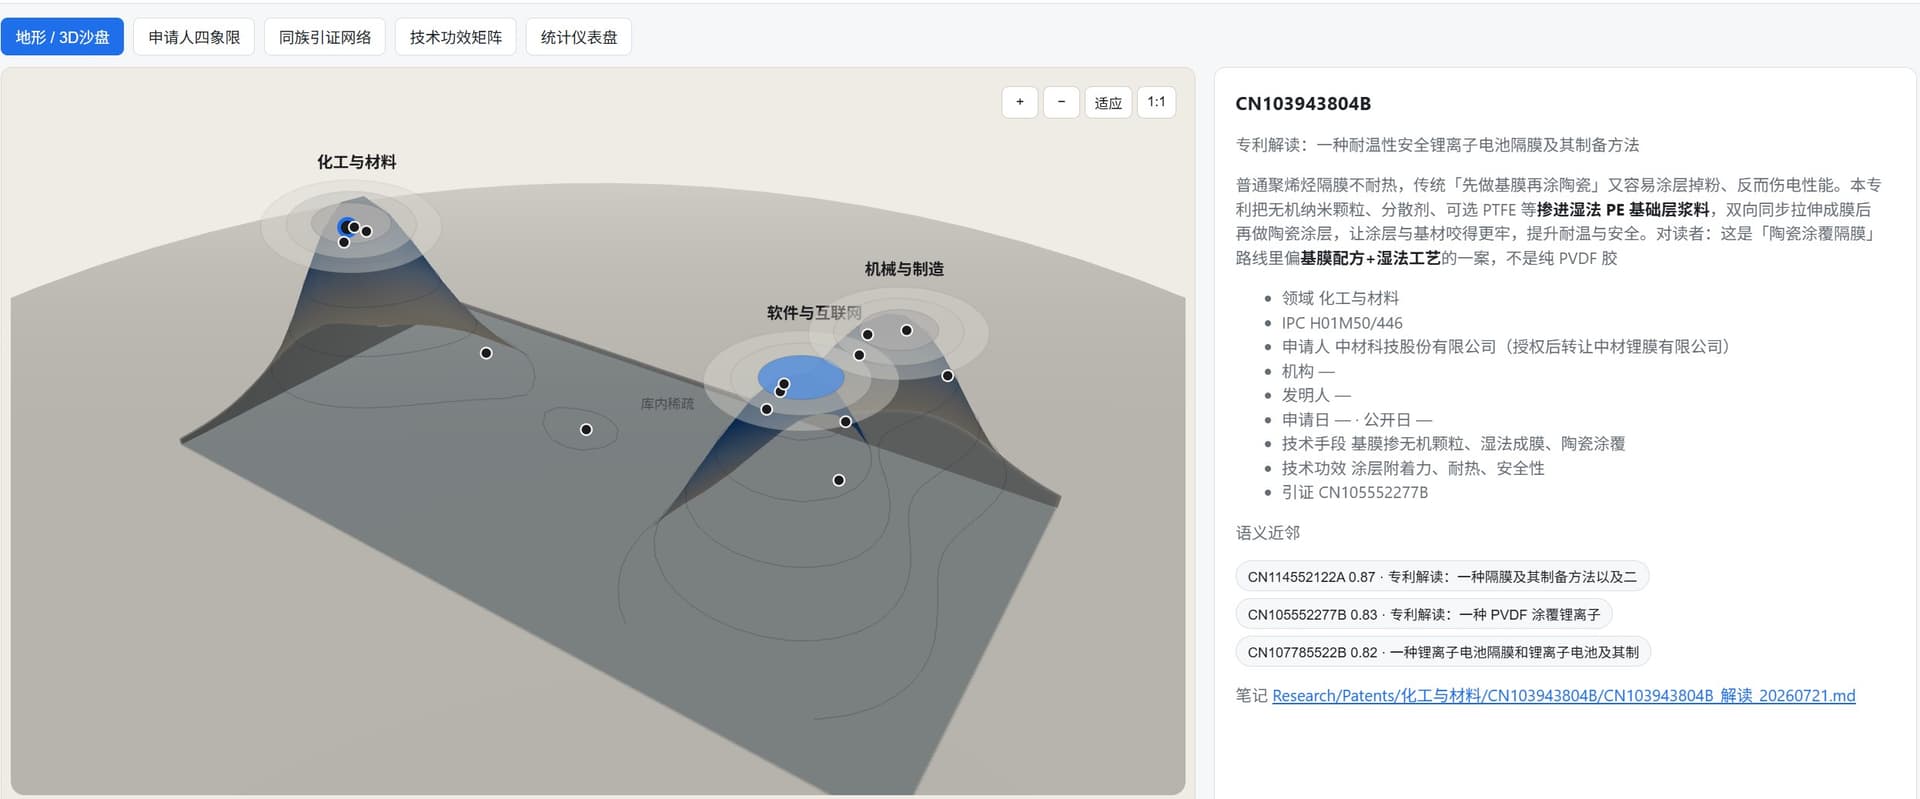
解读后的笔记以 Obsidian 双链格式存储,权要、术语、附图彼此勾连。随着解读专利数量增加,Obsidian 知识库逐渐形成专利语义网络,支持后续的专利地图生成(基于已解读的案例做向量语义地形分析)和专利比对(同族对照、技术路线梳理)。
围绕主线流程,技能包还提供了多个配套模块:
| 子技能 | 能力 |
|---|---|
| patent-application | 已有交底 → 权利要求书 / 说明书 / 摘要 / 附图四件套 |
| patent-docket | 从零出发,一趟完成交底书 + 申请文件全套 |
| patent-search | 国知局公布站高级检索(发明人/申请人/分类号/名称等多条件) |
| patent-chart | 独权特征 vs 对比文件 / 产品 / 标准,逐格证据与强弱对照(底稿,非法律意见) |
| patent-map | 基于已解读库生成五种专利地图(语义地形图) |
| patent-oa | 审查意见答复草稿,引导案例入库 |
| patent-exam-policy | 对照国知局最新口径,说明对交底写法的影响 |
整体架构分为三层:
入口层:SKILL.md 是整个技能包的路由中枢,通过「路由判定表」将用户意图("交底书"、"解读专利"、"做围栏")分发到对应的子技能包。不同触发词对应不同入口,禁止能力间相互污染。
Prompt 层:skills/ 目录下每个子技能有独立的 SKILL.md 和 prompts/ 子目录,按步骤切分指令(Step 1 ~ Step 8),每步独立 Prompt,互不干扰。这种"分步约束"比"单次生成"更能保证输出质量和格式一致性。
工具层:skills/*/tools/ 目录包含 Python 脚本,处理文档格式转换(Word/PPT → Markdown、Mermaid → PNG、LaTeX 公式渲染)、CAD 视图提取(支持 STEP 格式)、国知局检索(Playwright 驱动爬虫)等需要精确控制的操作。
核心依赖:
可选依赖:matplotlib(公式图片渲染)、智谱 embedding-3(专利地图向量模型)、CadQuery(STEP 格式 CAD 解析,Python 3.10-3.12)。
Skill 在文档和 prompt 中多处强调:查新仅为"轻量级现有技术扫描",patent-chart 生成的对照表是"底稿,不构成法律意见"。对于需要正式新颖性和创造性评价的专利申请,仍需要专利代理机构的正式检索报告。这是负责任的边界声明,用户不应将 AI 辅助查新等同于专业专利检索。
交底书的质量上限取决于发明人提供的材料质量。prompt 中有明确的"输入门禁":缺 schema、线稿或交底书时,流程会停下来引导用户补充,而不是硬编——这是正确的工程选择,但客观上要求用户有一定的材料整理意愿。
系统支持从产品照片自动提取线稿,但输出质量直接受输入图片分辨率和拍摄角度影响。对于复杂外观设计,人工线稿修正仍是必要的。
这是一个纯本地化的 Agent Skill,不提供 SaaS 服务,也没有 Docker 一键部署。这意味着它更适合个人开发者或中小研发团队使用,大型企业若需要多人协作、权限管理和流程审批,仍需在上层构建管理系统。
中国专利.Skill 的出现,折射出一个更大的趋势:AI 正在把专利编写从"专业壁垒"变成"工程师技能"。
过去,专利交底书是研发人员和专利代理人之间的"中间层"——工程师描述技术方案,代理人翻译成专利文体。这个中间层是信息损耗的来源:工程师懂技术但不懂专利语言,代理人懂专利语言但不懂技术细节,沟通成本高、迭代周期长。
现在,AI Agent 扮演了更称职的"中间层"角色:它既能用工程师能理解的自然语言引导材料梳理,又能按专利审查规范生成结构化稿件。工程师的输入更精准,代理人的工作量前移简化,整体效率提升。
GitHub 10.5k+ stars、知乎/腾讯云/博客园多平台传播、Tessl AI Skill 注册表收录——这些数字说明的不只是一个工具的成功,而是中国工程师群体对"把技术贡献写进专利"这件事的强烈需求。
# 安装到 Claude Code
mkdir -p .claude/skills
git clone https://github.com/handsomestWei/patent-disclosure-skill.git .claude/skills/patent-disclosure-skill

# 安装依赖
pip install -r requirements.txt

# 在 Claude Code 中输入 /patent-disclosure 开始交底书流程
主要依赖 Playwright(国知局爬虫 + Mermaid 渲染),首次使用可能需要 python -m playwright install chromium。Windows 终端已做 UTF-8 兼容,无需手动 chcp 65001。
