
ownmem
grpcer/ownmem加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一个场景:你用 Claude Code 花了两周时间开发一个复杂的缓存模块,过程中踩了无数坑:Redis 连接池要调到 20 才能撑住压测、某个 API 在 Node 18 下有兼容性问题、部署脚本里 DB_POOL_MAX 的默认值在 staging 环境太小导致超时——你让 AI 记住了这些经验。
然后项目搁置了两周。你回来继续开发,问 Claude Code:"还记得之前那个缓存模块的问题吗?"
它一脸茫然。
这不是 Claude Code 的 bug——因为记忆根本没写在它能看到的地方。它记在厂商的服务器上,不在你的代码仓库里,不同的 Agent 之间也无法共享。
OwnMem 解决的正是这个问题:把 AI 编程 Agent 的项目记忆,以可审阅的 Markdown 文件形式,写进 Git 仓库本身。
当前主流的 Agent 记忆方案有两个极端:
方案 A:指令文件(CLAUDE.md / AGENTS.md)——你手写,永久存在,每轮都进上下文。问题是它只说"怎么干活",不记录"踩过什么坑";而且每轮塞入全部内容,上下文成本高。
方案 B:平台自带记忆——Agent 从对话历史中自动提取,存在厂商账号里。问题是:记忆归厂商所有,你无法审阅、无法 Git 回滚、无法在不同 Agent 之间共享。
OwnMem 提出了第三个方向:记忆归仓库所有,像代码一样被审阅和版本控制。
作者在 README 中明确表达了一个核心设计哲学:
"大多数记忆方案先解决'记得更多'。OwnMem 先问另一件事:项目知识由谁拥有,谁有权改变它,错误记忆怎样在影响 Agent 行动前被拦住?"
这个立场来自对 Agent Memory 安全问题的深入研究。项目文档中引用了 AgentPoison(NeurIPS 2024)和 PoisonedRAG(USENIX Security 2025)等论文,讨论记忆投毒(memory poisoning)的风险,以及 CaMeL 等防御方案在 Agent 记忆场景的应用。
OwnMem 的技术架构围绕一个核心问题:记忆怎么召回,才能既有用又安全?
记忆以 Markdown 文件形式存储在 .ownmem/ 目录中。每个记忆条目(如 staging_timeout_pool_cap.md)包含:
与记忆正文独立存在的还有 trust.lock.json——一个不可篡改的信任收据账本,记录了每条记忆的签名来源、证据哈希和回滚链路。两者分开存储,意味着正文无法"自证可信"。
当 Agent 查询"staging 部署超时怎么办"时,召回流程经过:
然后进入四道交付门:
最终以三档之一交付:
关键特性:默认召回不调用任何 LLM,不发起任何网络请求。4200 样本实测,P50 延迟 0.46ms,P95 延迟 1.05ms,零成本。

OwnMem 对记忆质量有一套完整的治理机制:
一条记忆正文无法自己声明"我是可信的"。它必须引用外部证据:
这些证据在召回时会被实时核验——如果证据指向的代码已经改变,记忆会被降级为"advisory"(参考线索),并报告"变的是什么"。
这是 OwnMem 最特别的设计之一:记忆条目数有硬上限,只降不升。往一个满了的语料里添加一条,必须同时在同一次提交里退役(retire)一条。
这逼迫团队思考:这条新记忆真的比现有的某一条更重要吗?防止了记忆语料无限膨胀后质量稀释的问题。
如果记忆正文被修改(没有经过审阅流程),快照中的内容哈希与当前文件不一致,召回时会检测到 content drift,条目被降级并提示需要复核。
OwnMem 支持多种 AI 编程 Agent,通过宿主适配器实现:
| 宿主 | 接入方式 | 召回触发 |
|---|---|---|
| Claude Code | Git hook(每次 Edit/Write 前召回) | 自动 |
| Codex | Git hook(每次应用补丁前召回) | 自动 |
| Cursor | 规则文件 或 MCP server | 自动 |
| Gemini CLI | 指令文件 或 MCP server | 手动 |
| Grok CLI | Claude Code 兼容层 | 自动 |
对于没有 hook 机制的宿主(如 Gemini CLI),OwnMem 提供了 MCP server 接口,只暴露 recall 和 read 两个只读工具,所有写入操作必须走 Git 提交流程。
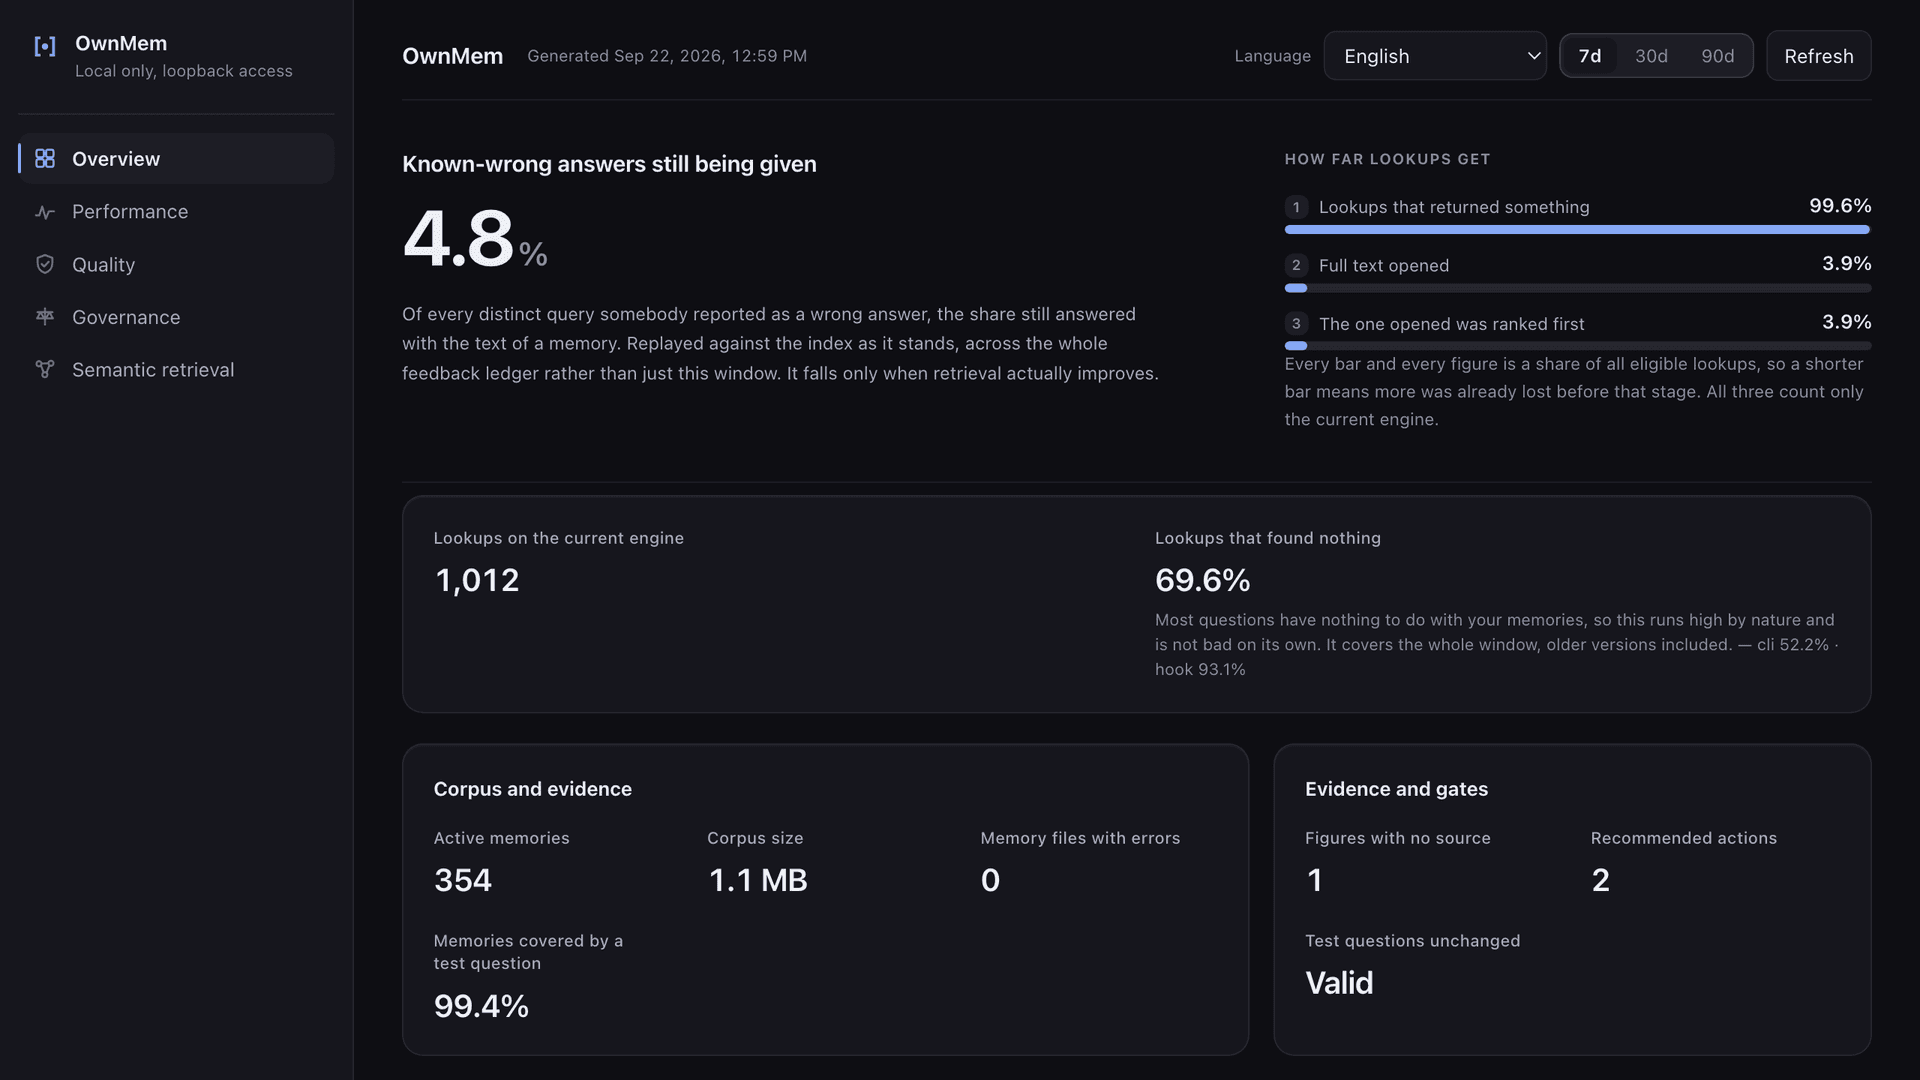
npx ownmem dashboard --open
打开一个本地仪表盘,展示:
这是一个纯本地工具,不上传任何数据到云端。
npm install --save-dev ownmem
npx ownmem init --hook --hosts claude,codex
要求:Node.js >= 20.6.0。
用自然语言指挥 Agent 工作,让它"记住"重要经验:
"记住:staging 部署超时来自连接池上限,不是 worker 太少。下次两者一起检查。"
Agent 会起草一条记忆,用户像审代码一样审阅后提交。记忆才真正生效。
OwnMem 的出现,折射出一个更大的趋势:当 AI Agent 越来越多地介入软件开发,它们的"记忆"正在成为重要的知识资产。
传统认知里,代码、文档、测试是项目资产。但记忆——那些"踩过的坑"、"验证过的方案"——在 OwnMem 之前没有好的工程化管理办法。
作者在 README 中引用了六篇顶会论文来建立研究脉络:AgentPoison(记忆投毒)、CaMeL(授权分离)、in-toto(独立来源证明)、Selective Classification(选择性预测与弃答)——这说明 OwnMem 不是凭空造出来的,它有扎实的学术基础。
在 GitHub 上,422 颗星虽然不算爆款,但在"AI Coding Agent 工具"这个细分赛道上,这是一个有技术深度、有独立思考方向的 niche 产品。作者(@grpcer)一人主导开发,commit 历史显示持续活跃维护中。
| 维度 | 评估 |
|---|---|
| 核心价值 | 把 AI Agent 的项目记忆变成可 Git 管理的资产 |
| 技术创新 | 五路检索 + 四道门 + 三档交付,零 LLM 调用的确定性召回 |
| 安全设计 | 独立信任收据、证据实时核验、内容漂移检测 |
| 多宿主支持 | Claude Code、Codex、Cursor、Gemini CLI、Grok CLI |
| 上手难度 | 低(npm 安装),概念门槛中等 |
| 局限性 | 仅 Node.js,不支持服务器部署,生态相对小众 |
| 维护状态 | 活跃(v0.8.0,2026-09-30) |
如果你在团队中大量使用 AI 编程 Agent,且希望项目知识能像代码一样被审阅、回滚和传承,OwnMem 值得深入了解。如果你只是想要一个对话总结工具,它不是答案。
