
magika
google/magika加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
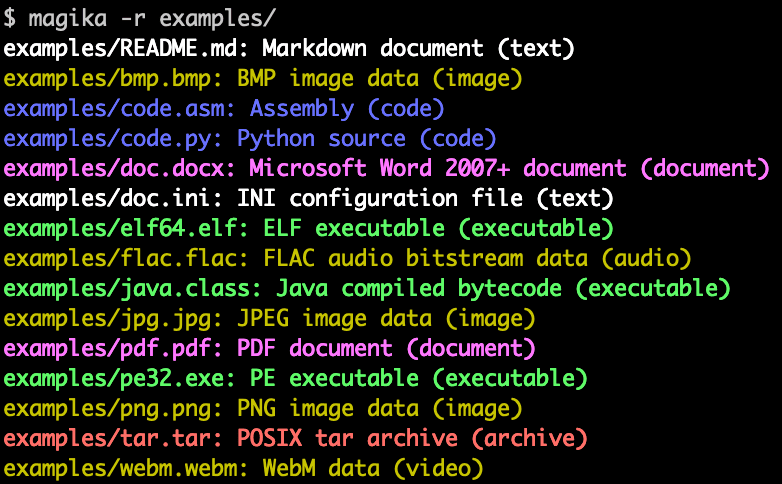
你有没有遇到过这种情况:同事发来一个 photo.jpg,点开却弹窗「此文件可能有害」?或者安全团队在一次邮件溯源中,发现附件其实是把可执行文件改了个扩展名?
传统的做法是「看扩展名 + 看魔数(magic number)」。这套规则简单粗暴,但有两个硬伤:一是扩展名可以随便改,几行代码就能伪装;二是魔数库覆盖不全,遇到没收录的格式就只能返回「未知」。
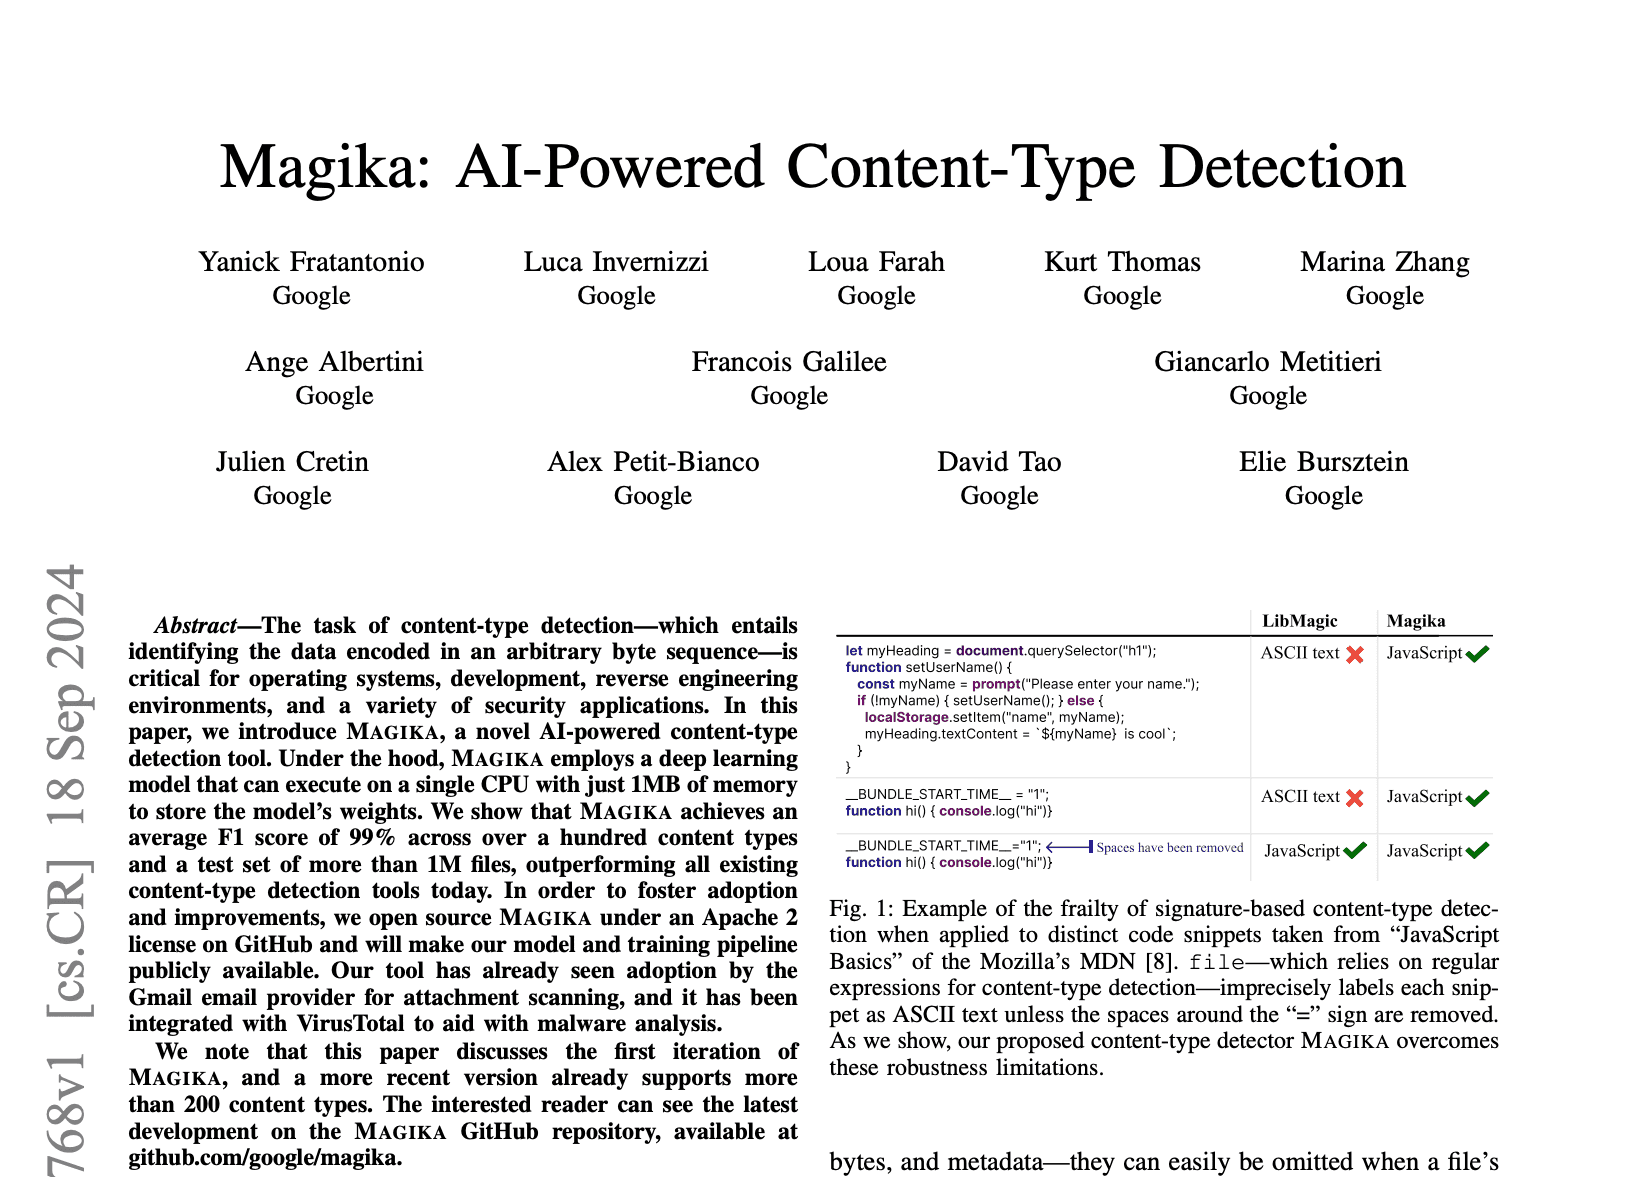
Google 安全研究团队在 2023 年开源的 Magika,就是来解决这件事的——用深度学习模型直接读文件内容的字节流,判断它真实是什么类型。模型文件只有 3MB 多,单 CPU 上每个文件约 2 毫秒,216 种类型的平均准确率约 99%。
Magika 的核心逻辑是一条四段式流水线:先由内容解析器(resolver)抽取文件的结构性特征——比如是不是 ZIP 容器、是不是 PE 可执行文件、开头是不是 XML;再由特征提取器把字节流转成数值特征;然后交给 ONNX 深度学习分类模型给出候选类型及置信度;最后由阈值系统逐类型判定:分数够高就相信模型,不够高就降级为「通用文本文档」或「未知二进制数据」这样的保守标签。
这个设计的妙处在于「双保险」:模型负责语义判断(区分 Python 和 JavaScript 这种魔数完全相同、只能靠内容区分的场景),解析器负责兜底(保证 ELF 一定不会被认成文本)。而且推理只读取文件的前若干字节,因此耗时与文件大小基本无关——一个 2GB 的镜像和 2KB 的脚本,识别速度几乎一样。
模型本身经历了多代迭代:v1 只支持约 100 种类型、2.6ms;v2_1 翻倍到 200+ 种类型;v3_0 把推理提速到约 2ms(比 v2_1 快约 3 倍);当前活跃模型 standard_v3_3(2025 年 4 月发布)有 216 种输出类型,并修正了 TypeScript 识别准确率从 85% 提升到 95% 的问题,同时补上了含非 ASCII 字符的文本与 JSON 合成数据集。
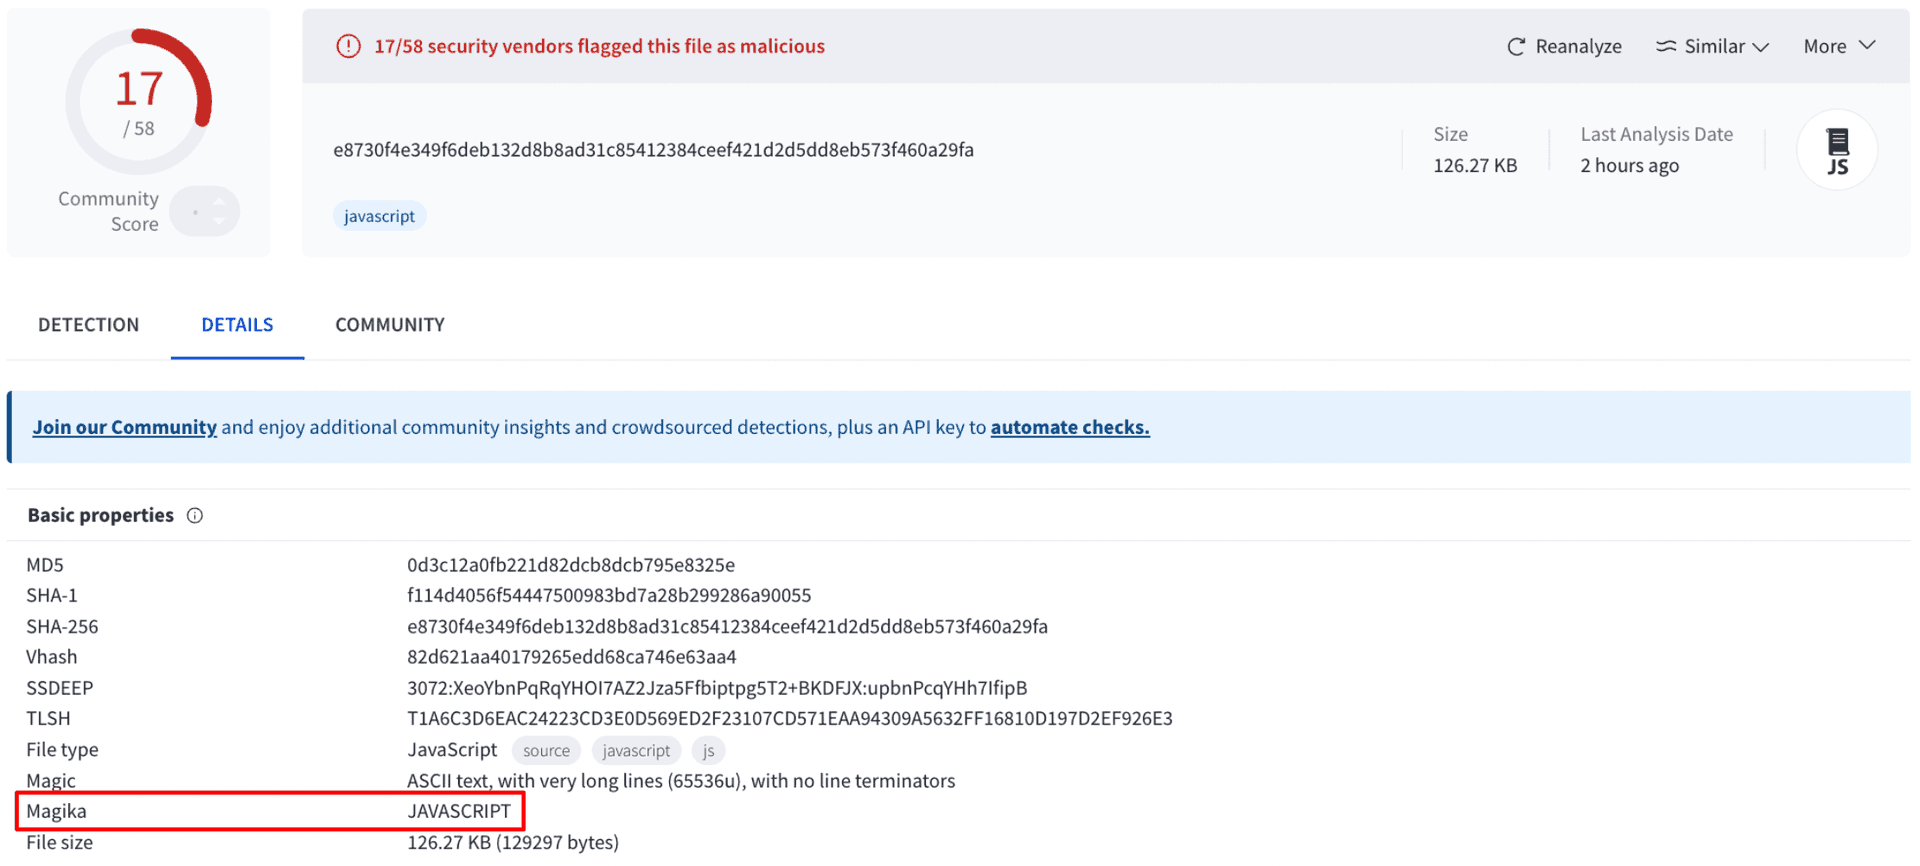
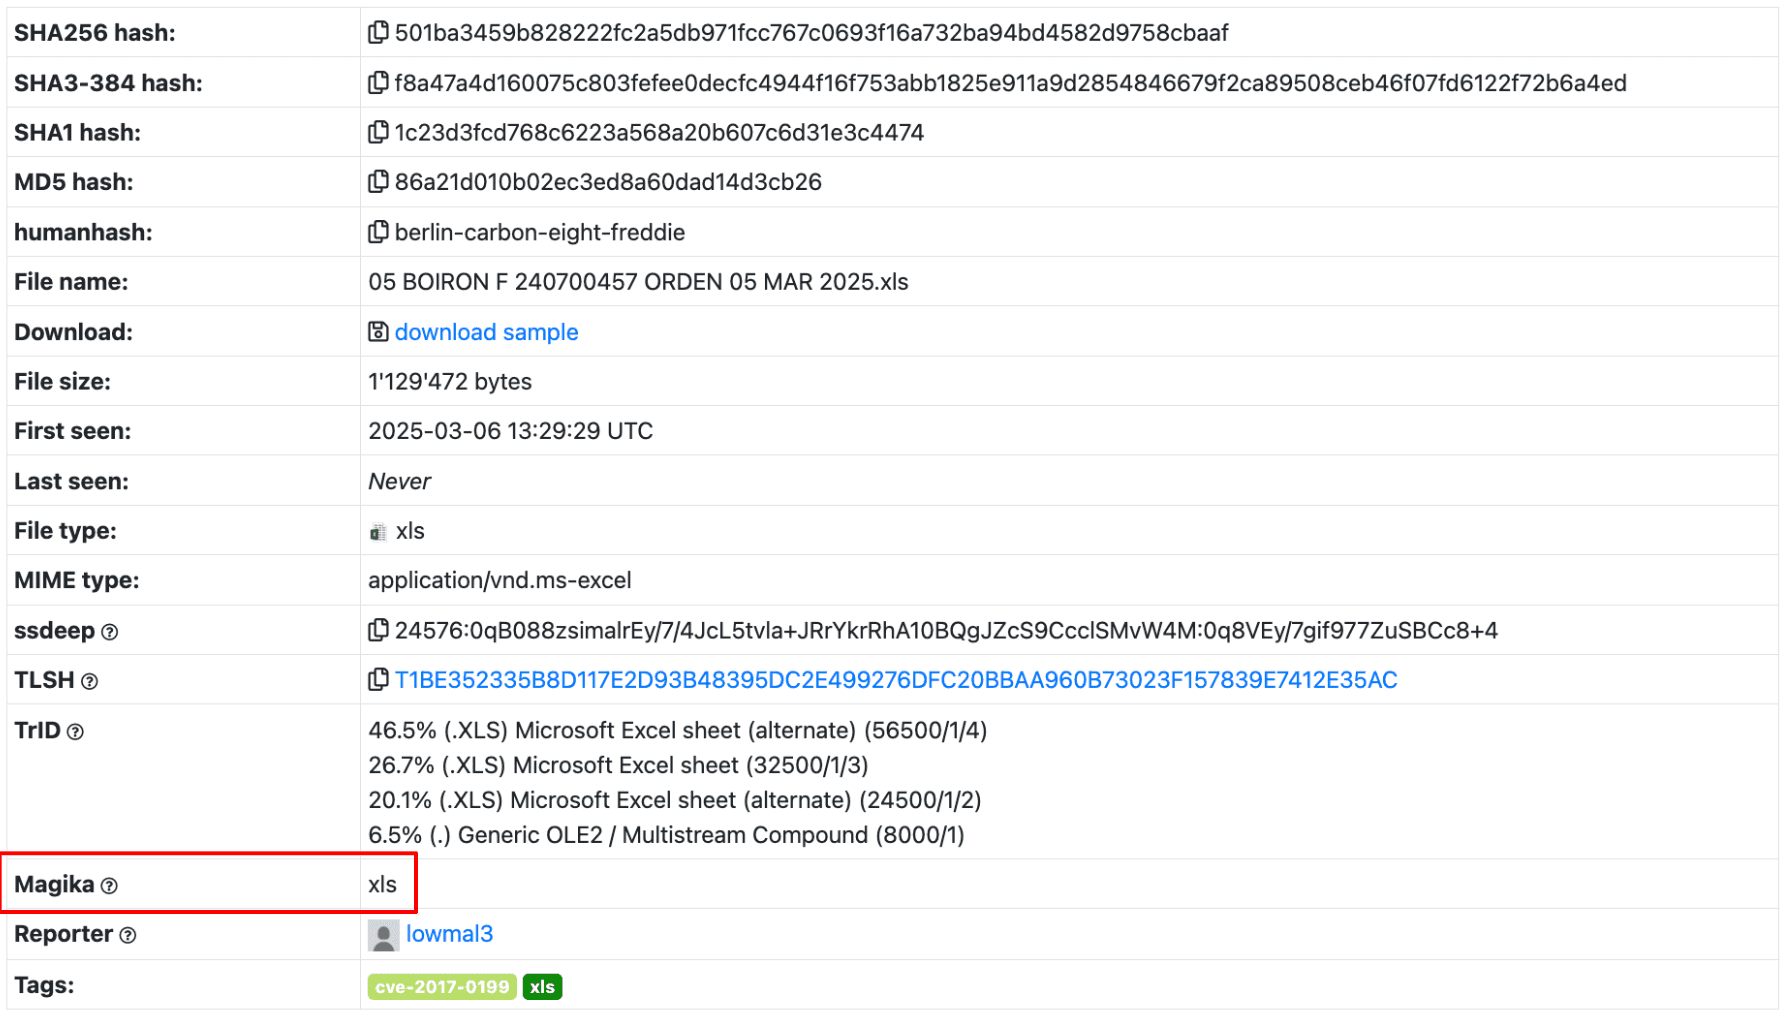
如果传统魔数检测是「看员工工牌」,那 Magika 就是「看这个人真正会做什么」。工牌(扩展名)能伪造,但技能骗不了人——模型看的是你实际写出来的代码内容。abuse.ch 的恶意软件分析师在报告里展示了这个效果:同一个样本,在 VirusTotal 传统引擎里被标为未知类型,接入 Magika 后被正确识别出真实的压缩包/可执行结构。
四端统一,一套模型。Magika 提供 Rust CLI(预编译打包进 Python wheel,避免解释器启动开销)、Python API(PyO3 绑定)、npm 包(浏览器 + Node,基于 TensorFlow.js)和 Go 绑定(走 ONNX Runtime,cgo)四种形态。同一份 standard_v3_3 模型,跨语言结果一致。
可调的容错度。--mode high-confidence / medium-confidence / best-guess 三档预测模式,让调用方在「宁可漏报也不误判」和「尽量给出猜测」之间自己权衡;YARA 规则支持(--custom-rules-file)则允许安全团队叠加自己的检测规则。
典型的落地场景:
上手门槛:最轻的方式是 pipx install magika,然后 magika -r <目录>;想批量处理就用 magika --jsonl 拼进自己的流水线。Go 绑定稍麻烦,需要自行安装 ONNX Runtime 并配置 cgo 编译标签,但官方 go/docker/Dockerfile 已给出一条龙构建路径。
工程细节:仓库提供了根级 Dockerfile(python:3.11-slim 基础镜像、非 root 用户运行、带 HEALTHCHECK),Go 侧还提供多阶段 Dockerfile(构建 ONNX Runtime + 编译 + 拷贝模型到 debian 运行时)。文档站由 Astro + Svelte 构建,代码仓库里连 AGENTS.md 和给 AI 编程助手的贡献指南都备好了——这在 Google 开源项目里不常见。
依赖训练数据,存在「未见类型」盲区。216 种类型之外的文件(尤其是企业内部私有格式、小众二进制协议)会被判为「未知二进制数据」。Magika 的定位是安全扫描的前置路由,而非万能识别器。
首次加载有一次固定开销。模型虽只有 3MB,但加载和会话初始化需要时间,在高并发服务中需要显式做 Runtime 复用——项目里的 Runtime/Session 拆分正是为此设计:Runtime 跨线程共享,Session 各自独立。
模型权重公开意味着可被对抗。攻击者可以针对性构造内容让模型误判。Magika 的应对是「解析器 + 模型」双层校验,但企业使用时仍应保留传统魔数检测作为第三道防线。
JS 生态有版本天花板。npm 包要求 Node.js 22 LTS,因上游 @tensorflow/tfjs-node 兼容性问题,Node 24 暂不支持(issue #1577)。Go 绑定也仍标注为 WIP 状态。
学术与工业的双重身份。Magika 的论文发表于 ICSE 2025,是少数把深度学习真正落地到「日均千亿级文件扫描」生产环境的公开案例,但这也意味着它在训练集构造、数据脱敏和评测方法上并不完全公开,复现难度不低。
Magika 代表了安全领域一条清晰的演进路线:从基于规则的确定性检测,转向基于模型的概率性检测。它的取舍非常明确——放弃 100% 的确定性,换取对文本类内容近乎零误报、对未知格式的巨大覆盖面,且用保守阈值机制把误报控制在可接受范围。
更值得注意的是它的扩散路径:先是 Google 内部服务(Gmail、Drive、Safe Browsing)每周处理数千亿样本,再开放给 VirusTotal、abuse.ch 这类公共威胁情报平台,最终通过 npm/PyPI/Go 包进入开发者日常工具链。从「实验室模型」到「基础设施级组件」,Magika 走完了开源 AI 工程落地最典型的一条路。
对国内团队而言,它的可借鉴价值可能比直接使用更大:把「小模型 + 专用后端(ONNX/tract)+ 极低延迟」这套组合拳用在文件解析、内容审核、数据分类等具体场景上,往往比直接上云端大模型 API 便宜且可控得多。
