
elephant-goldfish-model
google/elephant-goldfish-model加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
图:EGM 官方站点首页,"Design with an elephant. Review with a goldfish."
想象你在给一个支付系统加"Webhook 重试"功能。老手做法是:让 AI 直接改代码,改完跑测试,绿了就提交。上线三天后,你发现同一个事件被投递两次时,幂等键的生成逻辑根本没被定义——因为当时谁也没想过这件事,AI 也不会替你想。
EGM(Elephant-Goldfish Model)改的是这个顺序。先不写一行代码,而是让 AI 和你把"重试"这件事聊透:重试几次、退避策略是什么、幂等键怎么生成、失败后谁来告警。聊完形成一份 Markdown 设计文档,然后把这份文档扔给一个全新的、零上下文的 AI 会话去读。如果这个"金鱼"看完文档都说不清系统怎么跑,说明文档缺上下文;如果它能挑出二十条边界条件,说明文档才是合格的;直到它挑不出毛病,才让 AI 照着文档写代码。
这套方法论出自 Google 工程师 Dave Rensin 的文章《Elephants, Goldfish, and the New Golden Age of Software Engineering》(2026 年 4 月),随后 Google 把内部使用的插件完整开源,仓库名为 google/elephant-goldfish-model。据 Google 开源博客,数千名谷歌工程师每天都在用它发布生产代码。
大象(Elephant) 是那个持有全部上下文的会话:系统历史、架构、组件边界、用户旅程,它负责结构化头脑风暴、追问操作边界、写规格文档。大象记得一切,包括你和它争论过的那些微观决策。
金鱼(Goldfish) 是评审子代理:全新会话、零记忆,只能读设计文档和文档引用到的源码,不带任何前情。它不与大象共享"盲区",所以能发现大象自己看不见的假设缺口。
你(人类) 是决策者。EGM 的核心不是让 AI 自动写完,而是把开发者从"微操写代码"解放成"评审规格"。仓库里 resources/execution_instructions.md 写死了"设计期禁止写生产代码",甚至规定临时草稿只能写在 /tmp/ 之外的源码树位置——AI 想直接动手写实现,插件层面会拦住它。
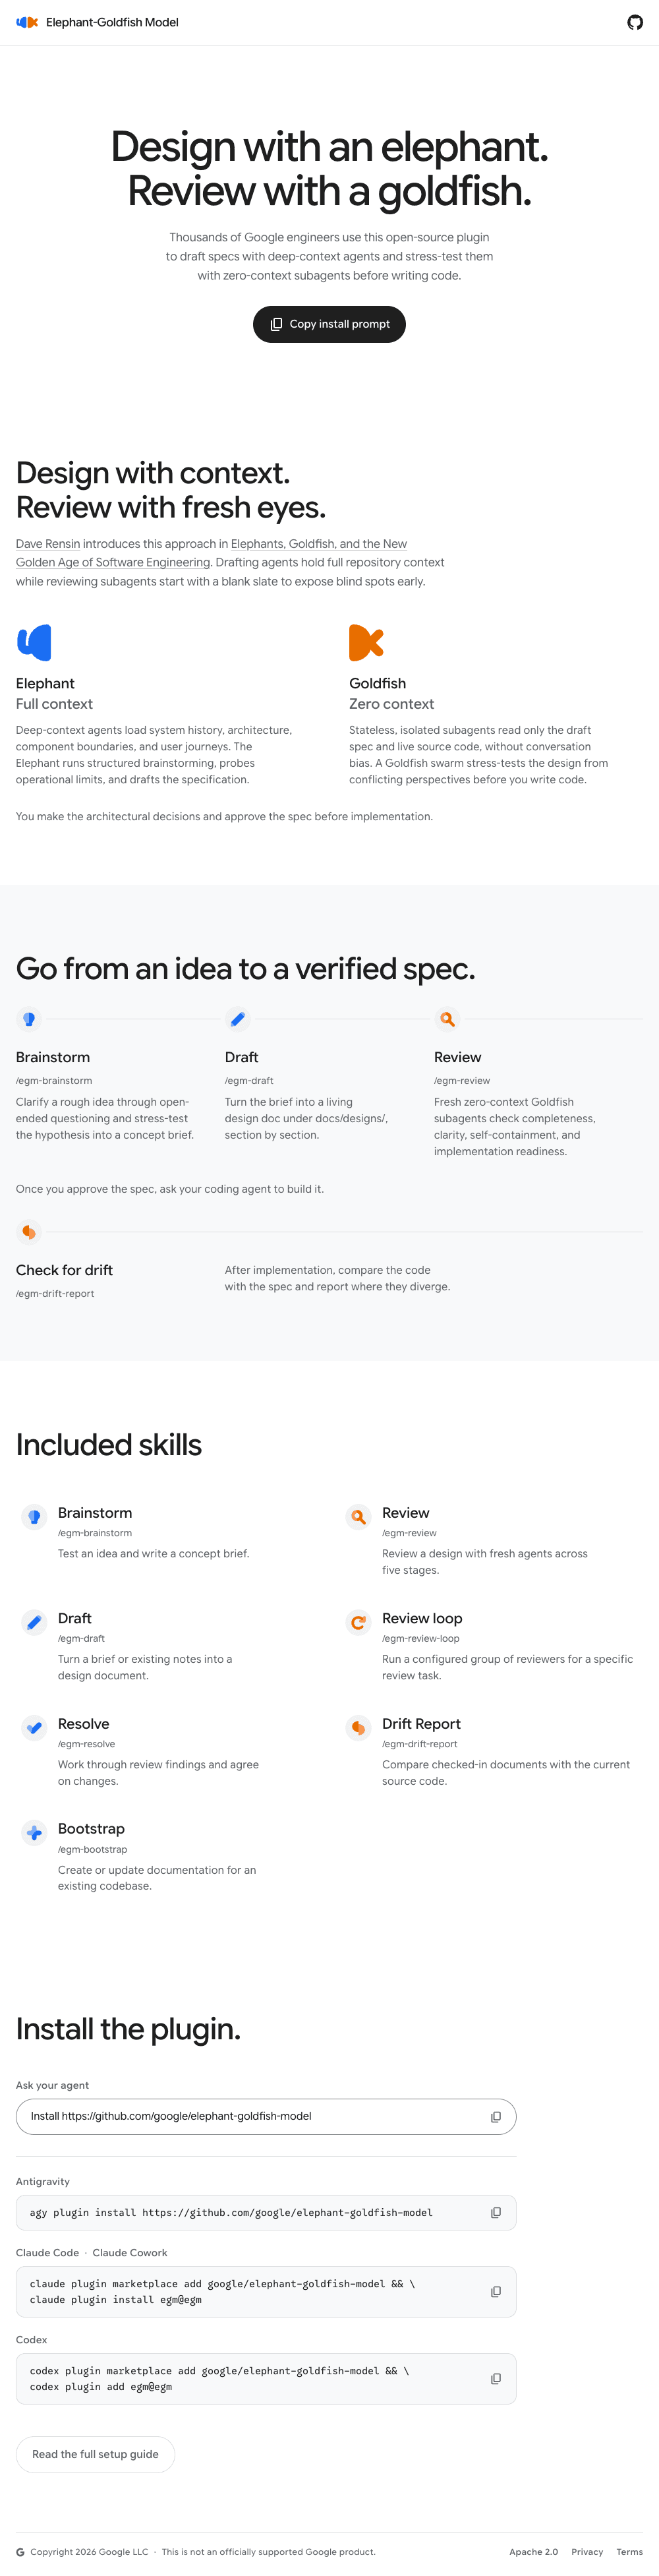
图:EGM 官网完整页面,展示"大象带上下文、小金鱼零上下文"的分工示意
EGM 运行时不含任何模型、不含任何服务,全部是 Markdown 提示词 + YAML 配置 + JSON Schema。核心技能包括:
/egm-brainstorm——开放式追问(强制多轮、每次只问一个问题),再拉起 6 个视角的小金鱼群并行"枪毙"这个想法,产出 concepts_brief.md/egm-draft——把简报逐节编译成 docs/designs/ 下的正式设计文档,每节暂停等你反馈/egm-review——五阶段评审管线:Zoom Out(YAGNI/复用检查)→ 理解测试(能不能复述架构)→ 设计批判(边界条件/瓶颈)→ 实现就绪度(文件路径、函数签名是否齐备)→ 中期 Zoom Out/egm-resolve——把评审发现逐条与你达成修改共识/egm-review-loop——针对特定任务并发调度一组评审者/egm-drift-report——实现完成后比对代码与规格,报告偏离/egm-bootstrap——为已有代码库自底向上补文档对应地,agents/ 目录有 9 个零上下文评审人格(zoom_out、comprehension、design_critic、implementation_readiness、codebase_details、structural、style、synthesizer、bootstrap_orchestrator),resources/document_standards/ 存放 5 套版本化评审准则——评审标准独立成文件,是为了让"评价尺子"本身可被评审。
安装本身极简,三条命令:
claude plugin marketplace add google/elephant-goldfish-model
claude plugin install egm@egm
Codex 用 codex plugin marketplace add + codex plugin add,Antigravity CLI 用 agy plugin install <repo-url>。此外还支持 Claude Cowork 与 ChatGPT Work。
但有一个硬前提:宿主工具必须支持创建全新子代理上下文。Claude Code 用 Agent 工具,Codex 用 spawn_agent,Antigravity 用 invoke_subagent。技能提示词里写得很直白——"如果你的 harness 没有子代理工具,就停下告诉用户:同一上下文里的评审不是金鱼评审"。这意味着单纯的网页版聊天框用不了这个插件。
隐私方面相当克制:EGM 不含托管服务、数据库、遥测端点,不声明 MCP 服务,不装权限钩子。它只调用你已有的宿主模型和权限,因此项目源码的流向由宿主工具的账号设置决定。
第一,成本与时延明显上升。一次完整流程要拉起 6 个小金鱼并行评审,每个都是独立的完整上下文窗口,对 Claude 订阅额度或 API 账单的压力比"直接让 AI 写代码"高一个数量级。
第二,流程强约束可能拖慢小改动。仓库自己也在 FAQ 里承认"EGM 不是唯一的方式",并在 README 明确写着"小而清晰的 bug 修复,用你正常的工作流就好"。真正用它写 800 行新增功能时价值最大,用它改一个 typo 是浪费。
第三,零上下文不等于客观。金鱼评审者依然会给出"约 30% 建议高度有价值"之外的大量噪音。Rensin 自己的经验是反复迭代到建议稳定退化为"吹毛求疵"为止,这需要人工分辨力,插件本身做不到。
第四,**"AI 已经会推理了,这套是不是过时"**的质疑一直存在。EGM 的赌注是:模型越强,代码产出越多,人类越读不完,因此规格文档(而非代码)才是唯一能被人类"署名担保"的产物。Google 用内部数千人规模的生产使用给这个赌注投了票,但对中小团队是否成立,仍取决于团队读文档的耐心。
第五,评测偏弱。仓库的测试主要是提示词结构与打包校验(tests/unit 10 个文件 + tests/integration 覆盖 Claude/Codex 轨迹),并没有量化"用了 EGM 之后缺陷率下降多少"这类指标。9000+ star 里有相当一部分来自 Google 自家员工的关注。
EGM 落在一个更清晰的趋势上:编码工具的竞争焦点从"生成质量"转向"上下文编排质量"。当所有模型都能写出可用的代码,差异化就转移到"如何分配上下文、谁该看什么、谁该忘记什么"。
而且 EGM 把"设计文档"重新推回工程流程的中心位置——甚至在实现阶段强制"照文档逐字执行"。这是对 AI 生成代码可维护性的一种制度性防御:设计判断左移到文档里,文档被评审过,代码才允许被生成。
Google 选择的开源姿态也很说明问题:一个内部已规模化使用的方法论,把提示词、人格、评审准则、发布流水线、官网(连同 Astro 截图脚本)一并开源。从 commit 节奏看,仓库从 2026 年 9 月创建到 11 月初仍在高频推送,是活跃维护状态。
Apache-2.0 协议,20 位贡献者,主语言 Python(仅用于测试与打包),官网 egm.dev。如果你在用 AI 编码工具并且已经感受到"代码越写越多、越读越不懂"的问题,这套方法值得先试一轮。
说明:EGM 不是 Google 官方支持的产品,仅以 Apache-2.0 开源。
