
harness2
google-research/harness2加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一幕。你给 AI 编程助手布置一个任务:把这个仓库的单元测试覆盖率从 60% 提到 80%。模型很聪明,一次性就能写出看起来相当不错的补丁。但如果你把同一份任务文档交给团队里另外三个人——一个偏好先读文档再动手、一个习惯先写复现用例、一个总在提交前跑一遍完整 lint——他们做出来的东西,质量会有肉眼可见的差别。
模型权重完全相同,差别出在哪?出在模型外围的那层东西:系统提示词怎么写、给了哪些工具、记忆放在哪、有没有护栏、能不能派子代理、有哪些技能可用、有哪些脚本可以调用、插件怎么挂。
Google Research 把这层东西正式命名为 harness(执行框架),而 Harness² 要做的事更激进一层:让智能体在干活的过程中,自己动手修改这层框架,并把经验沉淀下来影响未来的任务。
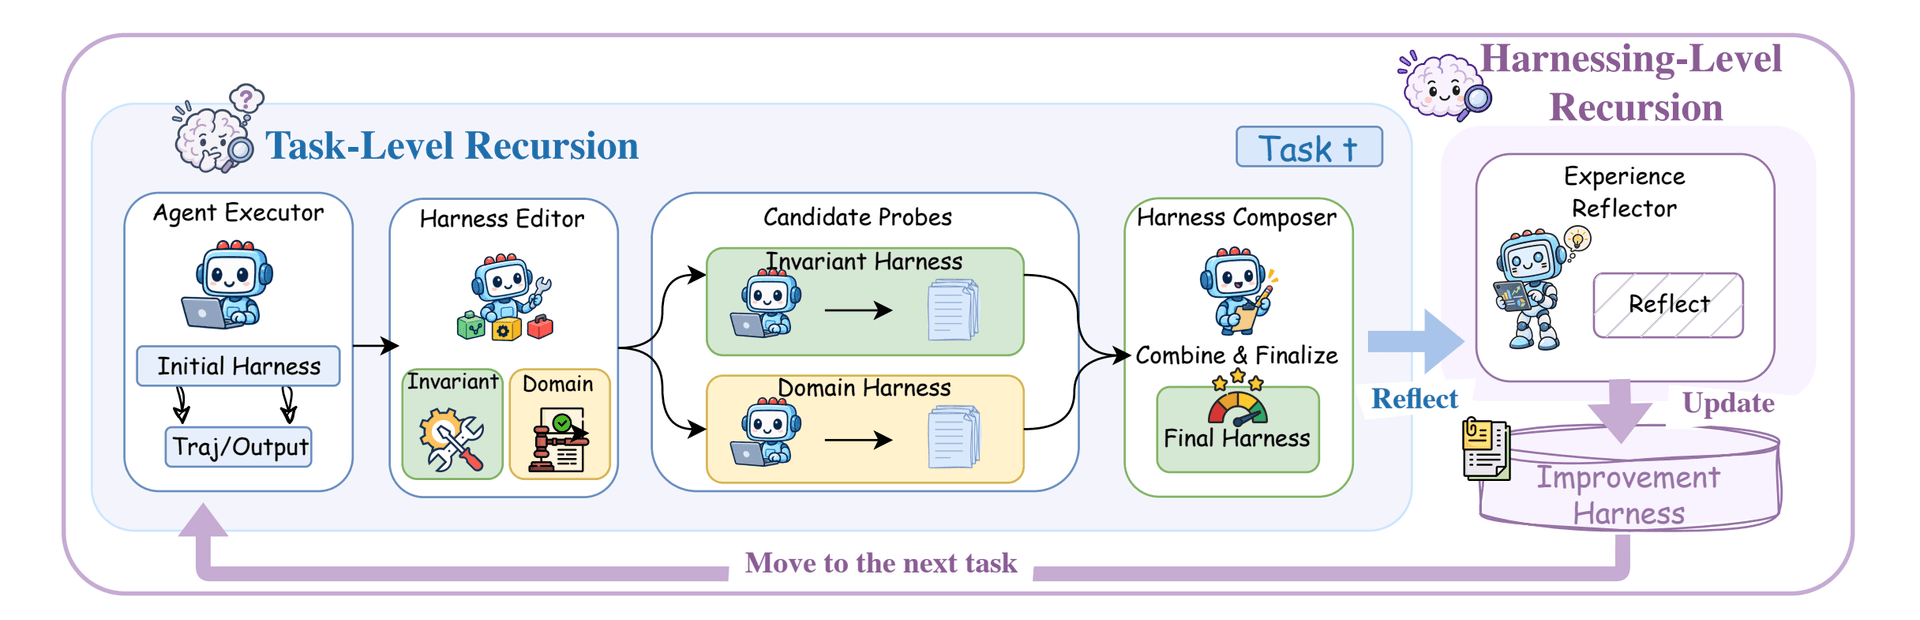
图:Harness² 流水线。上半部分为任务级递归——智能体执行器跑初始 harness,harness 编辑器提出通用与领域性修改,候选探针执行这些修改,harness 合成器基于执行证据组合出最终 harness;下半部分为框架级递归——经验反思器把本轮经验写回改进 harness,供下一个任务使用。
这个区分是整个项目的立身之本。
微调权重是一次性的、昂贵的、需要标注数据的,而且一旦权重变了,你很难回答"这次到底是哪条指令起了作用"。Harness² 走的是另一条路:模型权重冻结不动,只改模型外面的配置。
打个比方。同样一位厨师(模型),配上不同的厨房动线、火候说明、备菜顺序、刀具清单和调味笔记(harness),出来的菜就是不一样。Harness² 研究的是:能不能让厨师自己在做完一道菜之后,回头调整自己的厨房动线,而且下一次做菜时真的用上了。
Harness² 暴露了八个可编辑组件:
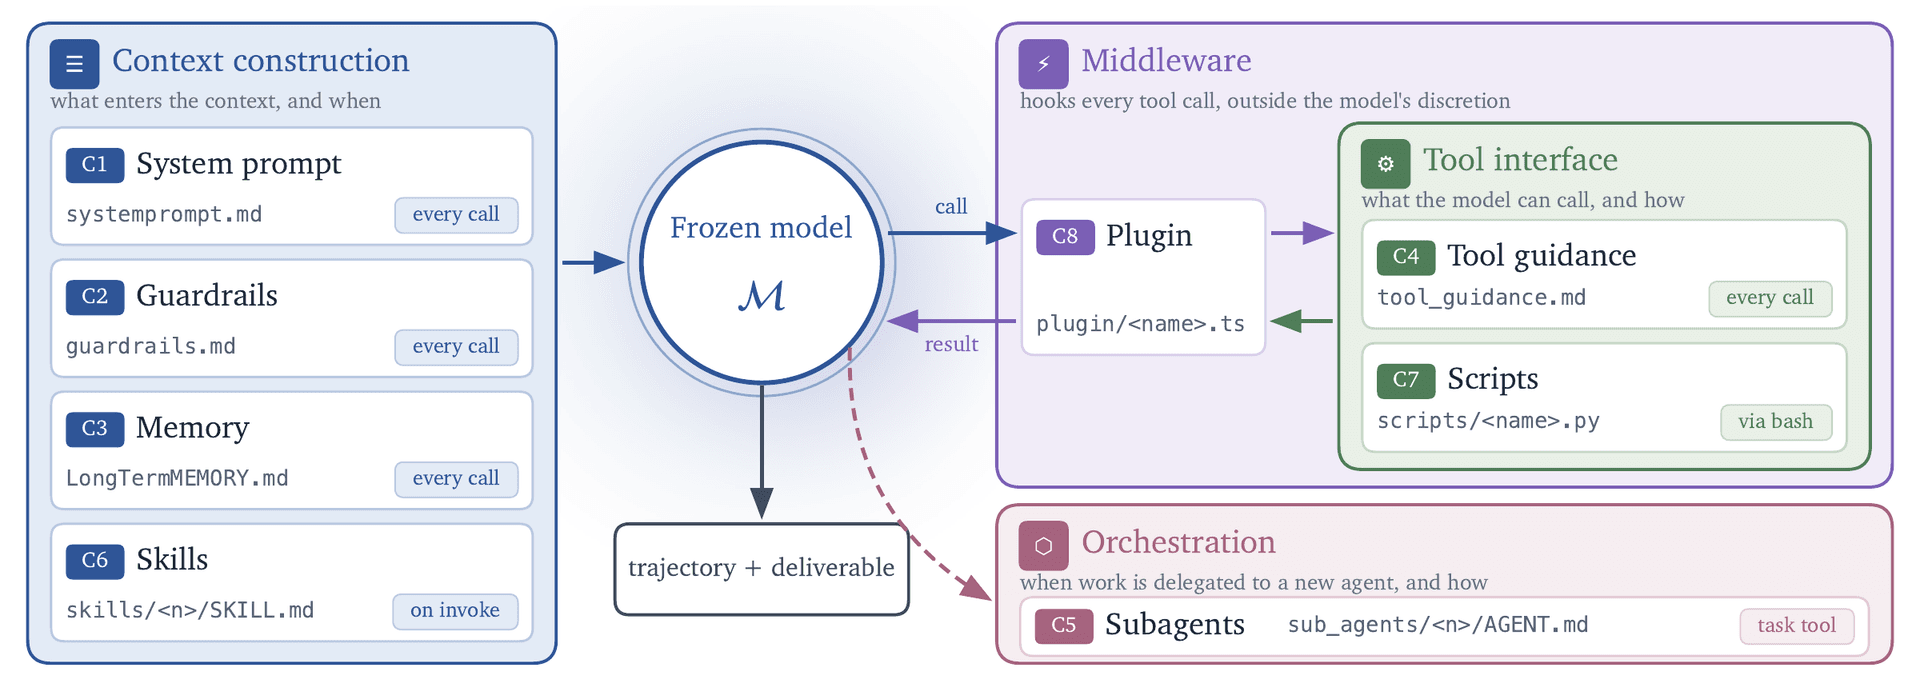
图:八个组件按运行时角色分为两组——system prompt、guardrails、memory、skills 负责上下文构建;tool guidance 与 scripts 定义工具接口;subagents 编排委派工作;plugins 控制中间件行为。
整个框架的心脏是一个三步循环,但它绕开了大家最容易想当然的一个问题。
天真的做法是:让模型看一眼任务结果,说"这里不好,改成那样",然后直接采纳。这正是很多"AI 自动优化提示词"工具的做法,问题在于——输出看起来更漂亮,不等于答案更正确。
Harness² 的做法是引入"行为对比":
harness2-bridge 起一个 LiteLLM + FastAPI 网关,把 Vertex AI 上的模型包装成 Codex 需要的 Responses API 端点。论文明确指出:整个过程不使用 ground-truth 验证器(no ground-truth feedback)。它靠的是"这次跑和那次跑的行为不一样"来推断哪个修改有效。
这个设计取舍很关键,也正是它的软肋——行为差异能说明"修改起了作用",但说明不了"修改后的结果是正确的"。
Harness² 同时跑两个嵌套的循环:
经验库(experience library)按领域(domain)组织,保存采纳的 harness 树(adopted harness tree)和一份 EXPERIENCE.md,解释为什么采纳、解决了什么反复出现的弱点。下一次任务不会盲目继承上次的完整执行 harness,而是从公共 base 出发,同时参考历史采纳的配置与教训。
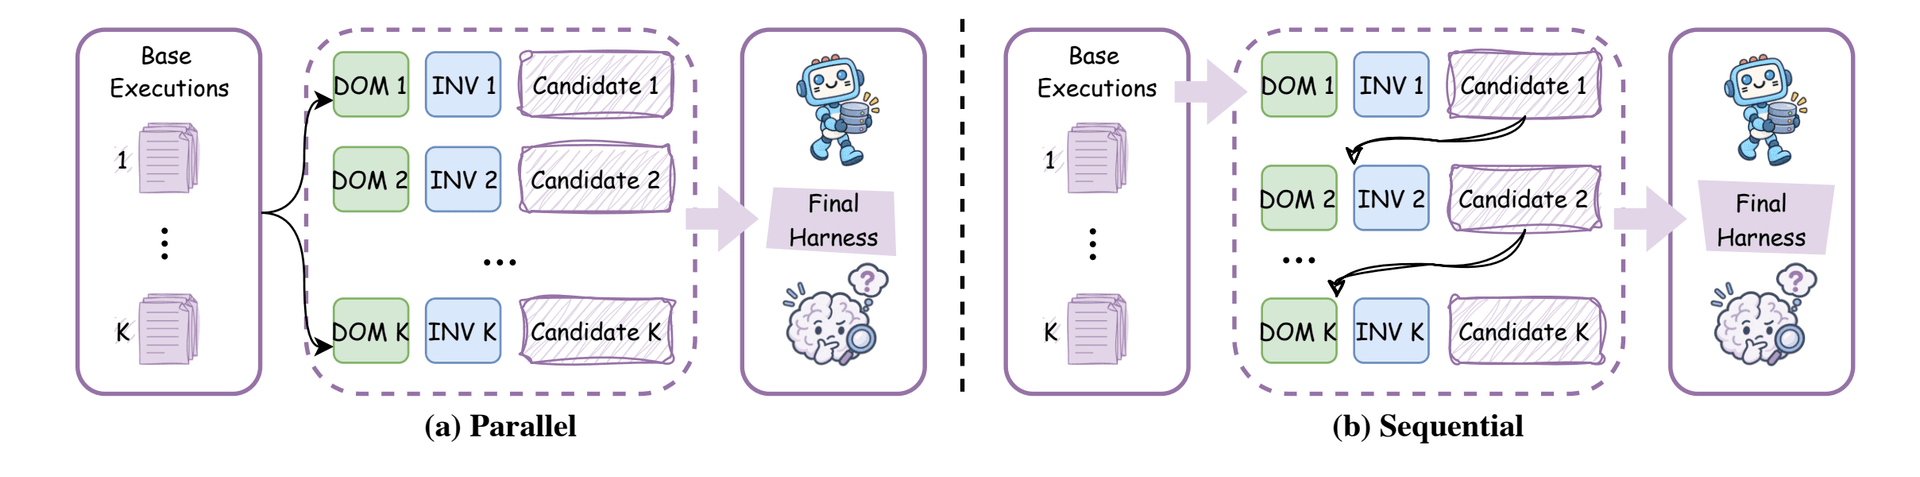
图:并行模式探测 k 个通用与 k 个领域特定候选 harness,再从共享证据产出 k 份组合;串行模式把精炼后的 harness 与累积证据带过 k 个连续的 Propose–Probe–Compose 步骤。
预算参数 --k 控制任务级递归的探索量。
| 参数 | 行为 |
|---|---|
--k 1 | 一轮 Propose–Probe–Compose |
--k K --mode parallel | 探测 K 个通用 + K 个领域特定候选,产出 K 份组合 |
--k K --mode sequential | 连续 K 轮精炼同一个 harness |
--substrate cx | 用 Codex 替代默认的 OpenCode 执行器 |
官方 README 里的说法很精炼:"并行递归探索得更宽,串行递归精炼得更深。"
工程上,串行模式的调度成本是实打实的:recursion.py 的文档字符串写明,每个模式要调度 4k 次 rollout 和 3k 次改进阶段(含共享的 base 执行),非法提案还会获得一次重试。k 翻倍,模型调用量大约翻四倍。
Harness² 提供了两级体验:
uv venv --python 3.12 .venv
source .venv/bin/activate
uv pip install -e '.[render]'
harness2-demo --output runs/demo --k 2
这个 demo 使用**确定性编辑器(deterministic editors)**和真实的 Python 执行,跑通两种递归模式,不需要 API Key。这是最快的验证路径。
cp .env.example .env
gcloud auth application-default login

harness2-setup lab
harness2-check --bench lab
harness2 --bench lab --k 1 --mode parallel --only-domains antitrust-competition --max-tasks 1
harness2-judge --bench lab --k 1 --mode parallel
harness2-report --bench lab --k 1 --mode parallel
支持三个专业基准:
| 基准 | 领域 | 额外依赖 |
|---|---|---|
| JobBench | 专业工作 | — |
| LAB | 法律工作 | Pandoc、Poppler-utils |
| WorkBuddy-Bench | 办公、网页、代码 | Docker Engine |
注意 CLI 的严格性:judge 和 report 必须使用与精炼运行完全相同的基准、执行器、子集、--k、模式和随机种子,否则结果无法对齐。
在三个专业基准、四种"模型–harness"配置上,单步 Harness² 相对各自的基础 harness 带来的提升:
涉及模型包括 GLM-5 和 Gemini 3.5 Flash。提高任务级递归预算还能进一步增益。
这里必须加三条限定:
这部分比成绩单更有价值。
第一,它本质上是研究代码。 仓库免责声明写得很直白:"This is not an officially supported Google product.",并且明确声明不符合 Google 开源软件漏洞奖励计划。版本号是 0.1.0。
第二,安全性提示非常具体,值得逐字读。 README 的 "Web access" 一节说明:执行器的网络访问不受限制,Codex 运行时沙箱被禁用。公开的基准评分细则可能在互联网上可访问——也就是说,智能体有可能直接去搜答案。作者的建议是在评测前配置网络限制,防止访问基准答案和评分标准。
对企业的直接含义:**不要把机密文件挂到一个无限制网络出口、且写工具无边界的研究代码上。**先用一个已知任务、小规模、隔离环境跑通,并设置明确的复核规则。
第三,没有 ground-truth 的自我优化存在根本局限。 论文自己承认:额外推理成本,以及"在没有标准答案的情况下做行为对比,无法保证正确性"。这是方法论层面的天花板,不是工程 bug。
第四,成本会超预期。 4k rollouts + 3k 改进阶段意味着 k 的代价是二次的。模型驱动的运行会产生真实 API 费用,README 也建议"先从少量任务选择开始"。
第五,代码体量与贡献者规模偏小。 仓库共 152 个文件、58 个 Python 文件,核心包 harness2/core/ 下 13 个模块(context.py 21KB、prompts.py 66KB、schedule.py 30KB 较大),但测试只有 1 个文件 tests/test_workflow.py(10.5KB),GitHub contributors 端点返回 2 位贡献者(rux001 2 次提交、cuizz11 1 次提交),117 个 open issues。核心依赖为空(dependencies = []),可选依赖是 render(openpyxl、python-pptx)与 bridge(litellm、fastapi、google-auth)。这类"论文配套代码"的典型特征:逻辑密度高、测试覆盖薄、维护人力少。
"Harness"这个词正在从学术圈溢出到产品圈,而且已经不只是 Google 一家的说法:
DeepSeek-Harness 的运行时。这不是巧合。行业共识正在形成:模型层在快速趋同,差异越来越多地出现在执行层。当基础模型能力差距缩小,"模型 + 一套精心设计的执行框架"才是完整的竞争单元。
Harness² 在这个趋势里的位置很特殊——它不提供新的运行时产品,而是提供一把手术刀:用来研究"执行层本身能不能被自动优化"。如果这条路走得通,未来每个 agent 产品都可能内置一个类似机制:让智能体在完成任务后自动优化自己的提示词、工具集与工作流。
harness2/
├── core/            # 核心算法
│   ├── recursion.py     # 并行/串行任务级递归调度
│   ├── proposer.py     # 候选 harness 修改提案
│   ├── prompts.py      # 提示词模板(66KB,最大文件)
│   ├── schedule.py     # 阶段调度
│   ├── context.py      # 上下文构建
│   ├── tree.py         # harness 树结构
│   ├── library.py      # 经验库
│   ├── ledger.py       # 成本/调用账本
│   ├── judge.py / report.py / runmark.py / selection.py / spec.py
├── substrate/       # 执行器适配层
│   ├── opencode.py     # 默认执行器
│   └── codex.py        # Codex 执行器
├── benchmarks/      # 三个基准适配
│   ├── jobbench.py / lab.py / workbuddy.py
├── cli/             # 8 个命令行入口
│   ├── run_sweep.py / judge.py / report.py / setup.py / check.py / demo.py / bridge.py
├── install.py / preflight.py / config.py
CLI 入口对应 pyproject.toml 里的 scripts:harness2、harness2-judge、harness2-report、harness2-setup、harness2-check、harness2-demo、harness2-bridge。代码风格由 ruff 管理,target py312,line-length 100。
Harness² 是一次认真的、有明确理论框架的研究发布。它把"智能体可以自己改进自己的执行环境"这件事,从直觉变成了有算法、有基准、有可运行代码的工程问题。Propose–Probe–Compose 的核心洞察——用行为对比代替直觉判断——是可以在其他 agent 框架里复用的工程思路。
但它同时也是典型的"论文配套代码":测试单薄、贡献者稀少、依赖 Vertex AI 生态、强制 Linux、真实跑一次要付 API 费、安全边界宽松。
适合:AI 工程师做架构研究、想在自有 agent 上实验"自动优化 harness"、研究 agent 评测方法。 不适合:直接引入生产环境、期待一键部署、期望开箱即用的业务功能。
如果你想动手,最低成本的路径是:Linux + uv + harness2-demo,零凭据跑通两种递归模式,看懂数据流之后再决定要不要接 Vertex AI。
