
AI4U
gilzamir18/AI4U加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象你正在开发一款 3D 动作游戏,NPC 需要学会在复杂地形中导航、躲避障碍、与玩家互动。传统方案是写大量 if-else 规则——结果 NPC 行为机械、无法应对未见过的场景。强化学习(RL)是更好的解法,但自己搭训练环境费时费力。
AI4U 解决的就是这个问题:它把 Godot 游戏引擎变成一个开箱即用的 RL 训练环境。你在 Godot 中用可视化编辑器设计 NPC 的传感器(摄像头、距离雷达、碰撞检测等)和执行器(移动、跳跃、攻击等),然后在 Python 侧用 stable-baselines3 的 SAC/PPO 算法训练,训练完成后把模型导出为 ONNX,直接塞回 Godot 里跑推理。
这个"游戏引擎训练 + Python 强化学习 + ONNX 推理部署"的闭环,是 AI4U 最核心的价值主张。
AI4U 的作者是巴西伯南布哥联邦大学(Federal University of Pernambuco)的研究员 Gilzamir Gomes。该项目从 2018 年左右开始持续迭代,至今已发展到 0.5.0 版本。
项目定位清晰:不做通用 AI 框架,而是专注文游戏 AI / 虚拟环境中的强化学习智能体训练。它的技术选型也反映了这一聚焦:C# 写 Godot 插件(高性能、与引擎深度集成),Python 写训练脚本(借助 stable-baselines3 的成熟 RL 算法生态)。
GitHub 页面:84 颗星、MIT 许可证、话题标签涵盖 artificial-intelligence、games、reinforcement-learning-environments、virtual-reality。
AI4U 的核心抽象是 RLAgent 类,它规范了智能体与环境交互的完整生命周期:
OnResetStart(重置开始)、OnEpisodeStart/End(回合开始/结束)、OnStepEnd(每步结束)。通过 C# 事件委托注册自定义逻辑。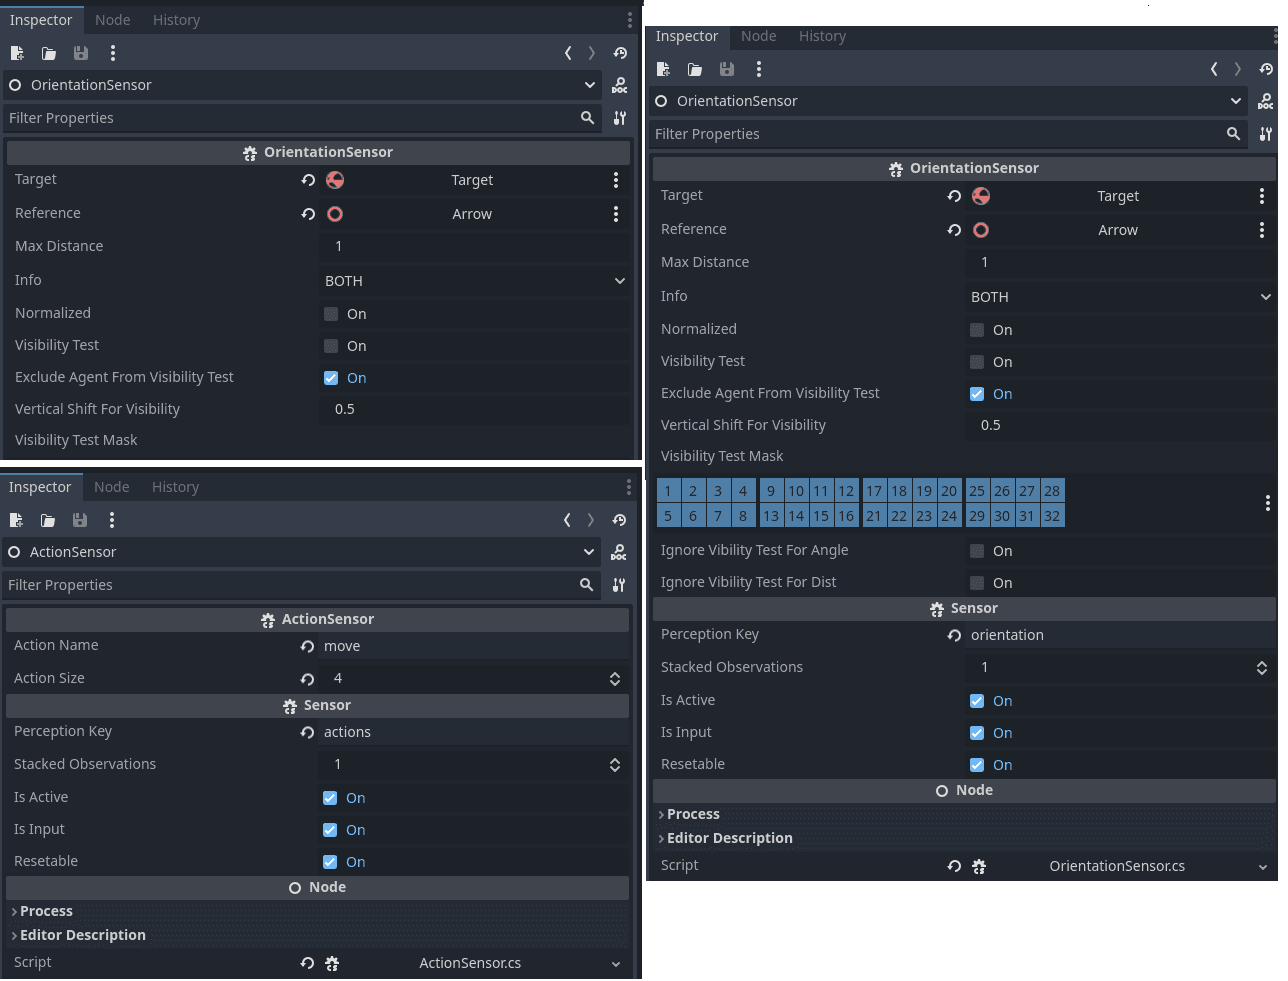
这是 v0.5.0 引入的新特性,目的是降低训练门槛。项目提供基于 stable-baselines3 的 SAC 算法模板:
# 向量观察空间(MLP 网络)
python -m ai4u_ml.sb3_sac_trainer --policy=MlpPolicy

# 图像观察空间(CNN 网络)
python -m ai4u_ml.sb3_sac_trainer --policy=CnnPolicy

# 混合输入(图像 + 向量)
python -m ai4u_ml.sb3_sac_trainer --policy=MultiInputPolicy
无需手写训练脚本,直接调命令即可启动训练。参数(层数、学习率等)可通过命令行自定义。
训练完成后,通过 ai4u_onnx 包将 PyTorch 模型导出为 ONNX 格式,在 Godot 端用 Microsoft.ML.OnnxRuntime 加载,实现零 Python 依赖的推理运行时。这意味着游戏发布时不需要附带 Python 环境,ONNX 模型可以直接在 Godot C# 侧运行。
┌─────────────────────────────────────────────┐
│           Godot Game Engine (C#)             │
│  ┌──────────────────────────────────────┐   │
│  │  RLAgent (核心节点)                   │   │
│  │  ├── 传感器 (Sensors)                 │   │
│  │  ├── 执行器 (Actuators)               │   │
│  │  └── 奖励函数 (Reward Functions)      │   │
│  └──────────────────────────────────────┘   │
│  Addon: ai4u, ai4u_onnx, ai4u_prefabs3d    │
└─────────────────────────────────────────────┘
                    ↕ 观察/动作数据交互
┌─────────────────────────────────────────────┐
│        Python Runtime (ai4u / ai4u-ml)      │
│  stable-baselines3 → SAC/PPO 训练           │
│  PyTorch → ONNX 导出                         │
└─────────────────────────────────────────────┘
关键设计选择:为什么训练用 Python 而非直接在 Godot 里跑?
作者在文档中有明确解释——Python 侧有完整的 DRL 算法生态(stable-baselines3),而 Godot 侧目前还没有成熟实现。TorchSharp 虽然存在,但缺乏完整的 DRL 算法支持。因此 AI4U 采用"训练在 Python、推理在 Godot"的混合架构,这是务实的技术权衡。
前置依赖:
安装步骤(简化版):
ai4u.zip 解压到项目目录pip install ai4u-ml作者提供了配套的示例项目仓库,包含 BoxChase(追逐盒子)、Platform2D(2D 平台跳跃)、Jumper(整合 Godot 动画系统)等参考实现。
硬件门槛: 文档明确标注——简单场景 GTX 1050ti 可行,图像传感器 + SAC 训练建议 24GB RAM + 高端 GPU。
AI4U 的文档中有一个有趣的部分叫"Don't Break the Game"——作者坦诚地警告:RLAgent 类虽然可以继承,但自定义智能体类"非常困难"。这不是谦虚,而是经过大量实践得出的结论。
其他已知局限:
AI4U 代表的趋势是游戏 AI 开发的范式转变:从手工编写行为树/状态机,转向用强化学习让 NPC 自己"学会"行为。这在学术研究(强化学习环境构建)和工业应用(游戏 NPC AI、仿真训练)两个方向都有价值。
项目的增长速度不算快(84 ★),但维护活跃度高,文档相对完善,在强化学习 + 游戏引擎这个交叉领域,是为数不多的开源完整解决方案之一。随着 Godot 4 的生态日趋成熟,AI4U 的使用门槛有望进一步降低。
一句话总结:如果你想在游戏里训练 NPC 或构建虚拟 AI 实验环境,AI4U 是目前最省力的起点。
