
OpenVitamin
fengzhizi715/OpenVitamin加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2024 年,大模型狂飙突进一年后,一个尴尬的现实浮出水面:大多数开发者和 AI 爱好者仍在「调 API - 看结果 - 调 Prompt」的循环里打转。每月烧掉几百块的 API 费用,模型却始终运行在别人的服务器上——数据要上传、回复要等待、额度要抢购。更让人头疼的是,当你想把本地部署的 Ollama 模型、某款文生图工具和一套 RAG 知识库串联起来,形成一个真正的 AI 应用时,发现没有现成工具能把这几块拼在一起。
OpenVitamin 正是在这个节点出现的一个开源项目。它给自己的定位是「本地优先的 AI 执行平台」,目标是把:大模型推理(LLM/VLM)、文生图、图片生成、多智能体编排和工作流自动化,这五块能力统一到一个 Web 控制台里,让用户在自己的机器上就能拥有一个完整的 AI 应用开发与运行环境。
OpenVitamin 由 GitHub 用户 fengzhizi715 开发维护,项目采用 Apache-2.0 开源许可证,核心代码由 Python + Vue 3 构成,目前在 GitHub 上拥有 72 颗星。
从项目的技术文档来看,作者的核心诉求是解决「本地 AI 能力碎片化」的问题:Ollama 跑本地模型、diffusers 做图生图、各种 API 对接云端模型——这些能力散落在不同工具里,没有统一的入口、没有统一的管理、没有统一的调用方式。OpenVitamin 的思路是用一个 FastAPI 网关把这些能力全部收拢进来,前端用 Vue 3 做成一个控制台,所有交互通过网关统一出口,不允许前端直连模型或工具——这个设计原则被写进了项目的 AGENTS.md 中,是整个架构的基石。
项目的技术话题(topics)涵盖了:agent-orchestration、llama-cpp、local-ai、multi-model、rag、workflow 等二十余个关键词,定位非常明确:面向需要私有部署 AI 能力、追求数据隐私的开发者和技术团队。
OpenVitamin 采用了经典的 前后端分离 + 网关中枢 架构,整体分为三层:
第一层:Web UI(Vue 3 + Tailwind CSS)
前端使用 Vue 3 + TypeScript + Vite 构建,UI 库选用 radix-vue 和 reka-ui 组件,路由由 vue-router 管理,图标使用 lucide-vue-next。支持深色模式,界面风格偏现代化的控制台 Dashboard,提供五大核心功能页面:聊天(Chat)、模型管理(Models)、智能体(Agents)、工作流(Workflow)和知识库(Knowledge)。
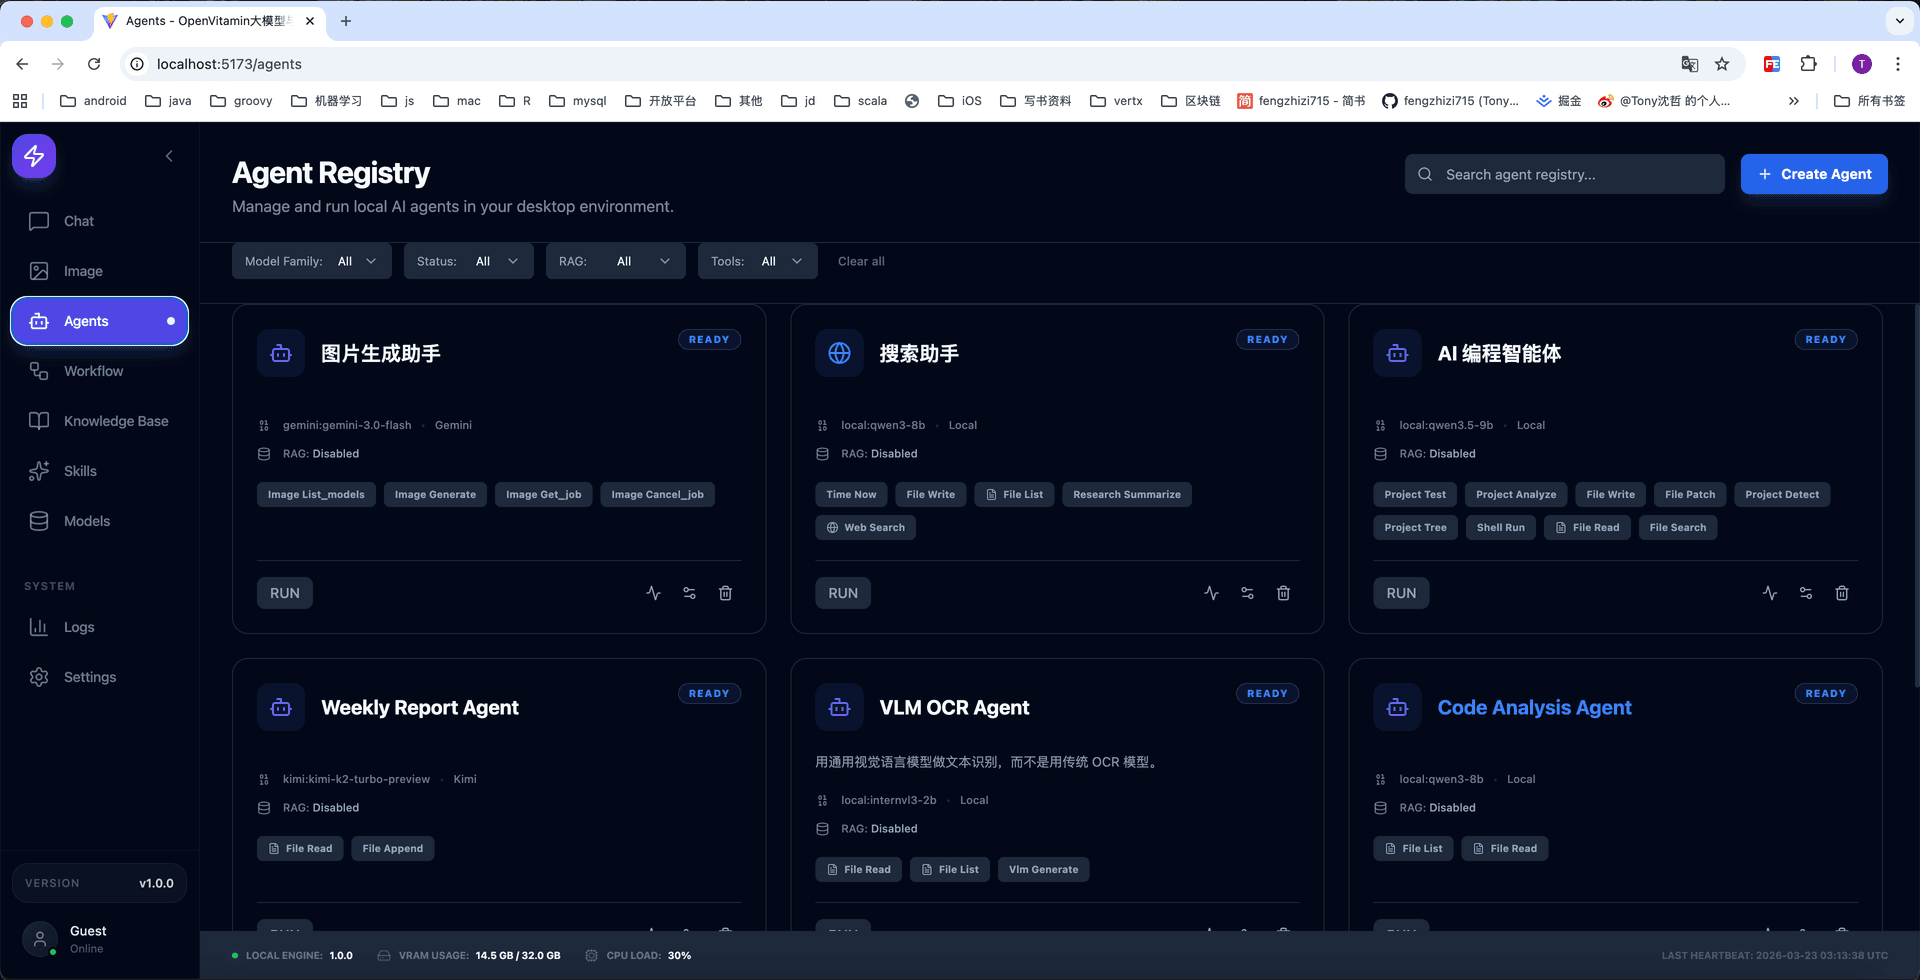
图:智能体管理界面,支持 Skill 发现、Tool 调用等核心功能
第二层:FastAPI 推理网关(核心中枢)
这是整个平台最关键的部分。FastAPI 网关负责统一接收前端请求,根据请求类型路由到对应的推理后端或能力模块。网关支持接入的模型类型包括:
网关还内置了 Execution Kernel(执行内核),负责并发队列管理、模型实例生命周期管理和资源调度。值得注意的是,项目中包含 execution_kernel/ 完整目录,涵盖 engine、analytics、cache、optimization、persistence、replay 等子模块,体现了作者对系统稳定性的重视。
第三层:运行时与模型层
底层是实际的推理运行时,支持多种后端并存:
这意味着,用户可以在同一套平台里,让本地跑的 Ollama 模型和云端 API 模型共存,由网关统一决定请求路由到哪个后端。
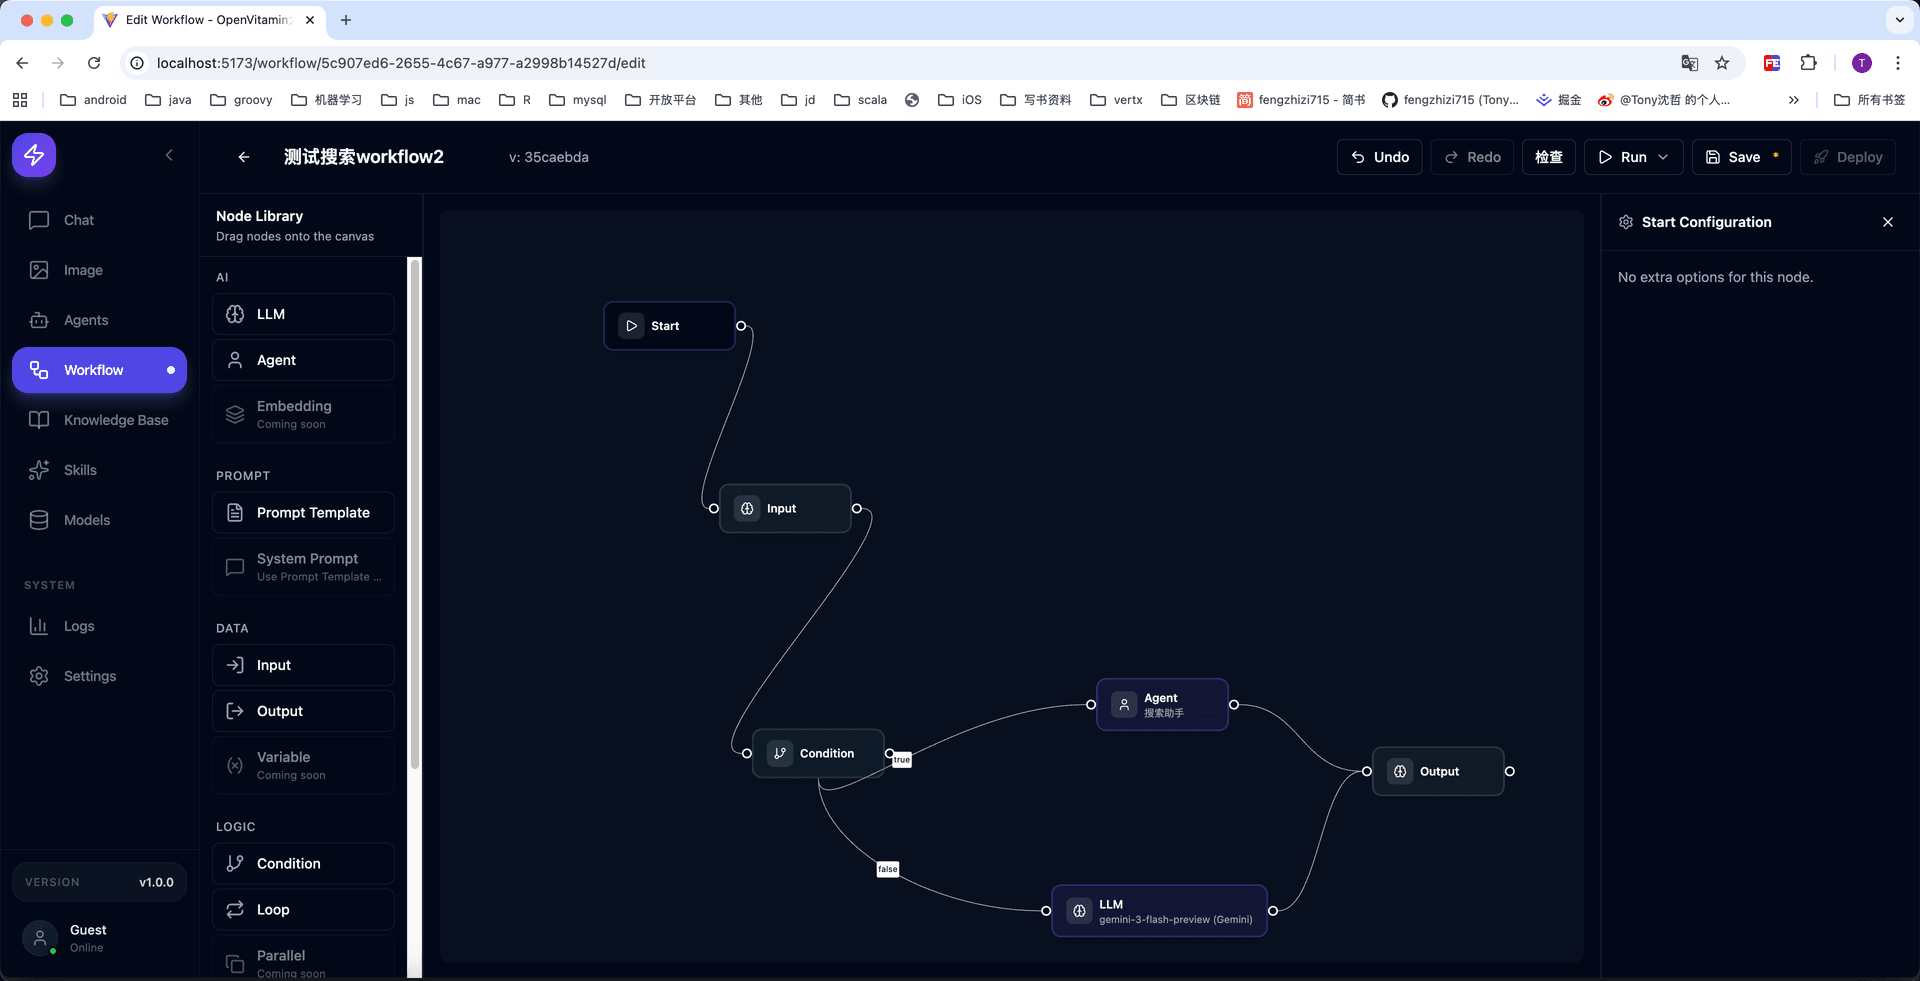
图:工作流编排界面,支持版本化、执行历史和分支/循环治理
OpenVitamin 的 Agent 系统并非「自主决策型」通用智能体,而是一套规则驱动的执行框架。AGENTS.md 中明确定义了四个设计原则:用户始终掌控(Agent 不得擅自改变用户意图)、以网关为中心(所有模型调用必须经过网关)、确定性优于魔法(禁止隐藏 Prompt 和隐式参数注入)、插件优先(新能力优先设计为插件)。
智能体支持的核心能力包括:
工作流模块参考了现代 CI/CD 系统的设计理念,提供完整的工作流生命周期管理:
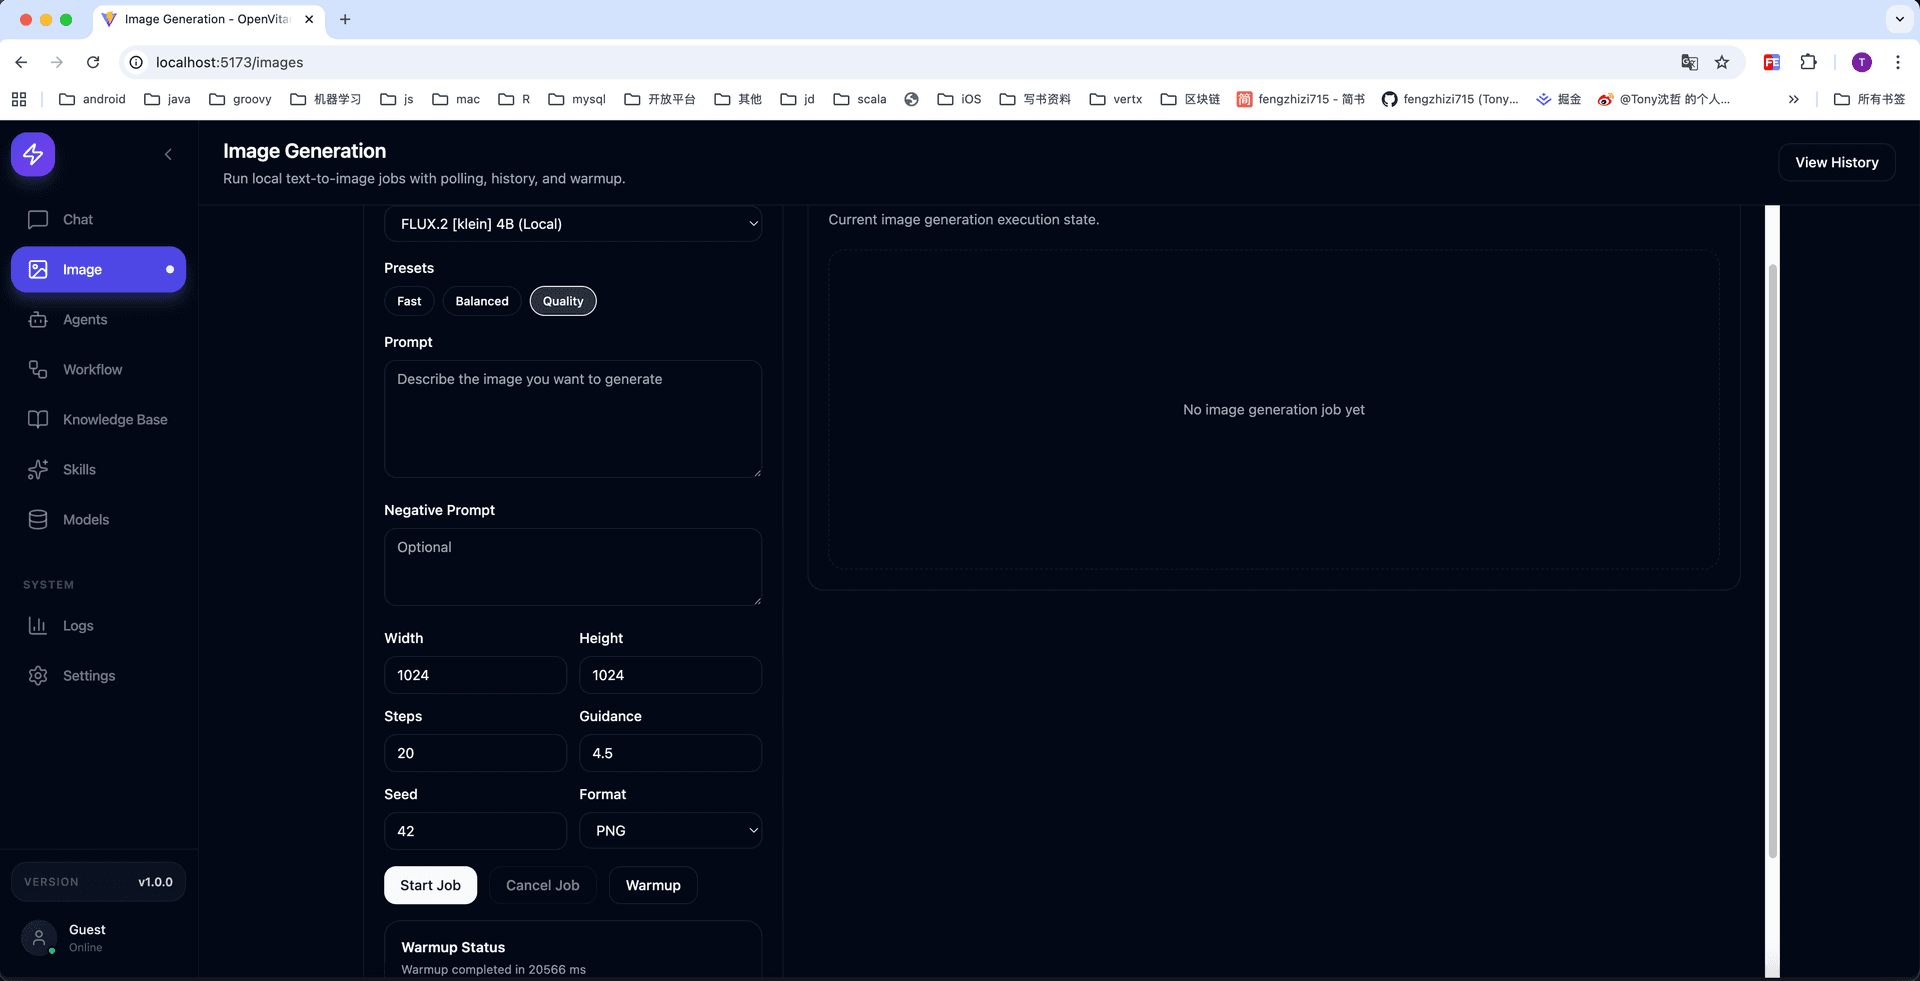
图:图片生成工作台,支持异步任务、历史记录、缩略图和任务取消
内置知识库系统支持 RAG(检索增强生成),向量搜索基于 sqlite-vec(可选,失败时降级到 Python cosine 相似度计算)。用户可以在知识库中上传文档,系统自动完成切分、向量化存储,并在对话时结合检索结果生成回复。所有数据默认存在本地 SQLite 数据库,强调隐私优先。
项目对图片生成能力的封装较为完整,支持:
内置数据库备份和 model.json 备份功能,防止配置丢失。
OpenVitamin 目前没有提供 Dockerfile 和 docker-compose,不支持容器化一键部署。这是目前项目最大的局限——想要体验完整功能,必须手动搭建 Python 环境(conda)和 Node.js 环境。
部署流程分为两步:
backend/requirements.txt 中的依赖(FastAPI、SQLAlchemy、llama-cpp-python、openai 等),运行 ./run-backend.shfrontend/ 目录,npm install 后 ./run-frontend.sh作者为 macOS(默认路径)、Ubuntu 和 Windows 分别准备了不同的 requirements 子文件,说明项目在跨平台兼容性上有一定考虑,但实测需要一定动手能力。
项目对 GPU 并非强制要求——llama.cpp 支持纯 CPU 推理,但运行 7B 以上参数模型时速度较慢。推荐配置为:8GB+ 内存、2GB+ 磁盘空间(不含模型)、一块 NVIDIA GPU(可选但强烈推荐)。Ollama 驱动的本地模型会占用大量磁盘空间,实际部署前需评估存储。
这是 OpenVitamin 最核心的价值主张:所有数据默认存储在本地 SQLite 数据库,模型推理可在完全不依赖外网的情况下完成。网关设计强制前端不得直连模型,确保数据流向清晰可审计。AGENTS.md 中明确要求「默认假设系统运行在无外网环境」,这对关注数据隐私的企业和个人用户有很强吸引力。
坦诚地说,OpenVitamin 作为一个 72 星级别的项目,仍存在一些明显短板:
1. 缺乏容器化支持:没有 Dockerfile 和 docker-compose,与当前主流的「一行命令跑起来」的部署预期有差距。对于不熟悉 Python 环境配置的用户,上手门槛偏高。
2. 缺乏自动化测试:从仓库结构来看,backend/tests/ 目录存在,但代码层面的测试覆盖情况未知。在生产级应用场景中,缺乏测试会给迭代维护带来风险。
3. 文档深度不足:虽然项目提供了 DEPLOYMENT.md(部署指南)和 DEVELOPMENT_GUIDE.md(开发指南),但 AGENTS.md 等核心架构文档对外部贡献者不够友好,部分章节需要一定的领域知识才能理解。
4. 社区活跃度待验证:目前仅 72 星、3 个 open issues,项目的长期维护和社区生态还需要观察。
5. 特定后端依赖:sqlite-vec 作为向量搜索的可选依赖,在某些 Linux 发行版上安装可能遇到问题(作者已做降级处理,但会影响向量搜索精度)。
OpenVitamin 体现了一个正在快速发展的趋势:本地 AI 能力的平台化整合。
随着 llama.cpp、Ollama、LocalAI 等开源推理引擎的成熟,越来越多的开发者希望在不依赖云端 API 的前提下,运行完整的多模态 AI 应用。然而,单个工具的能力边界是清晰的,但组合它们需要一个「粘合层」——这就是 OpenVitamin 在做的事情:用 FastAPI 网关统一路由、用 Vue 控制台统一入口、用工作流引擎统一编排。
这个方向并非 OpenVitamin 独创。类似定位的开源项目还有 Dify.AI、FlowiseAI、anything-llm 等。但 OpenVitamin 的差异点在于:它将 Agent 系统和工作流编排放在了比 RAG 更高的优先级,意图构建一套完整的「AI 执行平台」而非单纯的聊天或知识库工具。
从项目话题标签来看,OpenVitamin 试图覆盖的领域非常广:agent-orchestration、model-routing、rag、workflow、local-ai——这是一个野心不小的定位。能否真正落地,取决于后续的功能完善和社区建设。
# 1. 克隆仓库
git clone https://github.com/fengzhizi715/OpenVitamin.git
cd OpenVitamin

# 2. 后端(conda 环境)
conda create -n ai-inference-platform python=3.11 --yes
conda activate ai-inference-platform
pip install -r backend/requirements.txt
./run-backend.sh

# 3. 前端(Node.js)
cd frontend
npm install
./run-frontend.sh

# 访问 http://localhost:5173 打开控制台
总结:OpenVitamin 是一个定位清晰、架构合理的本地 AI 推理平台,适合有一定技术背景、追求数据隐私和本地化部署的 AI 开发者。它将多模型推理、智能体编排和工作流自动化整合到一个控制台中,解决了「本地 AI 能力碎片化」的核心痛点。但目前缺乏容器化支持、文档深度有限、社区活跃度待验证,距离生产级可用还有一定距离。如果你对本地部署大模型、构建私有 AI 应用有兴趣,OpenVitamin 值得研究和试用。
