
sellbird
ethanplusai/sellbird加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
每个做 To B 销售的人都有一个熟悉的场景:你想找一个真正需要你产品的客户,于是注册 Apollo、买 ZoomInfo、订 Clearbit,搞清楚怎么用之后发现——单个数据源对小微企业的覆盖率撑死 30%,而你的目标客户恰恰全是 5-50 人的本地小店。工具月费 $250-500,而它最薄弱的环节正是你最需要的环节。
Harvey 是 2026 年 3 月出现的一个回应。作者 Ethan Rogers 用一句 "Harvey finds businesses worth selling to, learns something specific about each one, writes cold email that references it, sends it, reads the replies, and works the conversation toward a meeting" 定义了它——然后加上一句更反直觉的:"there is no model API bill"。MIT 协议,3,896 星、805 fork、22 位贡献者。
其他自主销售智能体按 token 计费,这不是巧合——一个整天在循环里思考的智能体,本质上就是整天在烧 API 额度。厂商的解法是少思考:更短的提示词、更便宜的模型、更少的轮次。
Harvey 反其道而行:它复用你本来就在付的订阅。Claude Code 的 claude CLI,或者 macOS/Linux 上的隔离 codex app-server。两条路都返回纯文本、禁用模型工具,Harvey 自己搞定挖掘和邮件操作。
成本对照表作者自己列得很清楚:
| 项目 | 花费 |
|---|---|
| 模型调用 | 你的既有订阅(Claude Pro/Max 或带 Codex 的 ChatGPT 计划) |
| 找企业 | 默认源 $0,或最便宜的付费源约 $0.37/1000 |
| 读对方网站 | $0——每个企业 3 次 HTTP 请求,不调模型 |
| 写和发 | 订阅 + 邮箱(约 $7/月 Google Workspace) |
| 挖掘工具 | 无。不用 Apollo、ZoomInfo、Clearbit、Clay |
有个安全设计值得单独提:Claude 调用不带你任何自己的 Claude Code 配置——没有 CLAUDE.md(你的、项目的、父目录的都没有)、没有 hooks、skills、plugins、MCP 服务器、没有工具,在一个空临时目录里跑,你的 Claude 记录里什么都不留。这需要 CLI 支持 --safe-mode;版本不够时 Harvey 会暂停而不是不隔离地发提示词,并提示你跑 claude update。甚至有离线自检命令:HARVEY_CLAUDE_CLI_TESTS=1 pytest tests/test_claude_cli_isolation.py。
这是整个项目最值得学的一条。README 把它列为哲学原则:「如果能用确定性方法得到,就不要用模型。」
Harvey 的心跳循环是确定性决策,不是问模型「现在该干什么」:
handle replies > send campaigns > write campaigns > prospect > idle
这个顺序完全可以从四个计数器推导出来,用模型问一遍纯属浪费。排名位置、技术栈检测、垃圾过滤、优先级决策、发送前检查——全是纯代码。Claude 或 Codex 只用在真正需要判断力的地方:写邮件、处理异议、判断意图。
其他几个例子:PROFILE 阶段(抓取和分析对方网站)完全不调模型,每个企业 3 次 HTTP 请求。PROFILE 阶段的产出是让邮件变具体的事实——现用的代理公司、广告像素、缺失的 schema、荒废的博客、开放的职位、有名有姓的人。代理商检测是复利效应最高的一项,因为几乎每家代理商都会在页脚给自己署名,Harvey 会给措辞打分:「Powered by」/「Website by」→ 置信度 0.9;裸描述性链接 → 0.75;无标签链接 → 0.35 且不记录。作者的原则很硬:邮件里写错现用代理商,比什么都不写更糟。
DISCOVER(谁存在)——唯一花钱的阶段,所以它总是先估算再动手,harvey discover --estimate 先报账再退出,从不擅自调用。数据源有 8 种,默认是免费的 OpenStreetMap,作者明说它的覆盖很薄:OSM 映射的是建筑物,所以整个美国不到 2000 个屋顶工、不到 2300 个水管工。Harvey 在 UI 里直说而不是悄悄交付不足。付费选项里 DataForSEO Business Listings 是 $0.372/1000,能筛出完全没有网站的企业。
内置的创业公司技能由三部分组成:预设搜索(yc、accelerator、funding,从企业自己的站点找「我们通过了 YC」「Acme (Techstars '24)」「我们完成了 400 万美元种子轮」这类自述、"Backed by" logo 墙、或指向自己 YC 页面的链接)、信号识别、以及写作手册。Harvey 绝不读取 ycombinator.com、加速器目录、Crunchbase、PitchBook 或 LinkedIn——这些站点的条款禁止抓取,全部信息来自公司自己的站点和你的搜索供应商。
PROFILE(他们是什么)——免费,三个 HTTP 请求。抓首页、robots.txt、sitemap.xml,以及存在时的团队页和招聘页。安全边界写得很细:只允许公共 HTTP(S) 目标,每个 DNS 应答和重定向都要检查,本地/私有/链路本地/元数据地址一律拒绝,连接使用已验证 IP 但保留站点 TLS 身份,而且这些客户端忽略环境代理,所以代理路由无法绕过这个边界。
ENRICH(谁拍板)——从公司自己的网站找老板。规则细致到有点 obsessive:识别卡片和列表(名字下面有职位,哪怕职位只是 <br> 隔开的 span 里的文字)、句子(「owned and operated by Gary Pruitt」)、schema.org 的 founder/employee 条目、以及「门上的名字」——两个人都有 owner 头衔时,姓氏出现在公司名里的那个排前面。只有姓氏绝不算老板:Linda Smith,Smith & Sons 的 Office Manager,不是。标题按整词匹配你的 ICP,「Vice President」不算「President」除非你明确列了它。普通词组成的标题(「Team of Experts」)、客户证言里被引用的人、其他机构的高管、前任老板(「Past President」「the late Harold Smith」)和标语都不是人。
VERIFY(够得着吗)——学习该公司的地址模式然后只验证一个候选,而不是暴力穷举姓名变体。nvale@ 挨着 Nora Vale 就学出 {first initial}{last}。但一个无点地址若没有具名主人在用(kmorrow@)就是歧义,什么也学不到;两个具名人都可能拥有的地址(John 和 Jane Smith 都在的 jsmith@)只算格式证据,Harvey 绝不猜测或验证另一个具名人也可能拥有的地址——验证器确认的会是他们的邮箱。每个地址都诚实打标:verified / risky(catch-all)/ guess / invalid,只有可投递的才可能被发送。
skills/ 目录里的纯 Markdown 就是 Harvey 的销售知识。没有微调,没有向量库,没有检索步骤——智能体运行前,它需要的 skills 直接拼进提示词。改一个文件,下一个心跳的行为就变了,不用重启、不用改代码。
邮件太长?改 email_frameworks.md。某个异议处理得不好?改 objection_handling.md,加上你真正会给的答复。
底下是五个各自加载不同 skills 的子智能体:Scout(给挖到的东西打分和个性化)、Writer(生成 3 封邮件序列,第 1、2 封各不超过 75 词,第 3 封不超过 40 词,有 AI 腔黑名单)、Sender(渲染合并变量、按人类节奏投放、执行日上限、收到回复即停——公司里任何一个人回信就停掉给这家公司的整个序列)、Handler(轮询回复、去重、分类意图、推进会话阶段、检测退信并标记地址无效、取消该潜客的排队发送、退信率超阈值触发全局 kill switch)、Analyst(空闲周期跑管道统计、活动分布、什么真正有效)。
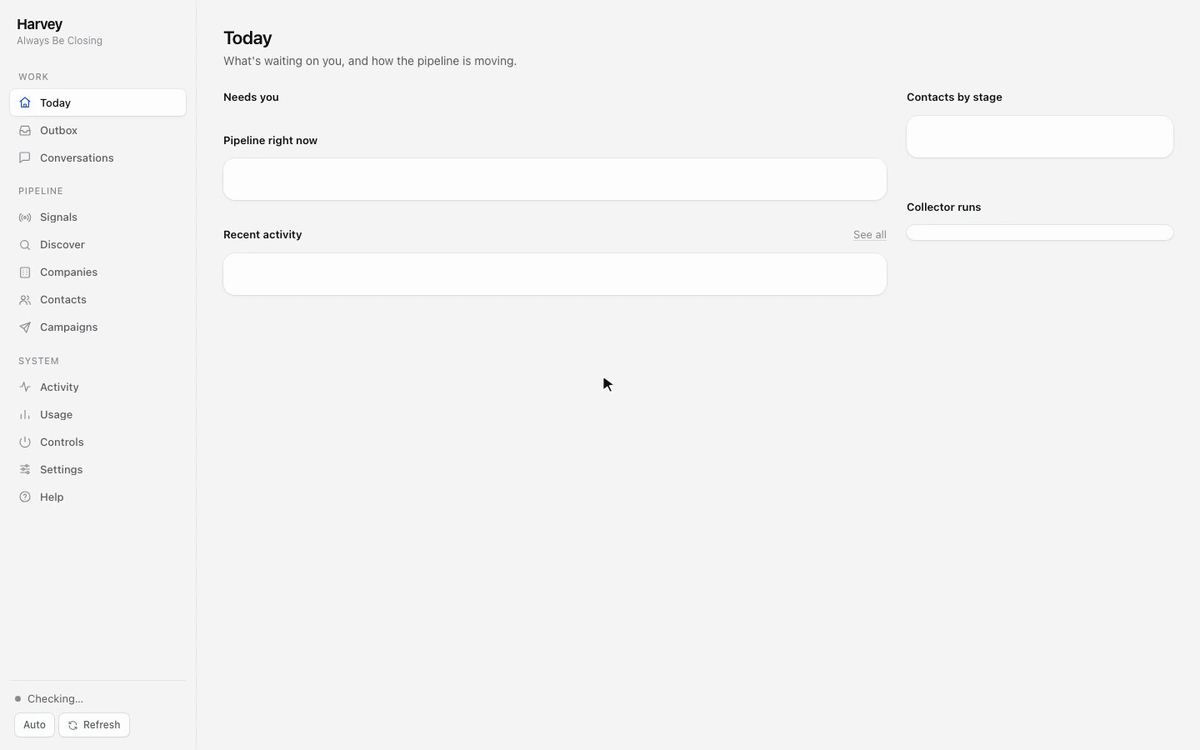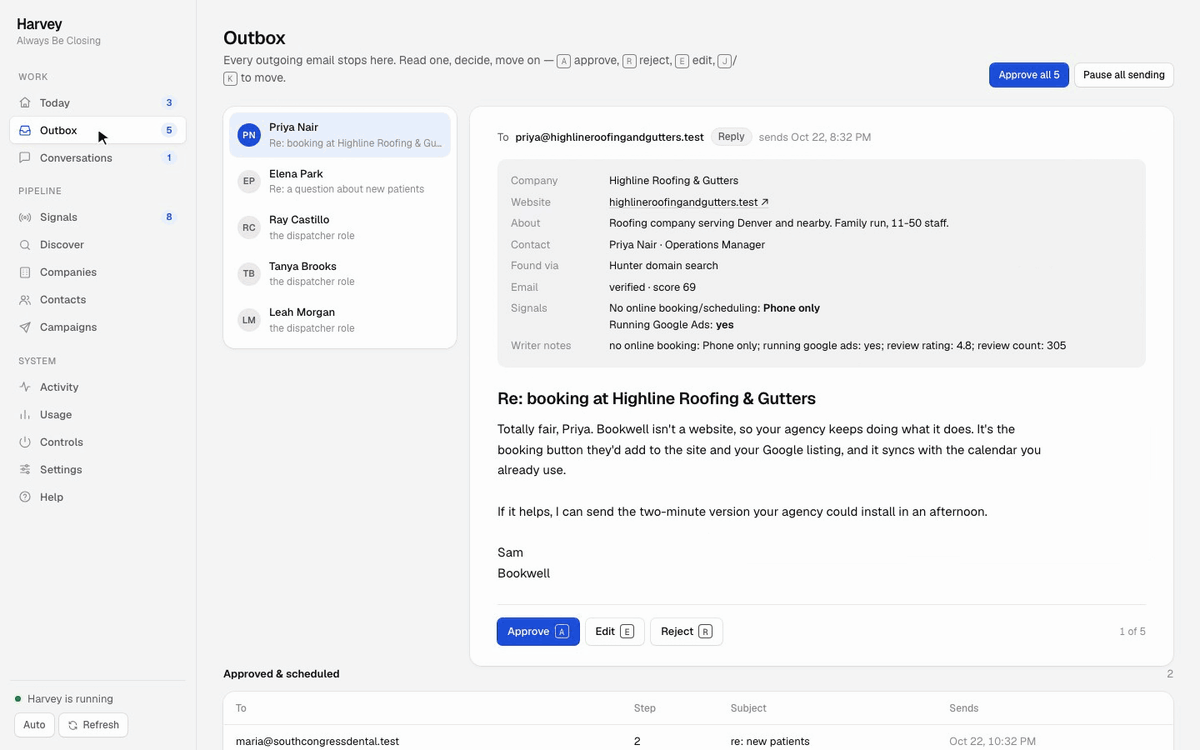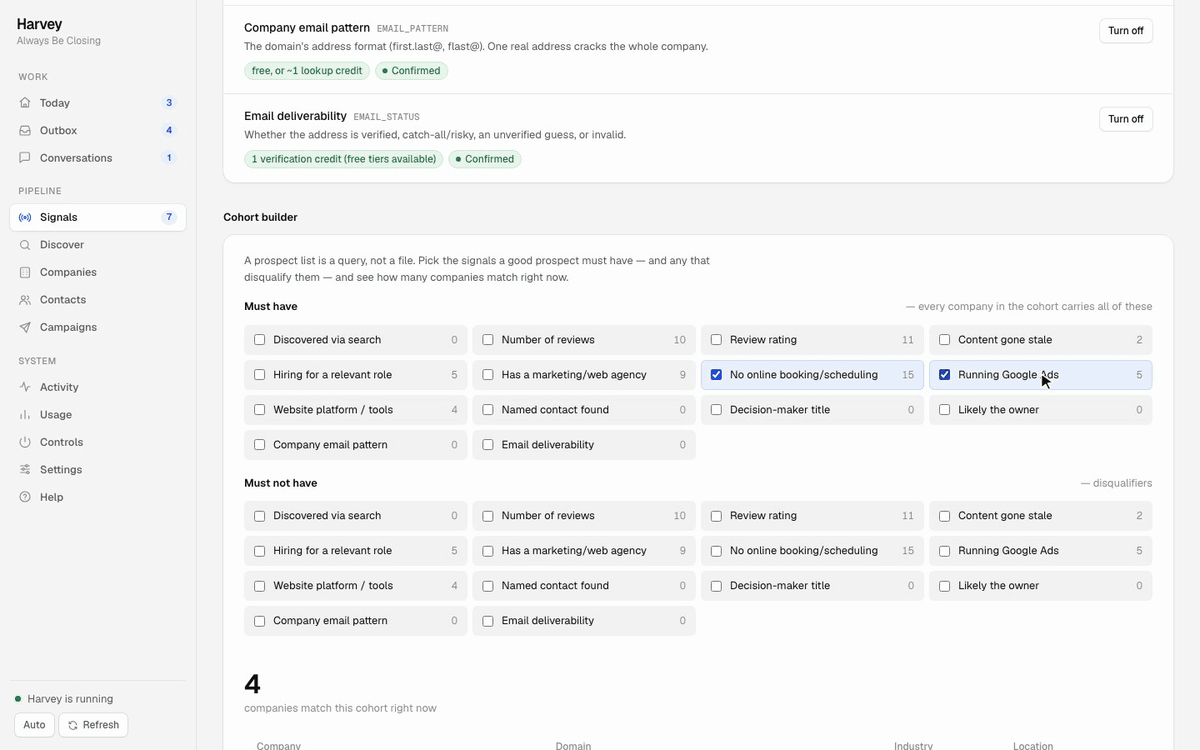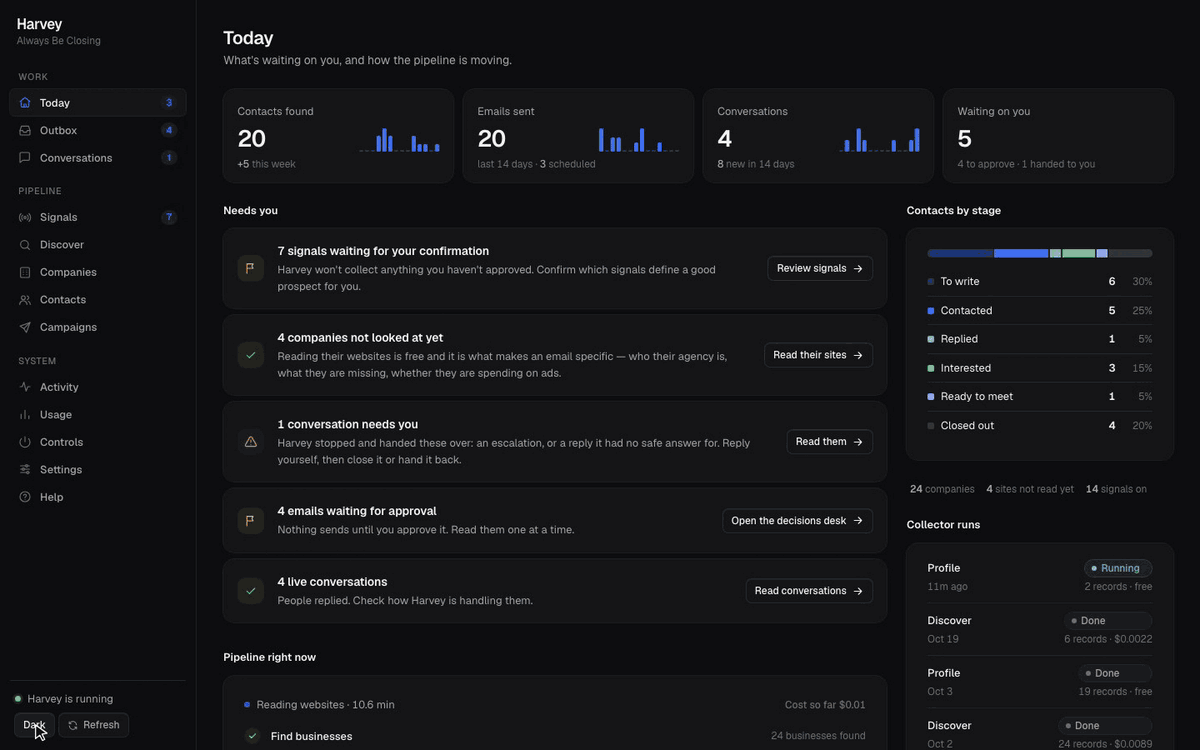
默认每一封外发邮件都要等你批准。 Harvey 默认是副驾驶。Outbox 被设计成「决策台」:一封邮件占满窗格,其余在侧栏排队,A 批准、R 拒绝、J/K 移动。这个形状是刻意的——一堆草稿堆在一起会诱发「全部批准」的本能反射,而这恰恰是审批阶梯存在的意义要防的。
发送前还有一道确定性闸门,不涉及模型:拒绝未渲染的合并标签、违禁措辞、超长邮件、链接过多、HTML 正文、不可投递地址、以及收件人与数据库记录的任何不一致。
还有收件人所在时区的办公时间:channels.email.send_window 设定后,冷邮件只在对方本地时间的工作时段(默认周一至周五 08:00-17:00)发出,一次活动可以同时打到纽约和奥斯陆,两边都落在办公时间。Harvey 从公司地址推断时区,一次算出并缓存。回复永远不会被窗口挡住。
这套东西在打法律灰区。 项目专门有一节「Legal and deliverability」,还接了第三方服务 Precleared 来查某个地址是否允许冷邮件、是否需要预热。但项目自己也承认:多数司法辖区的冷邮件规则要么不存在、要么模糊,违规处罚由发件方自己承担。README 明确写着「You're responsible」。
冷邮件送达率的天花板是邮箱服务商,不是代码。 Google Workspace 和 Microsoft 365 接受来自未知 IP 的一切;笔记本上裸跑 SMTP 探测不现实(出站 25 端口通常被封)。所以作者建议用真正在用的邮箱($7/月),并推荐用 TrulyInbox 之类做预热。
默认数据源覆盖不够。 OpenStreetMap 便宜但薄,商业源按量计费。「不用 Apollo、ZoomInfo、Clearbit、Clay」是成本优势,但也意味着你得自己找替代品。
自动化边界仍然要人守。 Autopilot 模式存在——但作者反复强调「Autonomous doesn't mean unsupervised」,并提供了 harvey sending pause 这样的紧急开关。默认是审批模式,这点必须说清楚。
桌面应用只是个壳。 harvey/web/ 里是真的 HTML/CSS/JS 文件,没有构建步骤,字体也打包进本地以保证断网可用——这很好,但也意味着它是个「能跑就行」的水准,不是打磨过的产品级 UI。
依赖很轻,但 Chromium 是硬需求。 Docker 镜像里 playwright install --with-deps chromium 是必需步骤,镜像因此不小。
平台支持有缺口。 Codex 路径只在 macOS 和 Linux 上,README 标题也标注了「opt-in provider」。
自主销售智能体这个赛道 2026 年很拥挤,Harvey 的差异化不在于功能清单——找客户、写邮件、跟进,这些别人都有——而在于它把「用订阅而非 API」这件事做成了架构前提,并因此衍生出一整套「能确定性算就别用模型」的工程纪律。
这对做 AI 应用的人有普遍意义:token 成本不只是账单问题,它会反向塑造架构。Harvey 因为要省调用,于是把优先级决策、垃圾过滤、地址模式学习、发送前检查全部下沉到纯 Python——结果不仅省钱,还获得了可预测性和可测试性。85 个测试文件、242 个测试覆盖的正是这些确定性部分。
另一层价值是它把「信号即资产」的思路讲透了。README 有一句话:「数据库才是资产,不是智能体。初始名单不值什么;同样的信号在几个季度里的观察——谁换了代理商、谁开始投广告、谁的内容荒废了——才值大钱。」这跟开源情报的逻辑是同构的:一次快照没用,持续跟踪才有价值。
harvey export 会导出全部找到的线索成 sequencer-ready CSV。作者原话是「就算你一次都不让它发,Harvey 也值得跑」--safe-mode 支持),或在 macOS/Linux 上走 Codex;先跑离线隔离自检harvey.yaml 里填 persona、product(含异议应对话术)、icp(行业、规模、职位、地区、招聘信号)send_window 避免半夜打扰skills/ 改起,比改 prompt 或加代码都直接MIT 协议,纯文本可编辑,一个邮箱 + 一个订阅就能起步。对做 To B 销售自动化、或者研究「订阅制 AI 应用如何绕开 token 成本」的人,这是一个值得读的参考实现。
