
shuohao-skills
eternityspring/shuohao-skills加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2024 年,短剧市场规模突破 500 亿元人民币,无数人沉迷于"睡前看一集"的故事节奏里。但鲜少有人知道,一部 60 集短剧的后期制作素材——改编大纲、角色设定、场景美术、剧本台词、分镜脚本——全靠人工整理,一位资深编剧往往要花上 2–4 周才能交付这些材料。
烁皓(@eternityspring)想做一件事:让这个流程自动化。他的核心思路是——把"小说到短剧"这条生产线拆解成五个标准化工序,每道工序交给一个 Claude Code agent skill 完成,五个 skill 首尾相连,输出可以直接喂给 AI 生成管线的结构化素材。
GitHub 上,这个项目叫 shuohao-skills,截至目前已获得超过 3700 颗 star、500+ fork,一个月内从 0 涨到 3.2k star。它的代码量不大(JavaScript/纯脚本),但背后的产品逻辑相当严密。
shuohao-skills 由五个独立 skill 组成,形成一条完整流水线:
| Skill | 功能 | 质量门数量 |
|---|---|---|
| novel-outline | 小说改编短剧大纲:人物表、爽点表、分集梗概、资产清单 | 14 道 |
| novel-characters | 角色设定集:人物画像、形象提示词、音色提示词、角色设定图 | — |
| novel-art | 美术设定集:场景图、叙事道具、光照与状态变体 | 10 道 |
| novel-script | 剧本:分集台词、钩子设计、角色台词本(带 TTS 音色提示) | 10 道 |
| novel-storyboard | 分镜脚本:MiniMax H3 提示词、Seedance 投产包 | 18 道 |
这套管线的设计哲学很清晰:模型负责创作,脚本负责质检。 每个 skill 的质量门不是靠 LLM "自觉"检查,而是由 node scripts/*.mjs 脚本做确定性校验——角色分档上限、爽点间隔不超过 3 集、每集钩子悬念必填……任何一项不达标,skill 会拒绝输出,直到修改达标。
以 novel-outline 为例,14 道质量门覆盖了:大纲结构完整性、角色出场频率、场景密度、爽点分布合理性等维度。开发者明确在 AGENTS.md 中写道:"门失败累积(gates.jsonl + stats)目前只在 novel-storyboard 上,这是有意的——先在真实项目里用一段时间,确认 stats 出来的东西真的指向了该改的规则,再决定要不要推广。"这种克制的产品思维,在这个阶段非常难得。
实际使用流程极为简洁——你只需要把小说扔给 Claude Code,然后逐个调用 skill:
# 1. 先拆大纲
novel-outline --episodes 60 --duration 3min

# 2. 基于大纲做角色设定
novel-characters --outline ./outline.json

# 3. 出美术设定集
novel-art --outline ./outline.json

# 4. 写剧本
novel-script --outline ./outline.json --cast ./cast.json

# 5. 出分镜
novel-storyboard --outline ./outline.json --art ./art.json

# 最后:五份报告合成一张 HTML 单页
node scripts/report.mjs --from ./demo --out report.html
最终输出包含:改编说明文档、JSON 格式的结构化数据、Markdown 说明文件,以及一份可交互的 HTML 评审报告。所有报告支持中英双语,render --lang en 即可切换英文界面。
第一个原因:它是真正的 AI Native 应用,不是玩具。 作者在 X 上写道,自己正在失业期间,这个仓库是他在"空闲时间"里真实使用的工具。五个 skill 都有完整的样例数据支撑,每份报告的截图都是真实跑出来的——不是占位图,不是效果演示,而是"我已经用这套流程跑过真实项目"的证明。
第二个原因:工程化程度远超同类。 市面上不缺"AI 短剧生成"的工具,但大多数停留在"调用 API 生成一段文字"的层面。shuohao-skills 的每个 skill 都是自包含的——零第三方依赖(Node.js 标准库,无 npm 包)、零 API key(直接用当前会话额度)、可单独拷走使用。五个 skill 通过约定格式的 JSON 文件解耦,修改任何一个 skill 不会影响其他。
第三个原因:质量门设计解决了一个真实痛点。 在 AI 生成内容中,质量控制是个老大难问题——模型会自信地输出看起来合理但实际上漏洞百出的内容。shuohao-skills 的解法是:让脚本做判断,模型只管生成。这个设计在 novel-storyboard 上还配备了 gates.jsonl 统计面板,记录每次质量门的通过情况,为后续规则优化提供数据依据。
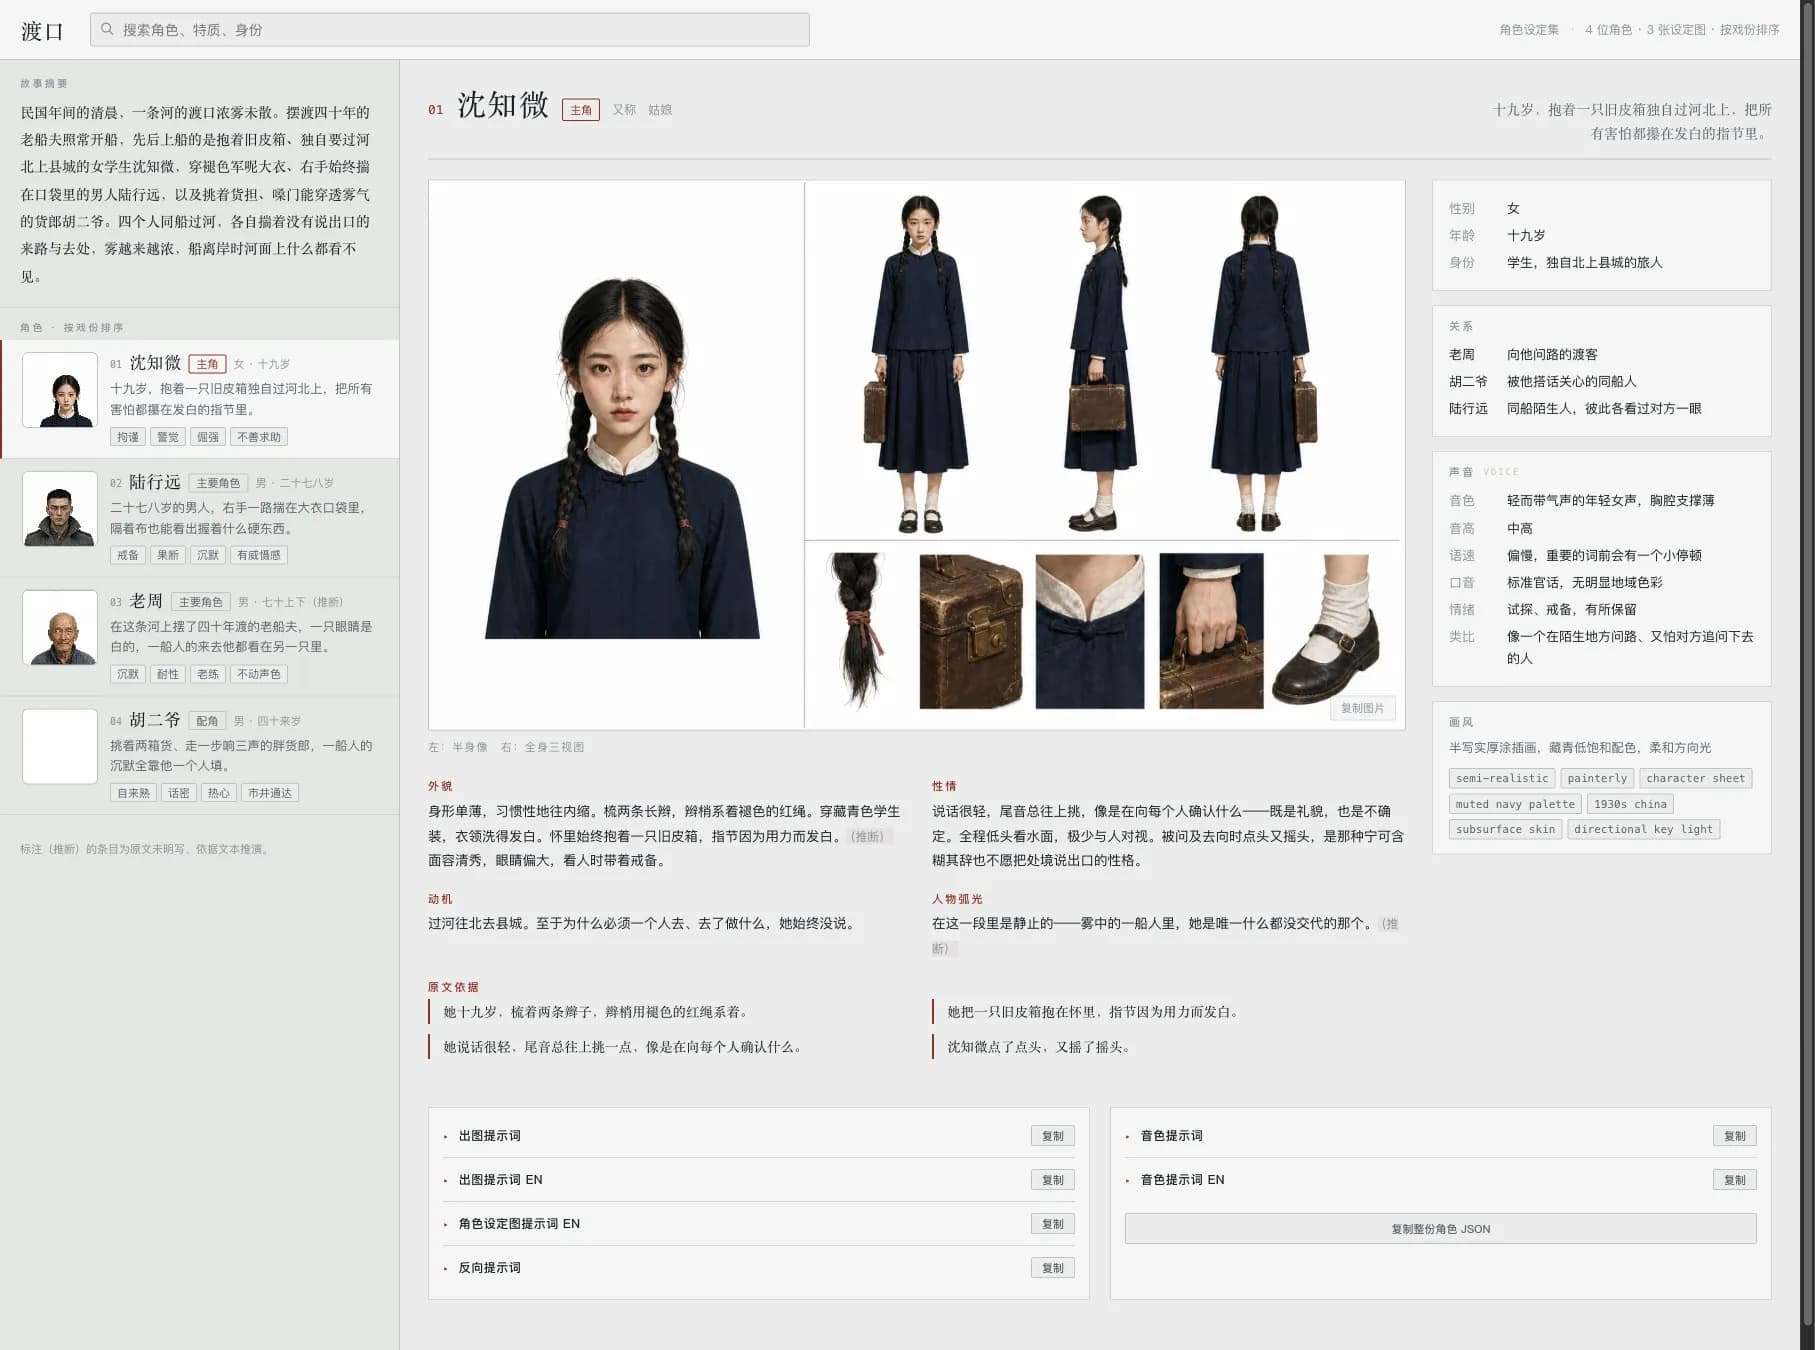
角色设定集报告:包含人物画像、形象提示词、音色提示词,可直接对接 AI 生成和 TTS 配音管线
使用门槛极低。 你只需要:Node.js 18+ 和 Claude Code(或 OpenAI codex CLI)。没有 Docker、没有 GPU、不需要云服务器,直接 clone 仓库,在 agent 中加载 skills/ 目录即可。
开发门槛也不高。 每个 skill 都是自包含的 MJS 脚本,代码逻辑清晰(novel-outline 的核心逻辑约 200 行),注释完整。作者在 AGENTS.md 中明确规定了行为规则:中文文案不用单字词、skill 必须可单独拷走、渲染产物不进版本控制……这些约定让后来者参与贡献时摩擦力很小。
不过有一点需要注意:这不是一个"一键生成短剧"的工具。 它帮你完成的是"小说到制作素材"的转换,最终的视频生成(比如用 MiniMax 或 Seedance 生成分镜图)需要另行接入对应的 AI 生成管线。作者在 README 中明确写道:"分镜只做输出不做新决定"——它输出的分镜脚本是对齐 MiniMax H3 的提示词规范,对接的是已有的商业 AI 生成工具。
1. 题材适配性有待验证。 官方样例以男频都市爽文为主("赘婿""总裁"等套路),对于女频、悬疑、古风等题材的爽点模式是否能自动适配,还没有充分验证。
2. 长文本处理是瓶颈。 如果你扔给它的不是一本 10 万字的小说,而是 300 万字的网络文学巨作,LLM 的上下文窗口和推理质量都会面临挑战。novel-outline 的 Step 2 分卷摘要机制是对这个问题的缓解,但并不能根治。
3. 质量门的阈值是经验值。 作者在文档中承认,很多阈值(比如爽点间隔 ≤ 3 集)是基于现有样例的经验设定,随着用户基数扩大,这些默认值可能需要根据不同题材、不同平台规则动态调整。
shuohao-skills 的出现,折射出一个正在加速的趋势:AI 正在从"单点生成"向"流程自动化"演进。 过去一年,我们见过无数"AI 生成剧本""AI 生成图片"的工具,但把它们串成一条可验收的生产线,并在每个节点设立质量关卡——这件事鲜少有人做。
烁皓的实践意义在于:他证明了 skill 化 + 质量门 的组合是可行的。这套架构可以移植到其他内容生产领域——漫画分镜、游戏关卡设计、电商详情页生成——只要你能把"质量标准"转化成脚本可校验的规则。
从增长曲线看,项目从 0 到 3.2k star 只用了一个月,这个速度说明市场对"AI 短剧制作"的需求远未饱和。短剧出海(东南亚、北美)正在成为新风口,而 shuohao-skills 这类工具恰好切中了这个时间窗口。
如果你在寻找一个真实可用的 AI 内容生产管线参考,shuohao-skills 值得花一个下午认真研究它的 skill 设计和质量门逻辑。
