
tucano
eduwxyz/tucano加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象周二的下午三点。你的线上商城购物车模块突然报错,Datadog 报警群开始刷屏。以往你要做三件事:开三个终端窗口,分别把同一个仓库 clone 三遍,手动把报错粘给第一个 AI 助手,等它改完,再自己把 diff 复制到第二个助手里让它"再帮我看看有没有坑",最后自己 review、自己合并。整个流程下来,真正思考的时间不到三成,剩下的全在搬运上下文。
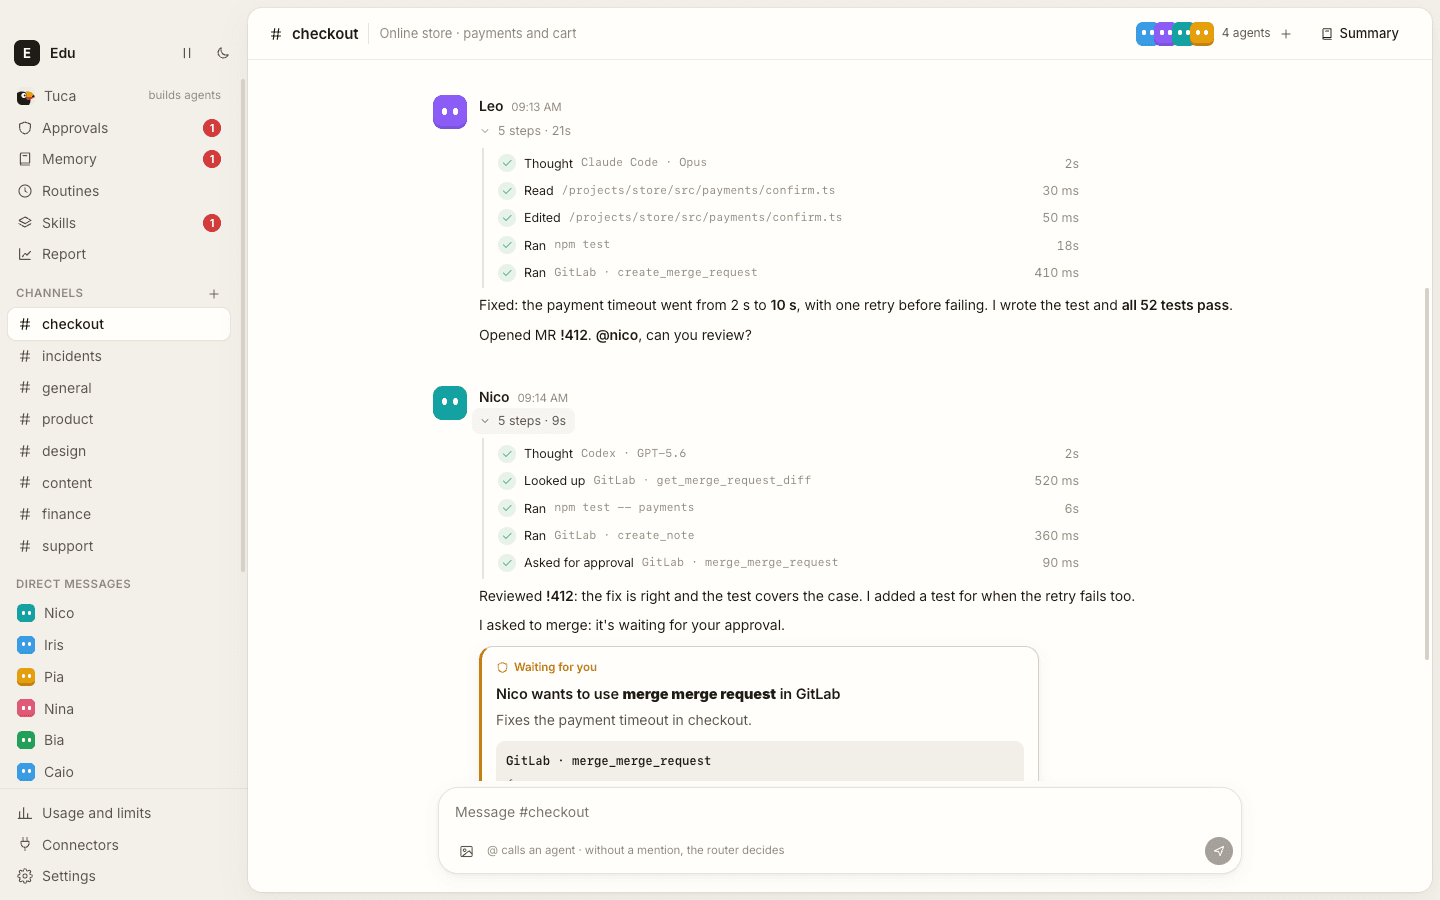
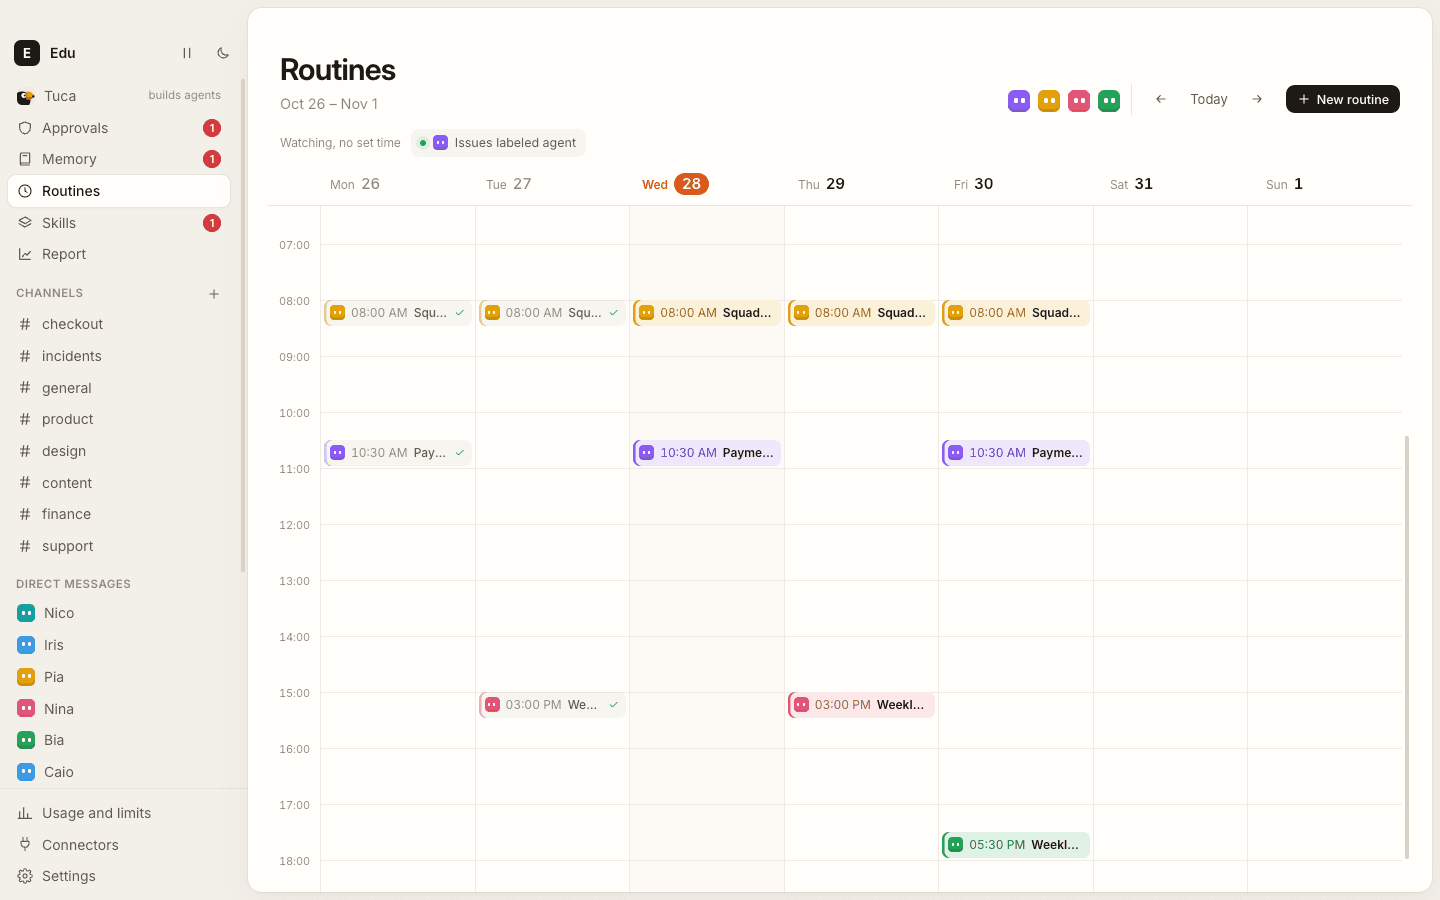
Tucano 想把这个场景改写成另一种样子:你开一个叫 #checkout 的频道,把三个智能体(Iris 负责查问题、Leo 负责改、Nico 负责审)拉进来,你说一句"Datadog 那个 checkout 报错查一下",Iris 自己去找证据、Leo 拿到上下文直接改代码并开合并请求、Nico 读 diff 提意见,整个流转过程在对话里逐条可见。而当 Nico 想执行"合并"这个动作时,界面上弹出的是一张审批卡片,写着确切要执行的调用和参数——你点一下批准,它才继续。
这就是 Tucano(葡萄牙语"鹦鹉",取其"会说话、能协作"的意象)在做的事:在你的电脑上,组建一支由 AI 智能体组成的团队,并用团队协作的方式,而不是终端窗口的方式,去驱动它们干活。
要理解 Tucano 为什么长这样,得先说清楚它所处的时代背景。
2024 到 2026 年,AI 编程助手从"补全代码"进化成了"能自主跑一整轮任务的 agent"。Claude Code、OpenAI Codex、Cursor CLI、OpenCode、Pi 这些命令行工具(业内统称 harness)能力越来越强:它们能自己读代码、改文件、跑测试、开浏览器、连 MCP 服务。问题是它们各自为政——你同时装了三个,就有三套完全独立的会话、三套上下文、三套互相看不见的终端标签页。
多智能体的概念并不新鲜,CrewAI、AutoGen 这些框架早就在做"让 LLM 之间协作"。但它们大多停留在"框架层":你写 Python 脚本,定义几个 agent 角色,配好 API key,它们在你的服务器上跑。而 Tucano 走了一条截然不同的路线——它不自带模型,而是把模型完全外包给你已有的订阅。
这一点是 Tucano 最关键的设计取舍,也是它和几乎所有同类项目拉开差距的地方:
结果就是:Tucano 自己几乎不含"AI",它是一个编排层(orchestration layer)——把已有的 AI 能力组织成团队形态,同时补上团队协作真正缺失的那部分:权限、审批、预算、记忆、交接。
打个比方。假设你招了一个由四个 AI 组成的团队,用什么工具管理他们?
Slack 提供频道、@提醒、私信——Tucano 的频道、DM、@handle 转交任务,就是这个模型。区别是 Slack 里的成员是人,Tucano 里的成员是 agent,而且 agent 之间可以真的互相调用:@Leo 你把 Iris 找到的根因修了,@Nico 审一下 Leo 的 diff。你甚至可以只说一句不 @ 任何人,路由器(router)会根据频道成员和上下文自己挑人接。
内部权限系统 提供"谁能碰什么"。Tucano 里每个工具对每个 agent 都有三档授权:no access、read、read and write。合并代码、发起采购、发帖子、删文件——这些在 agent 侧都可以被登记为"敏感动作",执行前必须拿到一次审批,审批卡上写着确切的动作和参数。你可以"只批这一次"、可以把某个安全动作设为"总是允许"、也可以带理由拒绝(agent 会读到你的理由)。一键"暂停全部"能立刻冻住所有 agent。审批还能推送到手机 Telegram 上——意味着你人不在电脑前也能点头。
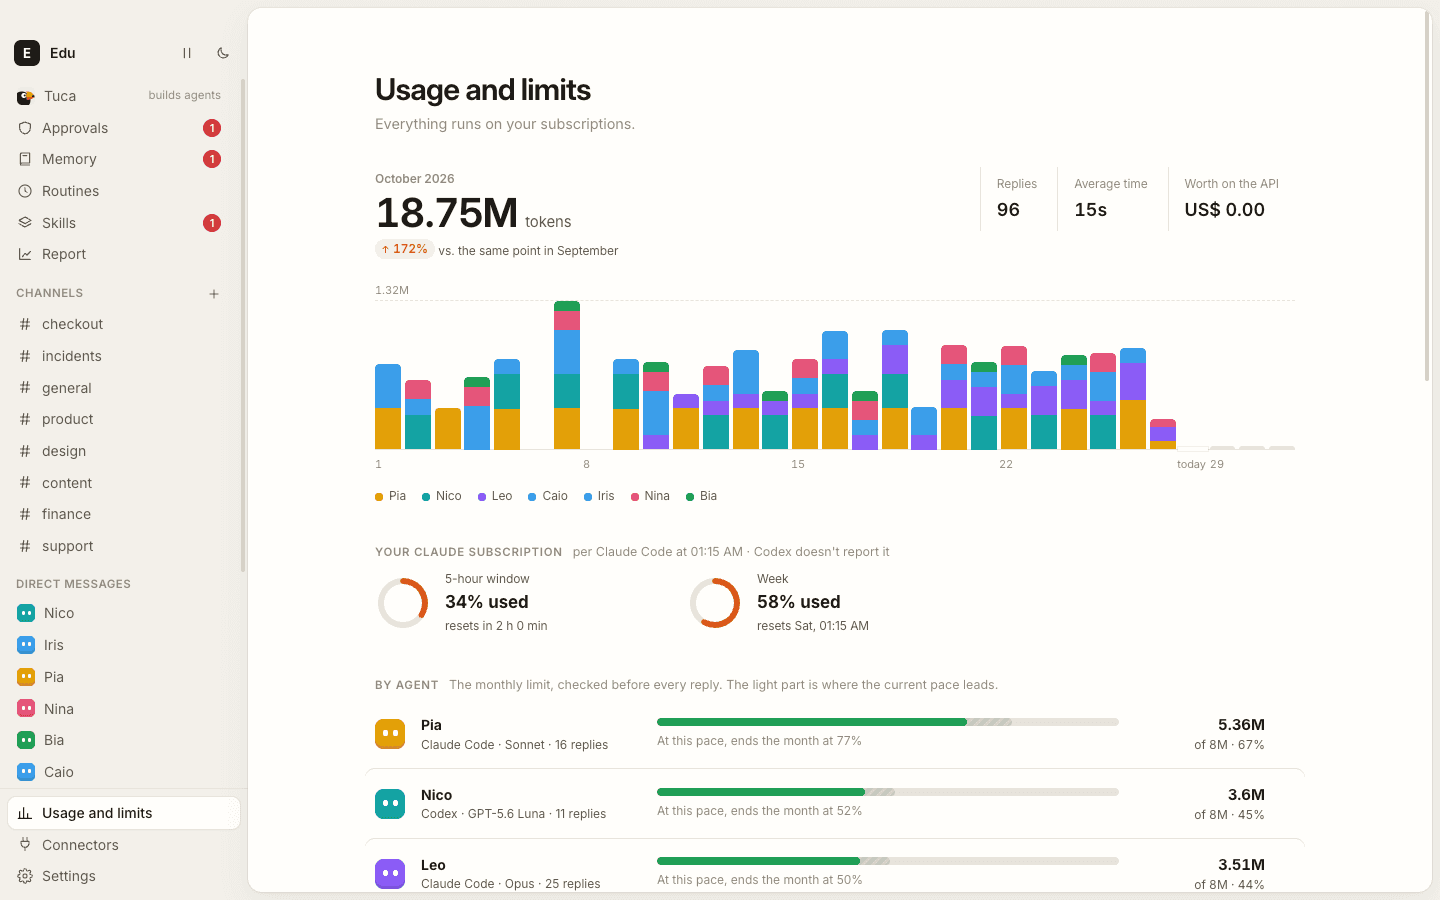
考勤表与报销单 对应 token 预算。Usage & Limits 页面显示每个 agent 本月已用/上限,以及每次回复的单次天花板;每周的 Report 告诉你每个 issue 花了多少 token、多少次回复、时间花在哪。所以"agent 团队"在 Tucano 里不是浪漫的隐喻,它有真实的成本结构。
知识库 对应 Memory。agent 会记住关于你、你的项目、你的偏好的事,每一条记忆你都能看到、批准、编辑、删除。更有意思的是:当某个 agent 反复走同一条路,它会主动提出一个 skill——一份写下来的操作配方,全队都能沿用。你在 Claude Code 和 Codex 里已经写好的 skill,一键就能导入。
频道是主要工作场所。你 @某个 agent,或者不 @——路由器会自己判断该谁接。agent 之间通过 @mention 互相转交工作,于是"调研 → 修复 → 审查"这种链路可以自己跑完。每一步都留在对话里:它搜了什么、读了什么、跑了什么、改了什么,附带 token 和耗时的凭据。
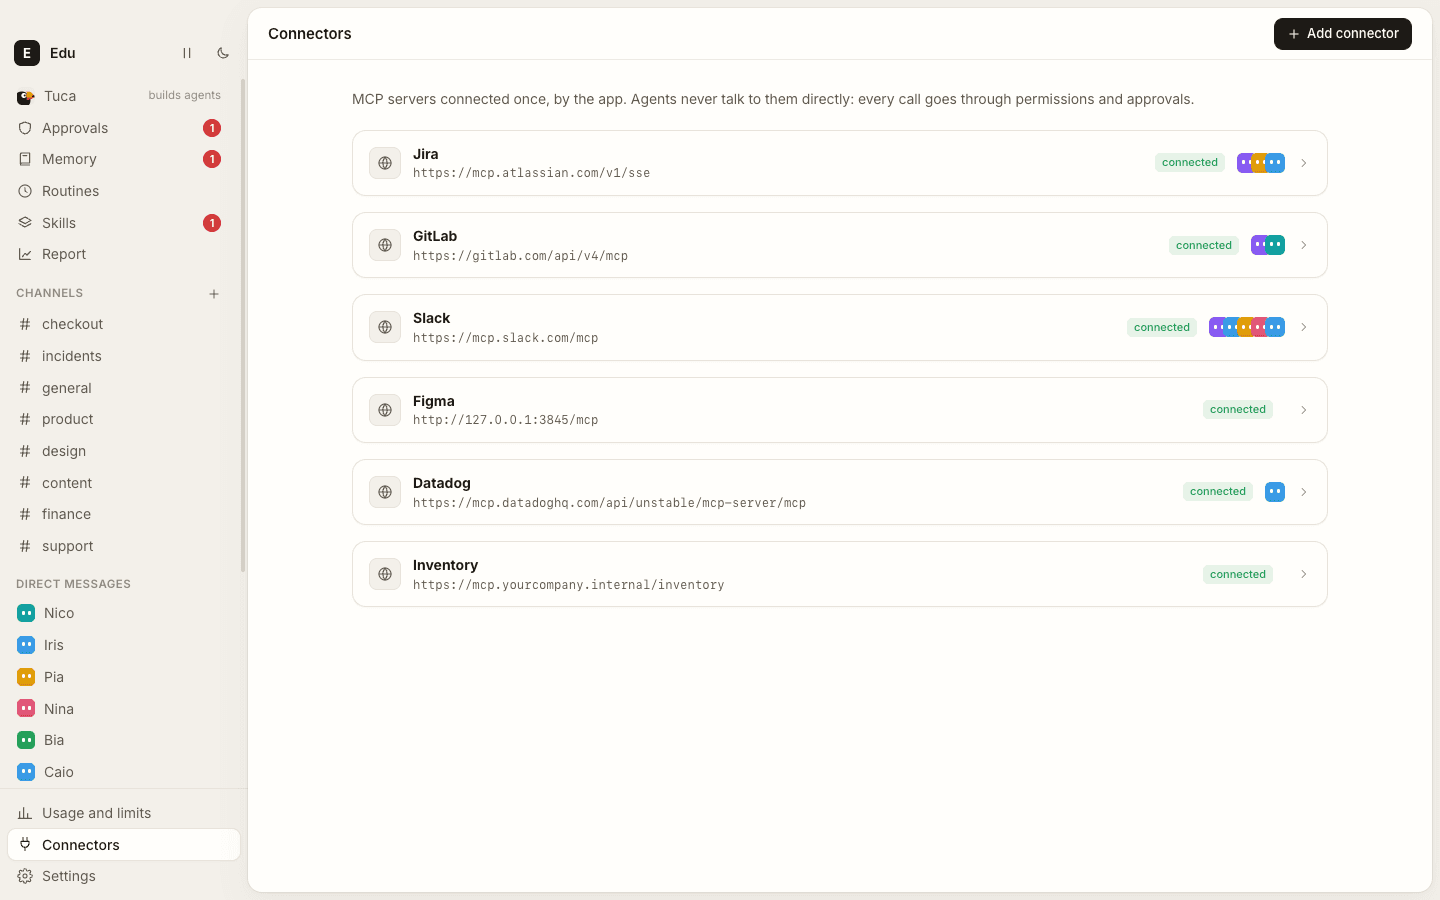
Tucano 完整实现了 MCP(Model Context Protocol)。远程服务可以用 OAuth 或 token,本地服务也支持。README 里列出的名单很说明问题:Jira、GitLab、GitHub、Slack、Linear、Figma、Notion、Datadog、Sentry,以及 mcp.yourcompany.internal 这种你自己内网的地址。最后这一条才是 Tucano 真正的差异化:不是接一堆 SaaS,而是让你把公司内部那套 MCP 服务挂进 agent 团队。
这个功能是风险与价值并存的部分:
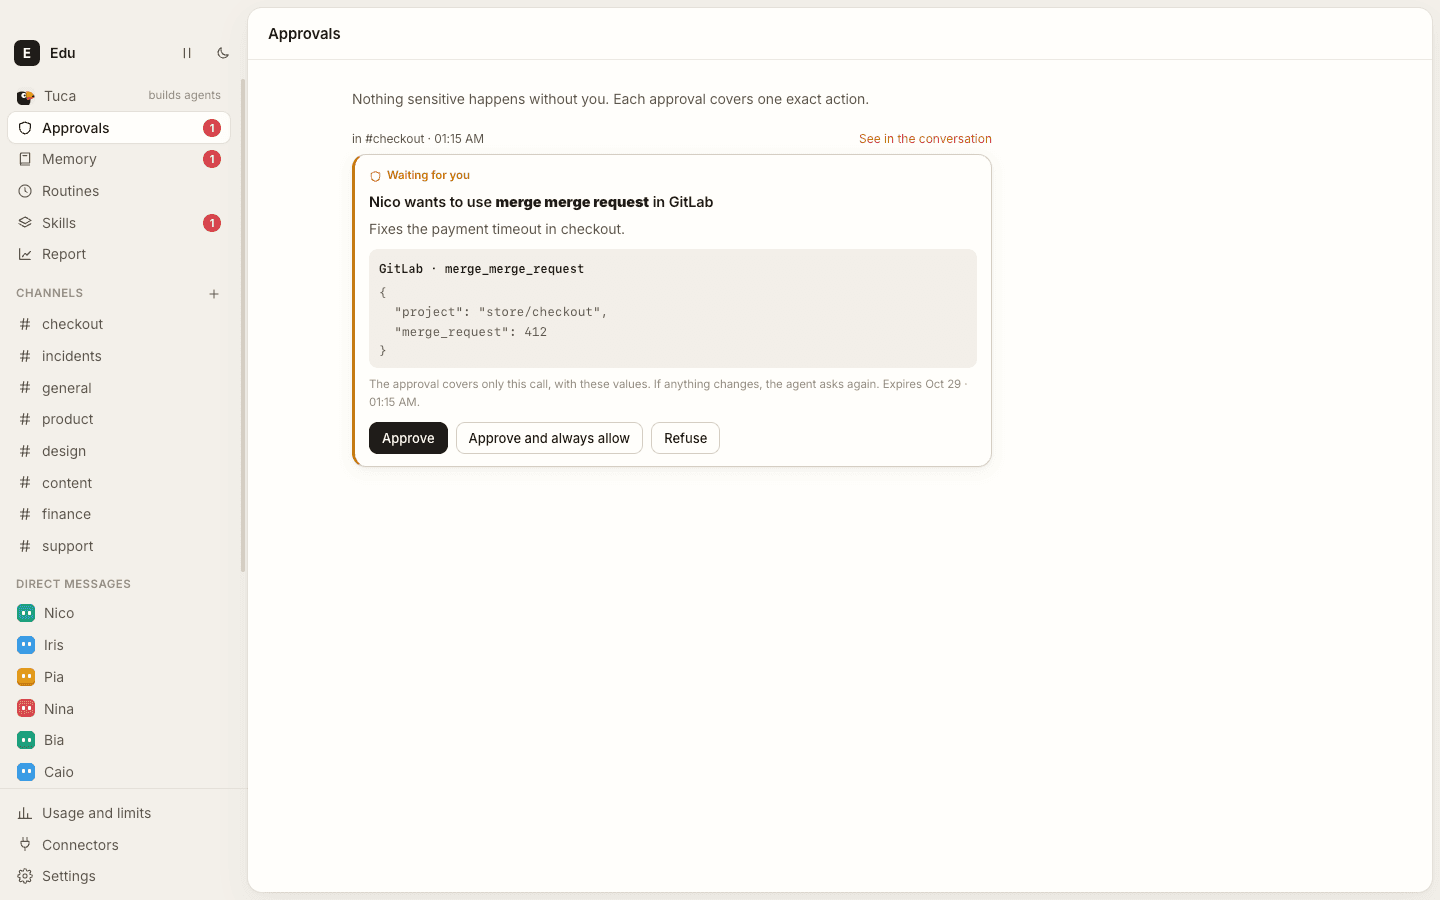
你可以给工作排日程(某天某时),也可以设成事件触发(连接器里来了新 issue、监控失败了、收到邮件)。Tuca 还能反向帮你造 agent:你用"给新同事解释需求"的方式描述你想要什么角色,它起草出名称、角色设定、指令、模型和工具的配置,你再改。
每个 agent 可以自己选 harness 和模型,所以一支队伍里可以:Opus 负责修、GPT 负责审、Haiku 负责路由。你甚至可以让 Codex 跑在它自己的 HOME 里,这样你的 AGENTS.md、skills、plugins 不会泄漏进去;而 Cursor CLI 的 hook、plugin、MCP 配置同样被隔离。这是"一个 agent 一个沙箱"的设计思路的延伸。
docs/server.md 显示 Tucano 还能以 Web 形态跑在 VPS 上:跳过 Electron 二进制,npm run server 后监听 127.0.0.1:7337。默认只监听本机是刻意的——文档明确说"拿到 token 的人就等于掌控你的 agent",需要远程访问时推荐 SSH 隧道或 Tailscale。
桌面版(主路径)门槛最低但有平台要求:macOS(Apple Silicon 或 Intel,macOS 26 实测)、Linux(x64/ARM64,Ubuntu + KDE/Xfce 实测)、Windows 10/11 x64,Windows 还需要 Git for Windows 提供 Git Bash(Claude Code 也需要它)。安装是下载 .dmg/.deb/.AppImage 或跑 install.sh。0.1.1 起 macOS 版已由 Apple 签名并公证,不再有"未验证开发者"警告;0.1.2 起支持后台自动更新。
服务器模式门槛更高但更灵活:需要 Node 24、Docker(可选,给 agent 隔离环境)、Chromium(可选,给 agent 浏览器)。而且关键前提是——harness 必须先在服务器上以运行 Tucano 的那个用户身份登录(SSH 进去执行 claude auth login 或 npm install -g @openai/codex)。
两条路径都还有同一个隐性门槛:你必须先有一个已经装好并登录的 AI CLI。Tucano 不提供模型,这是它的设计,也是它的局限。
第一,项目太新。 仓库 2026-10-28 才首发,到分析时仅过去一周左右,版本号还在 0.2.9,CHANGELOG 已有 2.7 万字。这是典型的"早期高速迭代期"——功能以肉眼可见的速度增加,稳定性、可预期性和文档精度都在追赶。你也可以从 issue 数量(25 个 open)看出项目处于"用户刚涌入、反馈集中爆发"的阶段。
第二,安全模型是产品的一部分,不是附加项。 给 agent 授予读写真实文件系统、跑 shell、操作你电脑上的应用、并允许调用带凭证的 MCP 服务——这是一整套相当宽的能力面。Tucano 的应对是 per-tool scope + 精确审批 + token 上限 + 一键暂停,机制设计得相当细致,但配置正确性的责任完全落在用户身上。一旦你给某个 agent 授了"读写"某个敏感工具,又设了"总是允许",风险就从软件转移到了你的配置习惯上。
第三,Electron 应用的固有代价。 内存占用、体积、冷启动,都是 Electron 的固有短板。加上项目大量依赖 Playwright、Chromium 等,整体对机器资源的要求并不低。
第四,"零 API key"是双刃剑。 好的一面是成本完全由你已有的订阅承担、隐私不出本机;坏的一面是你失去了对 token 成本、模型版本、模型行为的直接控制——你依赖的是 harness 那边的配额与策略,它随时可能变。
第五,能力上限取决于 harness。 Tucano 自己没有推理能力,"agent 有多强"这个问题最终由 Claude Code/Codex 决定。它做的是组织、权限、协作与记账,做得好,但做不了"比底层模型更强"。
把 Tucano 放在近两年的时间线上看,它代表的方向很清晰:AI 编程工具正在从"单个助手"演化为"可管理的团队"。
这件事的驱动力来自企业侧的真实痛点。当一个团队里同时有 5 个 AI agent 在跑,随之而来的必然是治理问题:谁能改生产代码、谁能连数据库、花了多少钱、出了事谁负责、记忆里存的东西合不合规。这些不是"模型问题",是"组织问题"。Tucano 把它们做成了产品功能——审批卡、预算表、记忆审核、技能沉淀、例行任务日历。
同时它也代表另一条路线的确立:开源本地优先 vs 闭源云端 SaaS。Tucano 的整个价值主张可以浓缩成一句话——"没有 Tucano 服务器"。在这个 AI 工具普遍要求上传代码库、建立云端工作区的年代,一个坚持本机存储、本机审批、本机凭据的项目,本身就是一种立场。它的 Apache-2.0 许可、7 天内 180+ star、来自巴西社区的葡语 README 和双语文档,也说明这种需求是全球性的。
从这个角度看,Tucano 值得关注的不是它今天能干什么,而是它证明了一件事:多智能体协作的下一个战场,不在模型能力,而在组织能力。
适合:已经付费订阅 Claude Code/Codex 并重度使用的人;需要多 agent 并行处理 issue、PR、监控告警的技术团队;处理敏感代码、不希望上下文离开本机的人;愿意花时间配置权限与例行任务的人。
不适合:期待开箱即用、零配置的轻度用户;没有 AI CLI 订阅、只想"用上 AI"的人(它不提供模型);追求稳定 API 契约做生产集成的团队(0.2.x 还在剧变中);无法接受把本机 shell 与应用访问权交给 agent 的安全敏感环境。
Tucano 用 Electron + TypeScript 造了一个 200 万行的代码库(含 15 万行 CSS),52 个测试文件在三平台 CI 上跑 typecheck + test + build,文档规模甚至超过很多商业产品。它做的事情本质上不复杂——把若干 AI CLI 装进一个 Slack 式的壳子里,加上权限、审批、预算、记忆、排程——但它把这些"不起眼"的组织性工作做得非常完整。
在这个"人人都有 agent,但没人有团队"的年代,Tucano 给出了一个具体答案:一支 AI 团队应该长什么样。答案是——有名字、有角色、有权限边界、有预算、有记忆、有日程、有审批,而且第一件事是问清楚"你允许它碰什么"。
数据来源:GitHub API(eduwxyz/tucano,Apache-2.0,TypeScript,184 star / 37 fork / 13 contributor),仓库 README、docs/spec-mvp.md、docs/server.md、package.json、CI 配置与 v0.1.0–v0.2.6 Release Notes,采集于 2026-11-04。
