
run-ai
dsx-ai-factory/run-ai加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象这样一幕:某中型AI企业的机房里躺着 64 张 A100,原本分属算法组、搜索组、风控组三个团队。硬件是够的,但没人敢保证够用——算法组说搜索组占着卡不还,搜索组说自己夜间训练排不上队,风控组的新推理服务上线已经等了两个月。问题的本质不是 GPU 不够,而是没有人来当"GPU 的调度员"。
NVIDIA Run:ai 就是这个调度员。它不是新的容器运行时,也不是又一套 CI/CD,而是架在 Kubernetes 之上的 GPU 工作负载编排层:谁来、用哪张卡、用多久、能不能抢占,全由它说了算。
Run:ai 原本是 NVIDIA 旗下的商业产品,长期以订阅制交付。2026 年 10 月 13 日,NVIDIA 宣布将其完整开源,纳入 DSX AI Factory 平台体系,代码托管在 dsx-ai-factory/run-ai。开源拆分为四个可独立采用的模块:KAI Scheduler(GPU 感知的 K8s 调度引擎,本身已是 CNCF Sandbox 项目)、GPU Fractioning Operator(基于 CUDA 13.4 原生分片的 GPU 共享)、KAI Resource Management(组织级配额与层级)、Workload Map(统一的工作负载契约)。Crusoe、Mirantis、Nebius、OpenNebula、Rafay、Saturn Cloud、Spectro Cloud、vCluster 等八家 DSX 生态伙伴在首发当天即宣布集成。
这是一个清晰的战略信号:NVIDIA 想把 AI 工厂的调度层变成事实标准。开源不是为了卖更多硬件,而是让所有 AI 云和私有化部署都跑在同一套 GPU 治理语义上。
代码规模不小:主语言 Go(约 4300 万字节),辅以 TypeScript + Vue 前端、PL/pgSQL、Python、Java,是典型的企业级 monorepo。仓库结构划分清晰:
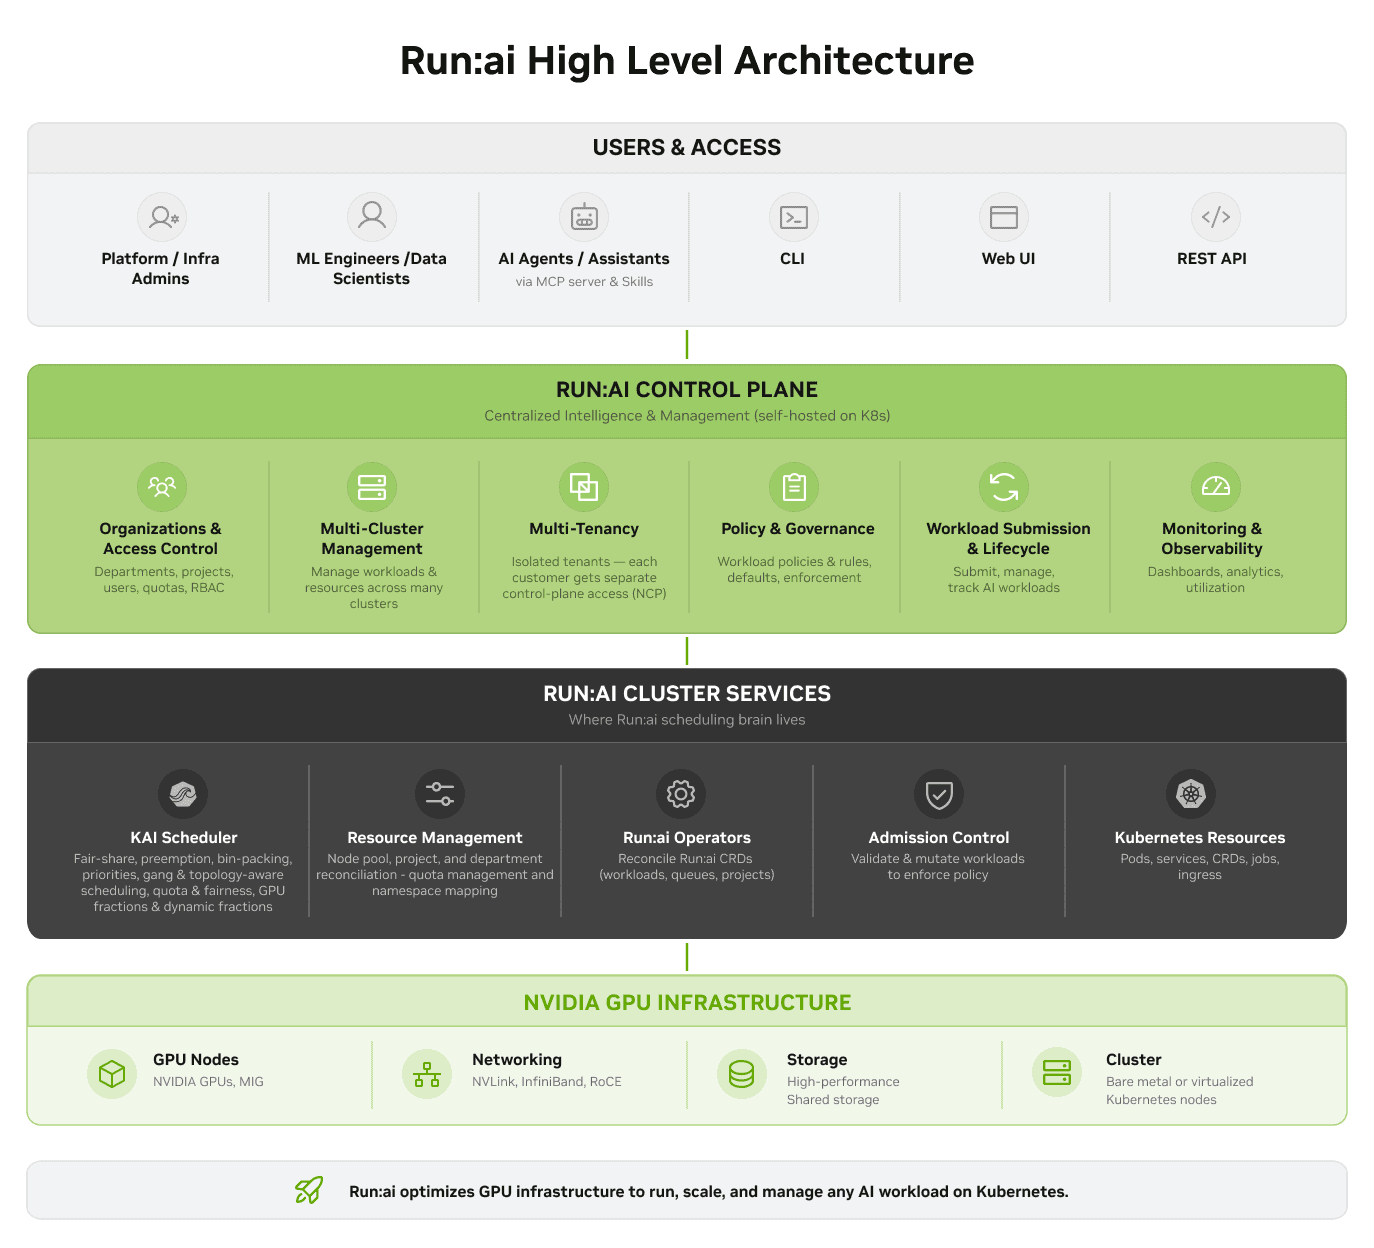
值得注意的是 MCP Server 与 skills 目录——这是相当新的设计。运维人员可以直接对 AI 助手说"看看这周哪些工作负载超配额了",助手通过 MCP 工具查询 Run:ai API 后给出结论。AI 基础设施的管理者,第一次真正把 LLM 接进了自己的运维闭环。
GPU 感知调度是立身之本。KAI Scheduler 支持 gang scheduling(多 Pod 作业要么全调度上要么不调度,避免半启动浪费资源)、基于时间的公平共享、抢占、bin-packing、拓扑感知放置。动态 GPU 分配允许按分数切分 GPU,多个 notebook 或小模型推理共享同一张卡。多集群管理让一个控制平面同时管多个 K8s 集群,跨本地、云和混合环境统一调度。
治理是企业客户真正掏钱买的东西:按部门、项目、团队分配配额,RBAC 权限控制,全量审计日志。工作负载类型覆盖工作空间、训练、分布式训练、推理,并与 Training Operator、LeaderWorkerSet、Knative、KServe 集成。
生产安装并不轻松。需要 Kubernetes 1.31+ 或 OpenShift,先过支持矩阵与系统需求检查,再用 runai-installer 走引导式安装(预检、装依赖、部署控制平面与集群组件),镜像从 nvcr.io/nvidia/runai-oss 拉取,Chart 从 helm.ngc.nvidia.com 拉取。也可以手动装 Helm Chart 以对接自己的 Argo CD 流程。离线/气隙环境同样支持。
本地开发环境则友好得多。./local-dev.sh 会自动装好 kind/kubectl/helm,编译约 50 个 Go 服务到容器内,构建镜像后用 kind load docker-image 直接灌进集群,部署到自签 TLS 证书之后,访问 https://runai.local 即可。代价是资源:Linux 主机需 ≥4 核、≥16GB 内存、≥100GB 磁盘(一次完整构建后约 44GB 缓存 + 8GB 镜像),Podman VM 至少 12GB 内存,机器紧张时得用 --parallel 2 --skip-frontend 硬扛。宿主机器不需要装 Go/Node/Java,所有构建都在容器里完成。
它不是万能药。README 明确写着:如果只需要在独享 GPU 上跑单个团队的作业,Kubernetes 原生调度就够了。Run:ai 的价值在多团队共享场景,硬上反而是负担。
组件极其庞杂。30+ 控制平面微服务,NATS、PostgreSQL、Keycloak 等依赖一应俱全,运维复杂度不容小觑。根目录 Makefile 甚至是占位符,真正的构建目标散落在各服务目录。
商用边界仍需看清。代码是 Apache 2.0,但商标、Logo、字体等品牌资产不在授权范围内;从 NGC 拉取 Community Product 需接受 NVIDIA SLA。开源代码 ≠ 免费企业支持。
生态位竞争激烈。Volcano、Kueue、Run:ai 在 GPU 调度上正面相遇,vLLM/Slime 社区的 GPU 共享方案也在演进。KAI Scheduler 已进入 CNCF Sandbox,这是积极信号,但护城河深度仍待观察。
Run:ai 开源折射出一个更大的趋势:AI 基础设施的竞争重心正从"算力供给"转向"算力治理"。当 GPU 成为企业最贵的共享资源,如何把"抢卡"变成"排队领用",就成了必须工程化的问题。NVIDIA 把这一层开源,本质上是把调度语义标准化——谁掌握语义,谁就掌握生态入口。
对想自建 AI 工厂的团队来说,这是目前最完整、也最重的开源选项;对只跑推理、不共享 GPU 的团队,它大概率是过度设计。671 位贡献者、上百个 PR 在手,这个项目正在以工业级速度推进,值得持续观察。
