
PHUDGE
deshwalmahesh/PHUDGE加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
大型语言模型(LLM)日新月异,如何科学、客观地评价模型输出质量,长期困扰着 AI 研究者。传统方法要么依赖人类标注,成本高昂且效率低下;要么依赖闭源 API(如 GPT-4),存在数据主权和成本问题。研究者们迫切需要一种本地化、可复现、支持自定义评分标准的 LLM 评测方案。
这就是 PHUDGE 诞生的背景。
PHUDGE(Phi-3 as Scalable Judge)由研究者 deshwalmahesh 发布,相关论文发表于 2024 年 5 月(arXiv:2405.08029)。项目基于微软 Phi-3-mini 模型进行微调,将其改造为一个可量产的 LLM 评测"裁判"模型,专门用于评估其他 LLM(甚至人类)的回答质量。
从定位上看,PHUDGE 对标的是 Prometheus-2 等开源评测模型,但其参数量仅为后者的 1/10,却实现了 4 项基准测试上的 SOTA(最优)表现,同时在 JudgeLM 零样本设置下排名第二,超越了 PandaLM。
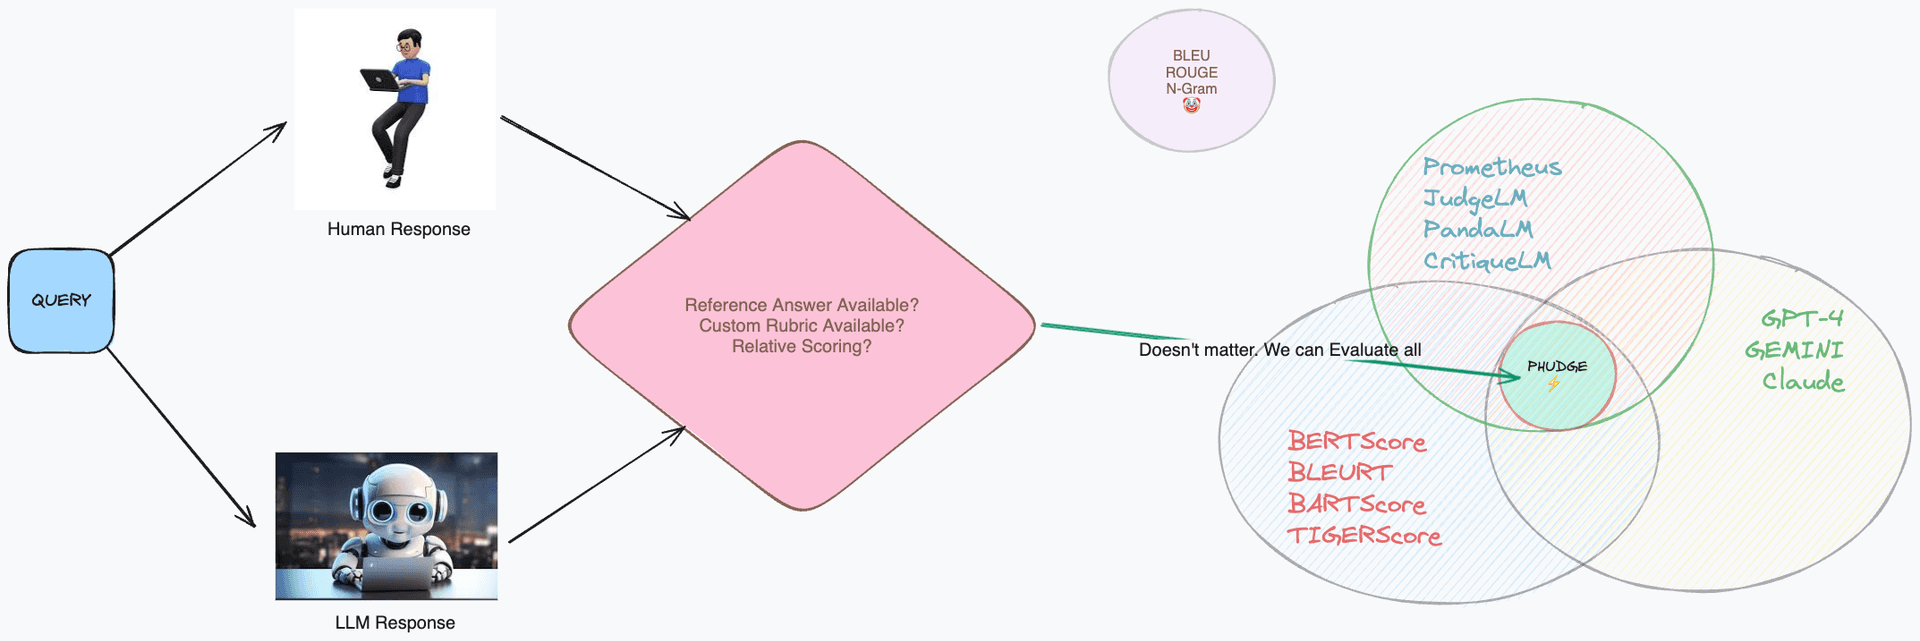
PHUDGE 基于 Phi-3-mini 微调,实现轻量级 LLM 评测
PHUDGE 的核心能力,是支持灵活的评测输入组合——"问题 + 待评测回答 + 自定义评分标准(可选)+ 参考答案(可选)"。这意味着:
输入"问题 + 回答",PHUDGE 直接给出 1-5 分的质量评分。适合没有标准答案的开放式问题,如创意写作、客服对话等场景。
两个回答 PK,PHUDGE 判断哪个更好。适合模型对比评测、Chatbot 竞技等场景。
用户传入自定义评分标准(如"答案是否简洁明了?是否包含关键信息点?"),PHUDGE 按标准逐项打分。这对企业级评测、垂直领域评估尤为重要。
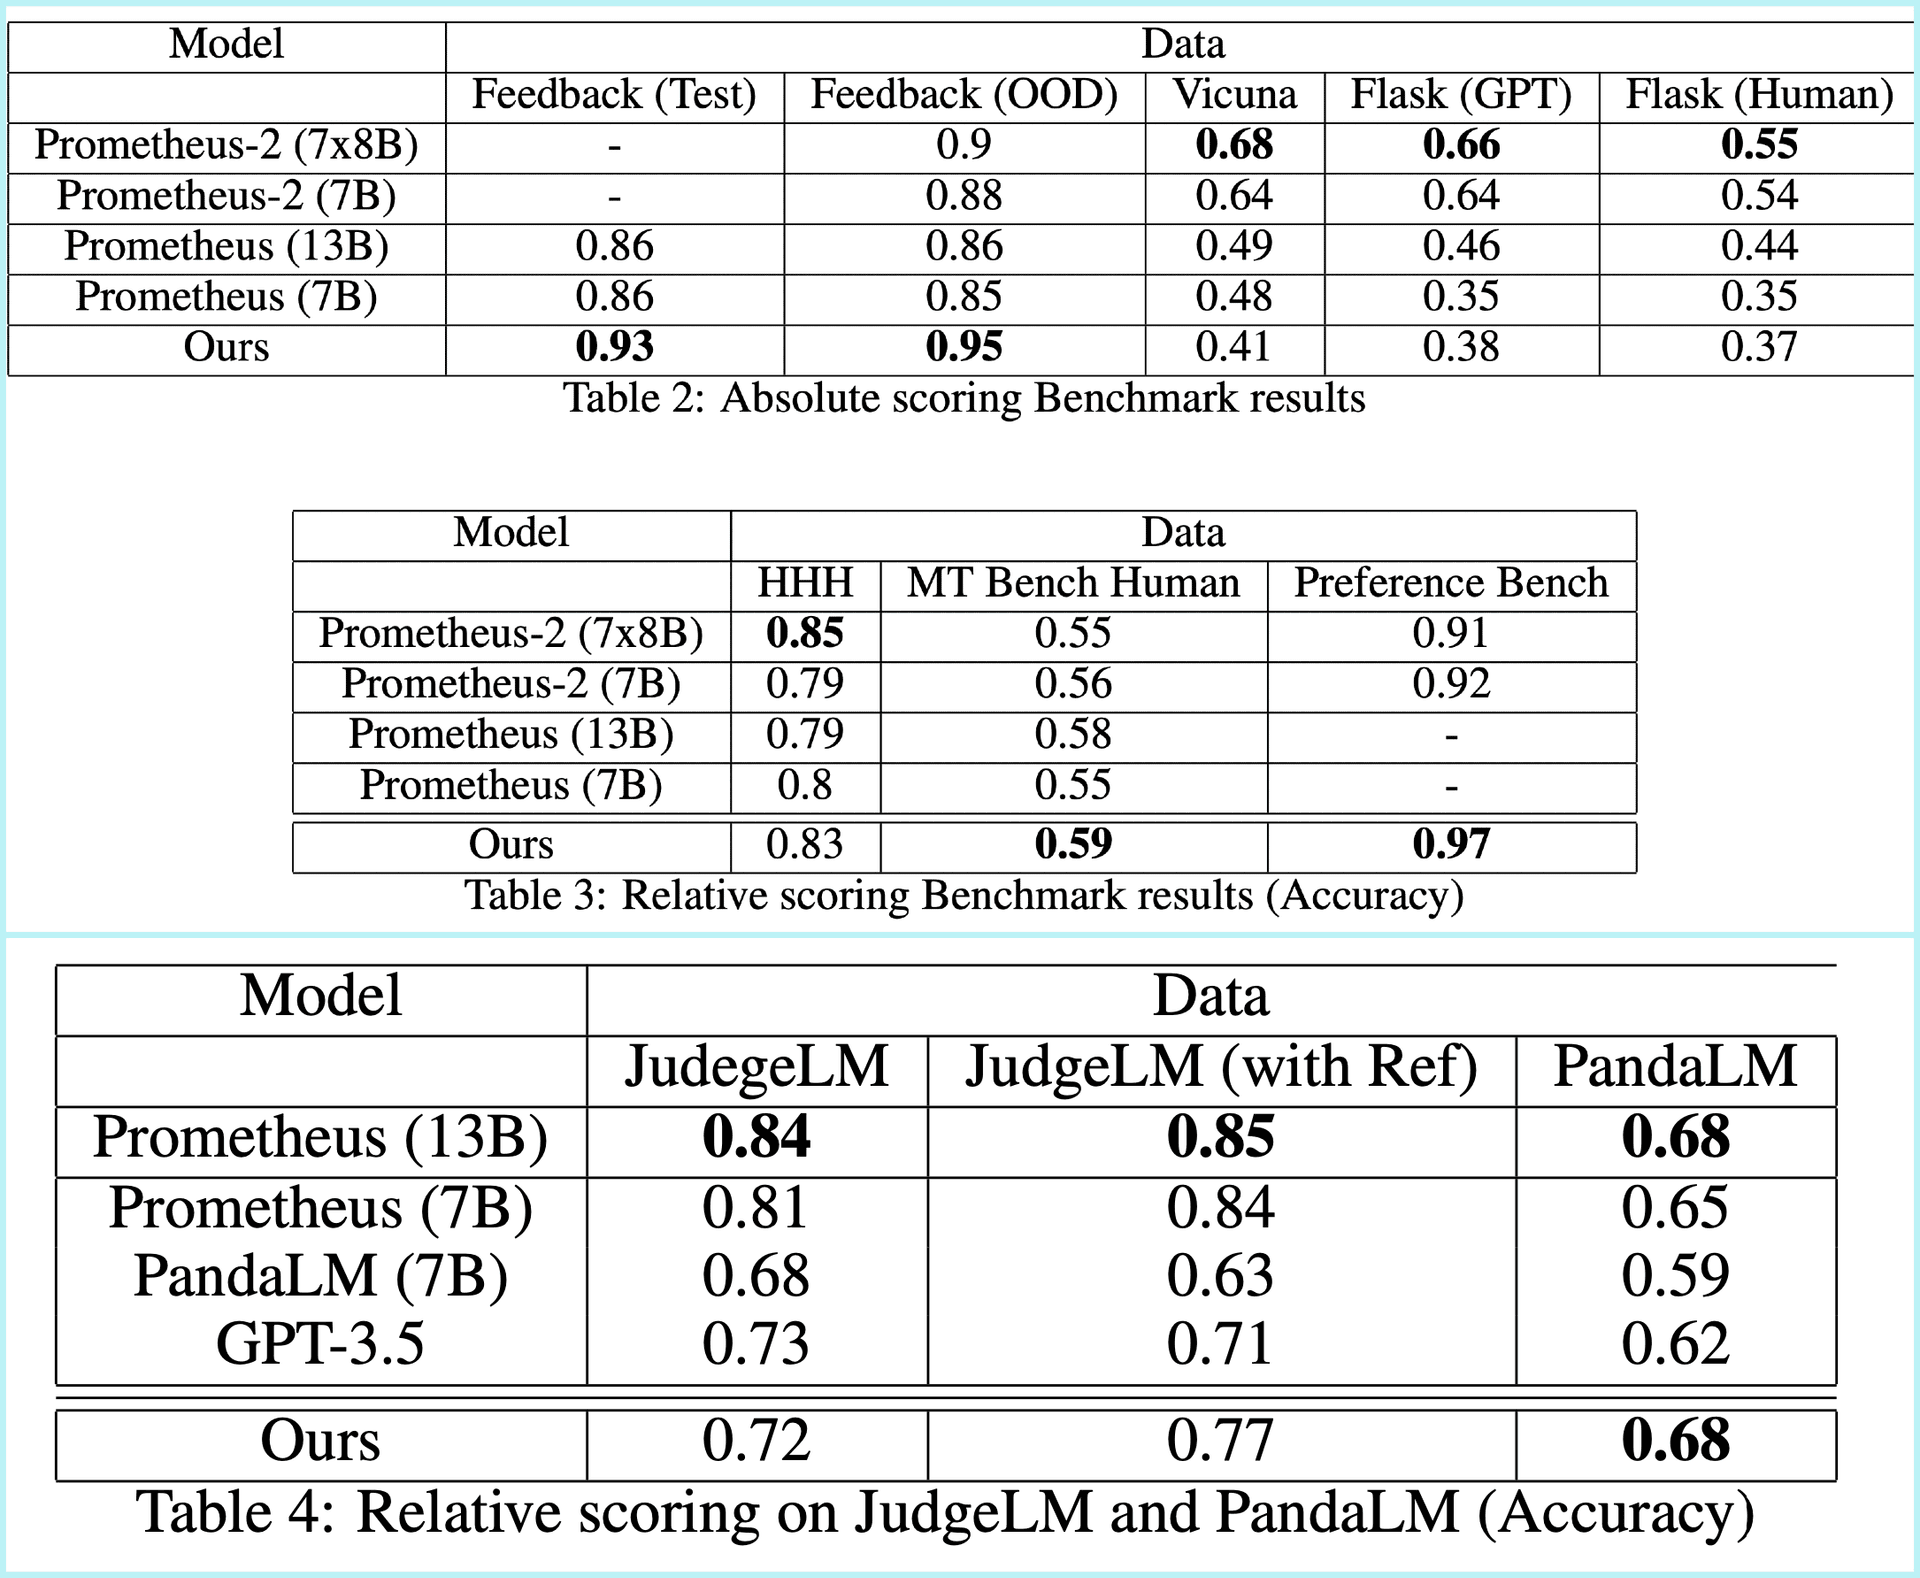
PHUDGE 在 4 项基准测试中达到 SOTA,超越参数量大 10 倍的 Prometheus-2
项目采用模块化设计,按任务类型分为三个子目录:
| 目录 | 任务类型 | 说明 |
|---|---|---|
classif/ | 分类任务 | 用于判断回答质量的分类模型 |
causal/ | 因果推理 | 针对因果逻辑类问题的评测 |
reg/ | 回归任务 | 输出连续分数(1-5) |
训练技术栈:
数据集来源:项目使用了改良版的 Feedback Collection 数据集,并提供了 Kaggle 上的最终 LoRA 权重供直接下载使用。
项目提供了 Kaggle Notebook 版本,可在云端 GPU 上直接运行,无需本地配置:
需要 conda 环境、Python 3.10、CUDA 11.8+、NVIDIA A10 以上 GPU(推荐)。官方提供了 scripts/create_conda_env.sh 一键安装脚本,但 DeepSpeed 配置需根据实际硬件手动调整 accelerate_default_config.yaml。
官方明确注明使用了 transformers 开发版(截至 2024 年 5 月),这意味着依赖版本敏感性较高,生产环境使用需锁定版本。
PHUDGE 的出现,标志着开源、轻量、可定制的 LLM 评测方案进一步成熟。它让研究团队无需依赖 GPT-4 API,即可实现一致的评测标准,降低了 LLM 研究的门槛和成本。
此外,项目仓库还整理了一份 75+ 种 LLM 评测方法清单,涵盖评测工具、博客、论文、代码库等资源,是 LLM 评测领域的宝贵导航图。
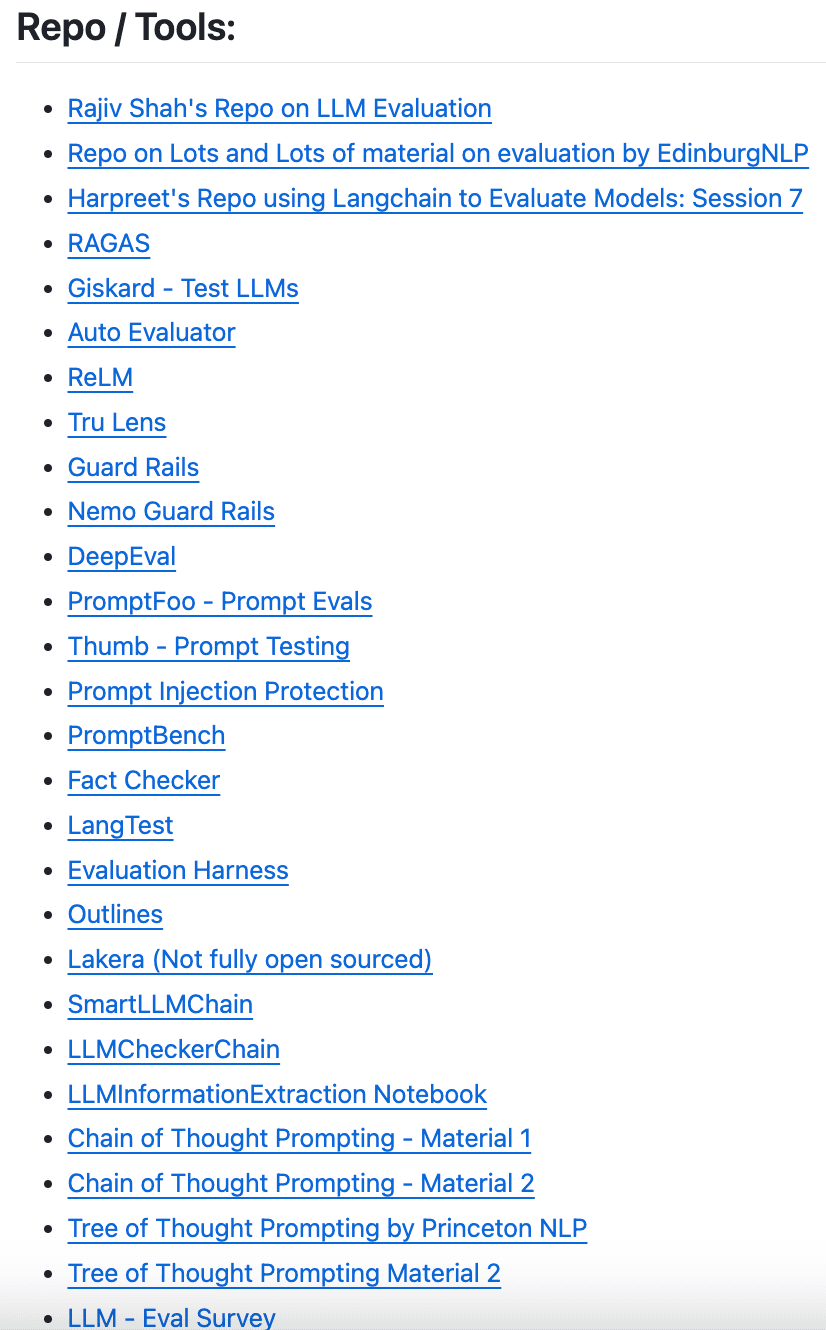
项目整理的 75+ LLM 评测方法图谱
PHUDGE 适合以下用户:
✅ NLP 研究团队:构建本地化评测流水线,替代 GPT-4 API 评测 ✅ LLM 微调实践者:对比微调前后的模型质量提升 ✅ 评测基准维护者:构建垂直领域自定义评分标准 ❌ 普通开发者:无 GPU 或缺乏 NLP 经验者慎入 ❌ 生产级应用:需要 API 服务封装的项目不适合直接使用
