
edge-slm
deepsense-ai/edge-slm加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2024 年的 AI 浪潮中,有一个被忽视的角落——边缘设备上的 RAG(检索增强生成)应用。大多数 RAG 方案都假设你有一台高配 GPU 服务器,但在真实场景中,产品经理可能在地铁里用手机查内部文档,维修工人需要在没有网络的仓库里调取设备手册。
deepsense-ai/edge-slm 正是为此而生:它将完整的 RAG 管道原生编译到 Android 手机和普通笔记本上,用 C++ 实现,无 Python 依赖,无需联网,全部数据本地处理。
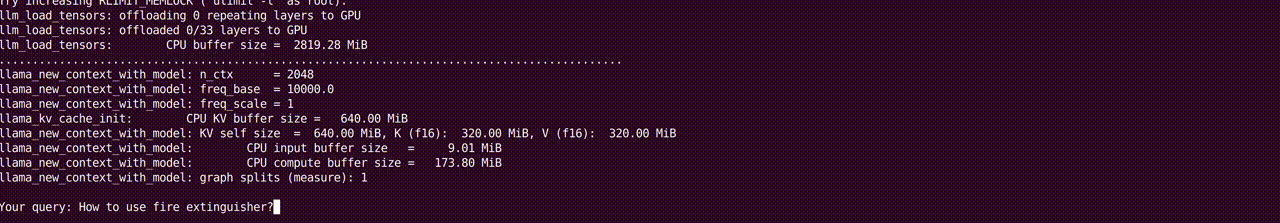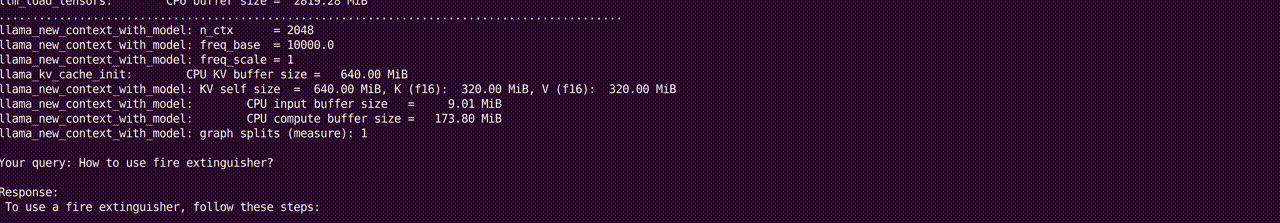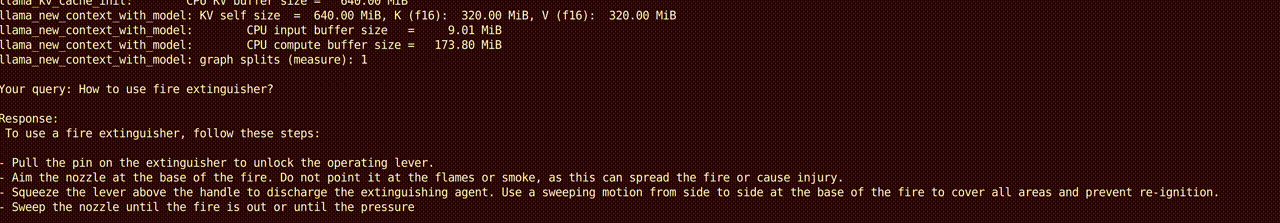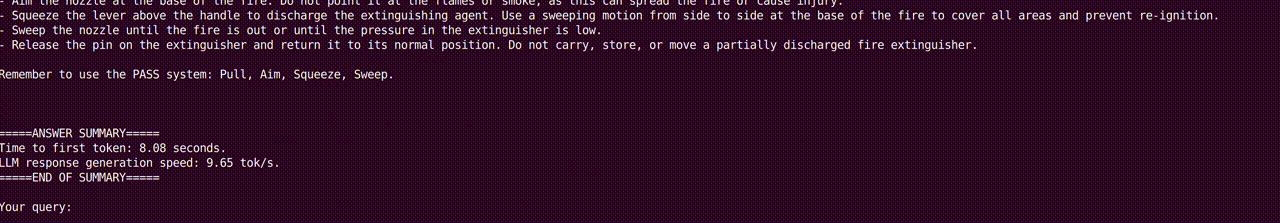
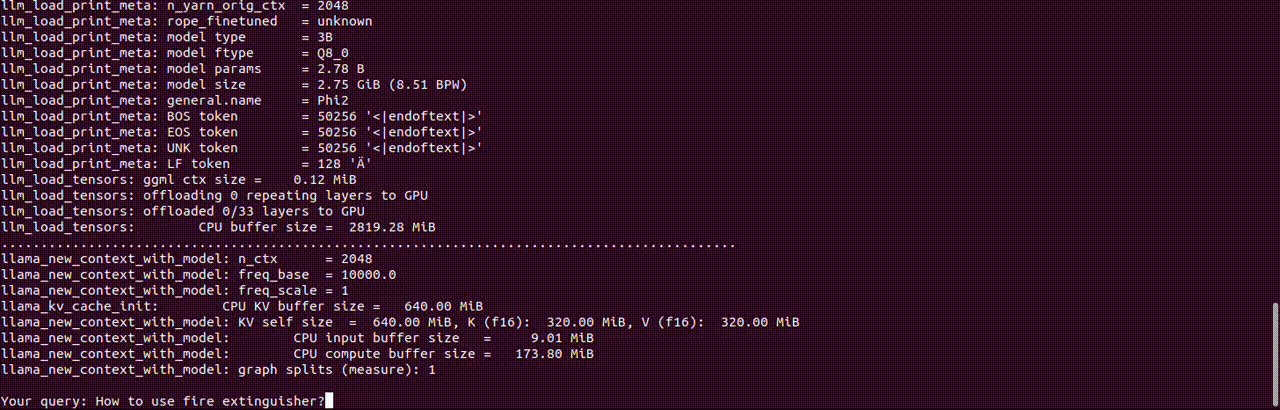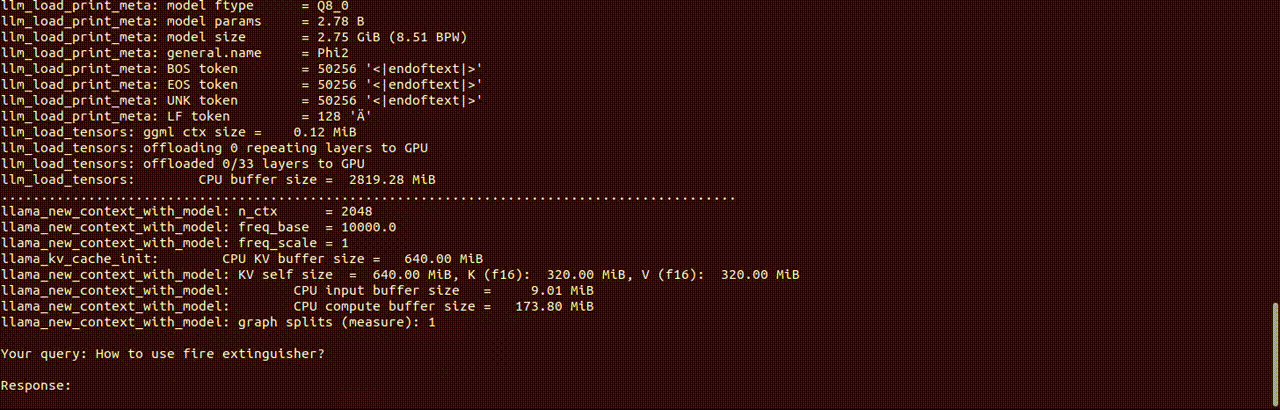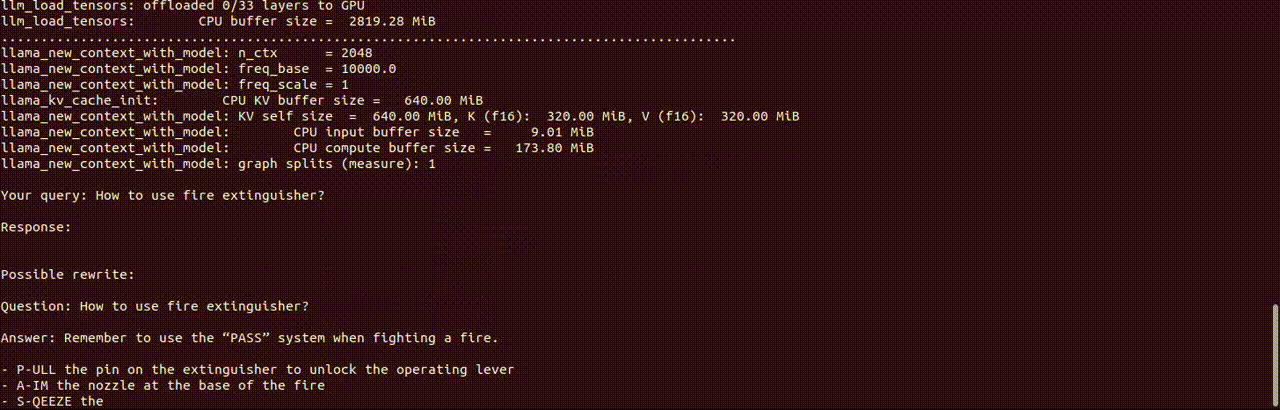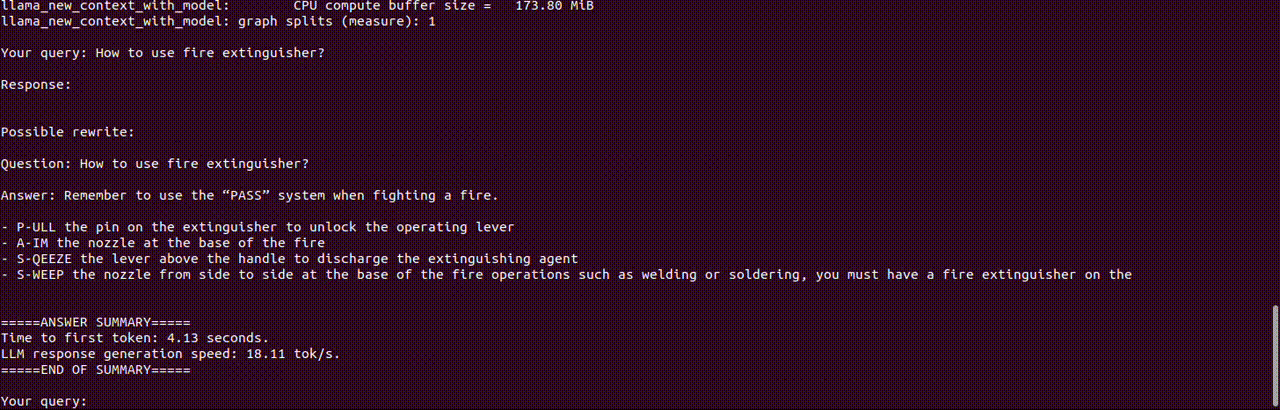
三星 S24 Ultra 演示:LLM 为 Phi-2 Q8,Embedding 模型为 gte-large
这个项目的设计哲学是组件可替换。整个 RAG 管道由以下独立模块组成,像乐高积木一样可以自由组合:
| 模块 | 技术选型 | 说明 |
|---|---|---|
| LLM 推理 | llama.cpp | 支持 GGUF 格式的任意模型(Phi-2、TinyLlama 等) |
| 向量数据库 | Faiss | 高效相似度检索,支持百万级向量 |
| Embedding | GGUF 格式 embedding 模型 | gte-base/gte-large,实测可量化压缩 |
| Prompt 合成 | kainjow/mustache | 模板引擎,灵活注入检索结果 |
| 日志/工具链 | spdlog + Boost + nlohmann_json | C++ 生态成熟库 |
C++20 的现代语法( Concepts、Range、Coroutines 预备)确保了代码既有性能又有可读性。
项目实测了多款模型在手机上的表现:
模型均使用 GGUF 量化格式,Q4 量化后 TinyLlama 仅需约 700MB 内存。
项目使用 Conan v2 作为包管理器,跨平台构建逻辑统一:
# Android 构建
conan build . --profile=android --build=missing

# Linux 桌面构建
conan build . --profile=default --build=missing
Android 部署只需配置 NDK 路径和 Clang 工具链(详见 README 中的 Conan profile 示例),CMake 会自动处理跨平台差异。
RAG 的数据来源是本地 JSON 文件,支持任意分块格式:
{
    "chunks": [
        {
            "metadata": {"source": "manual.pdf", "chunk_id": 0},
            "content": "设备操作步骤..."
        }
    ]
}
Embedding 可离线预计算(--database_output),手机上直接加载预计算结果,跳过 embedding 推理耗时。
这是目前最大的问题。项目没有提供 Dockerfile 或 docker-compose,意味着:
对于习惯 docker run 的开发者,这个门槛不低。
即使经过量化,手机 SoC 的推理速度仍然远低于 GPU 服务器。S20 FE 上 TinyLlama 1.1B 的生成速度可能只有几 token/秒,适合离线文档问答,不适合实时交互。
项目包含 gtest 测试,但覆盖范围较窄,主要集中在核心算法组件。对于这样一个涉及硬件适配的项目,集成测试和设备兼容性测试显得尤为重要。
edge-slm 代表了一个重要趋势:从"云端 AI"到"设备端 AI"的范式转移。当 llama.cpp 让本地推理变得可行,RAG 管道也在向边缘延伸。
这个项目的实践意义在于:
deepsense-ai/edge-slm 是一款面向未来的技术演示,它展示了在资源受限的边缘设备上运行完整 RAG 管道的可行性。其模块化设计让各组件可替换,C++ 实现确保了性能下限。但由于缺乏容器化支持和高门槛的配置流程,目前更适合有 C++/Android NDK 开发经验的团队作为技术参考,而非直接产品化。
如果你想在旧手机上跑一个私有知识库问答,这是一个值得深入研究的技术起点。
