
DualPipe
deepseek-ai/DualPipe加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
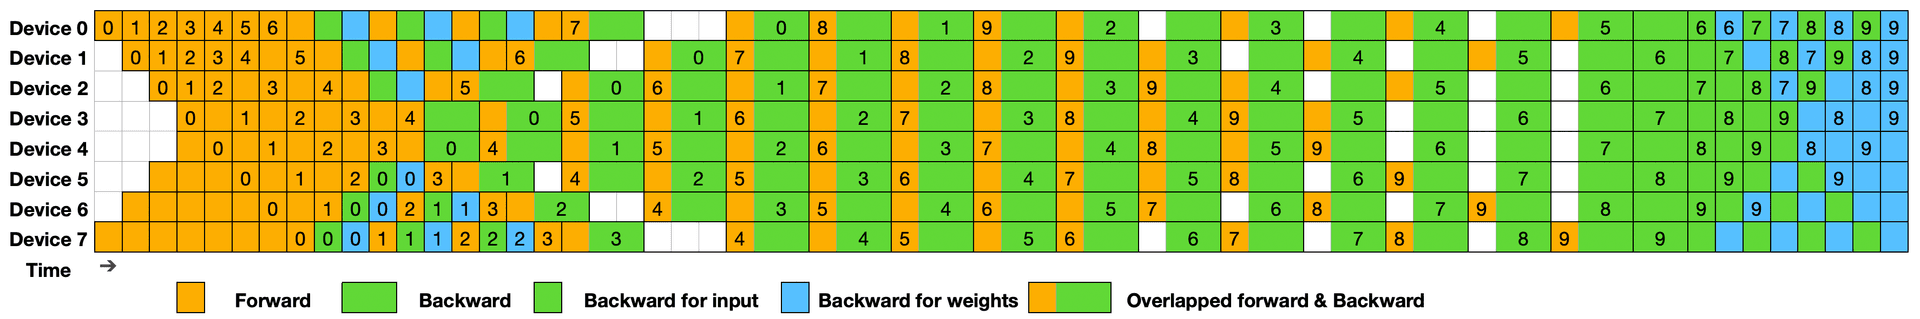 图1:DualPipe 双向流水线调度示意图(8 PP ranks,20 micro-batches)
想象你经营一家工厂,流水线作业是唯一高效的生产方式——产品按顺序流经多个工作站,每个工作站只负责特定工序。在深度学习的大模型训练中,GPU 集群也面临同样的问题:模型太大,单张 GPU 装不下,必须将模型切分到多张显卡上,形成「流水线」——数据在 GPU 之间按顺序传递,每个 GPU 负责模型的一个「阶段」。
传统方案(如 1F1B)的问题在于:同一时刻,每个 GPU 要么在处理前向传播(接收数据、加工、传给下一站),要么在等待反向传播的梯度信号。这两个阶段无法同时进行,就像工厂流水线上的机器,要么在加工,要么在空等——巨大的算力浪费由此产生。
更糟糕的是,在跨节点并行训练中(如 MoE 架构的 Expert Parallel),GPU 之间需要频繁交换数据(All-to-All 通信)。如果 GPU 在等待通信完成时无法同时进行计算,训练效率将进一步崩塌。
这就是 DualPipe 要解决的核心问题:让前向和反向传播「双向同时跑」,把 GPU 的每一刻空闲都填满。
DualPipe 由 DeepSeek 团队开发,首次出现在 DeepSeek-V3 技术报告 中。DeepSeek-V3 是一个拥有 2360 亿参数的混合专家(MoE)大语言模型,其训练依赖大量跨节点 GPU 通信——每个 Token 需要路由到 8 个专家(Expert),这些专家分布在不同节点上。
DeepSeek 团队测算,如果不优化并行策略,跨节点 All-to-All 通信会与计算形成 1:1 的时间比——GPU 一半时间在算,一半时间在等。这意味着即使堆再多 GPU,效率天花板也极低。
DualPipe 的设计哲学:不降低通信量,而是让通信「隐藏」在计算背后。通过精细的调度策略,让 GPU 在等待数据到达时正好有计算任务可以执行,反之亦然。
传统流水线(如 1F1B)将 micro-batches 从流水线一端注入,数据顺序流过每个 GPU:
这种模式下,流水线两端(GPU 0 和 GPU 最后一个)有大量空闲时间——前端等数据,后端等梯度。
DualPipe 的关键创新:从流水线两端同时注入 micro-batches。假设有 8 个 PP rank(流水线阶段),传统方法只从 rank 0 注入,而 DualPipe 同时从 rank 0 和 rank 7 注入,形成真正的「双向流水线」。
这样,每个 GPU 都能同时参与两个不同 batch 的不同阶段:
GPU 不再需要在前向和反向之间二选一,而是同时处理两者。
DualPipe 的实现还借鉴了 Zero-Bubble(ZB1P)的思路,将反向传播进一步细分为两个子阶段:
在 DualPipe 中,每个 chunk 被分解为四个组件:Attention、All-to-All Dispatch、MLP、All-to-All Combine。传统方法中,这些组件必须严格串行执行;而 DualPipe 通过精心调度 GPU SM(流多处理器)的分配比例,让通信和计算在时间轴上深度重叠。
以 All-to-All 通信为例:跨节点的 IB(InfiniBand,50 GB/s)和节点内的 NVLink(160 GB/s)带宽相差 3.2 倍。DeepSeek 的优化方案是:每个 Token 最多路由到 4 个节点,优先通过 IB 传输到目标节点内相同索引的 GPU,再通过 NVLink 瞬时转发到目标 Expert 所在的具体 GPU。整个通信过程只需 20 个 SM 即可完全利用 IB 和 NVLink 带宽——这些 SM 与计算流重叠执行,对计算效率几乎无影响。
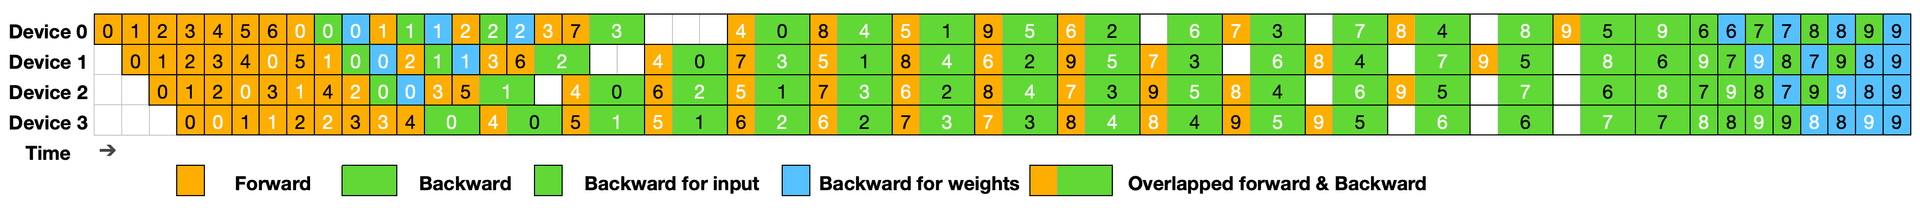 图2:DualPipeV(V形调度)示意图,进一步精简设备数量
| 方法 | 流水线气泡 | 每设备参数量 | 每设备激活量 | 设备数 |
|---|---|---|---|---|
| 1F1B | (PP-1)(F+B) | 1× | PP | PP |
| ZB1P | (PP-1)(F+B-2W) | 1× | PP | PP |
| DualPipe | (PP/2-1)(F&B+B-3W) | 2× | PP+1 | PP |
| DualPipeV | (PP/2-1)(F&B+B-3W) | 2× | PP+1 | PP/2 |
PP = 流水线阶段数;F = 前向传播时间;B = 反向传播时间;W = 权重更新时间;F&B = 前向反向重叠执行时间
DualPipe 的气泡公式中,PP 被除以 2,这意味着气泡数量不随流水线长度增加而线性增长——这是一个非线性优化。同时,其代价是每设备参数量翻倍(2×),因为需要同时持有「前半段」和「后半段」两套参数。
DualPipe 的代码极为简洁,核心文件仅 5 个:
dualpipe/dualpipe.py:主调度逻辑,DualPipe 类实现双向流水线dualpipe/dualpipev.py:DualPipeV 的 V 形调度变体,设备数量减半dualpipe/comm.py:通信原语封装(P2P Send/Recv)dualpipe/utils.py:工具函数(权重梯度存储、反向执行)examples/example_dualpipe.py:使用示例使用 DualPipe 的核心前提:实现自定义的 overlapped_forward_backward 方法。这个方法需要让同一模块同时支持前向和反向计算,从而在同一个 chunk 内实现计算与通信的真正融合。以 DeepSeek-V3 为例,这需要在 Attention 和 MoE 层中嵌入通信调度逻辑。
安装只需一行:
pip install .
运行示例:
python examples/example_dualpipe.py
python examples/example_dualpipev.py
依赖:PyTorch 2.0+,无其他第三方依赖。
需要深度定制:DualPipe 不是开箱即用的训练框架。用户必须在自己的模型中实现 overlapped_forward_backward,这需要深入理解模型架构与并行策略的耦合关系。
内存开销翻倍:由于需要同时持有流水线前后两段的模型参数,每 GPU 的参数量为 2×。这对显存提出更高要求。
通信拓扑敏感:All-to-All 的优化高度依赖网络拓扑(IB + NVLink 的带宽配比)。在不同集群上可能需要重新调优。
适用场景有限:对于单节点训练或不需要跨节点 Expert Parallel 的场景,DualPipe 的收益有限。它专为 DeepSeek-V3 级别的大规模 MoE 训练设计。
DualPipe 的出现,标志着大模型训练进入「工程精细化」时代。随着模型规模逼近甚至超过万亿参数,简单的并行策略已无法充分利用硬件。DeepSeek 通过 DualPipe + DeepEP + DeepGEMM 的组合拳,展示了在有限硬件条件下(据报道仅约 2000 张 H800)训练出比肩 GPT-4o 的模型的可能性。
DualPipe 的双向流水线思路也已影响到更广泛的并行训练社区。Sea AI Lab 基于 DualPipe 提出了 DualPipeV,进一步将设备需求减半。这种「先大幅优化,再精简资源」的路径,为资源受限的团队提供了可参考的工程范式。
相关项目:DeepSeek-V3 技术报告 (arXiv:2412.19437),HuggingFace 团队撰写的 DualPipe 详细解读
