
DeepSeek-V2
deepseek-ai/DeepSeek-V2加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下,一个城市的供水系统,以前每户用水都需要从水厂铺设一根专属管道,成本极高、效率极低。突然有一天,工程师设计出一种"智能调度系统"——只有当某户真正需要用水时,才临时从水厂调配专用管道,用完即回收复用。同样的管道数量,却能同时服务更多用户,成本大幅下降。这正是 DeepSeek-V2 在大语言模型领域做的事:用更少的计算资源,驱动一个参数规模空前的巨型模型。
DeepSeek-V2 是由深度求索公司(DeepSeek AI)于 2024 年 5 月发布的混合专家(Mixture-of-Experts,MoE)大语言模型。它拥有 2360 亿总参数,但每次推理只激活其中 210 亿参数。相比自家上一代 DeepSeek 67B dense 模型,训练成本骤降 42.5%,KV 缓存缩减 93.3%,最大吞吐量提升 5.76 倍。这个数字背后,是一场悄无声息却意义深远的技术范式转变。
理解 DeepSeek-V2,首先要理解什么是 MoE(混合专家)架构。
传统大模型(如 GPT-4、LLaMA)都是"Dense"(稠密)模型——每次推理,模型的每一层、每一个参数都要参与计算。就像一台始终全功率运转的发动机,不管负载轻重,燃油消耗都一样。而 MoE 的核心思想是"专家分工":将模型分解为多个"专家"子网络,推理时通过门控路由机制,只激活与当前任务最相关的少数专家。形象地说,Dense 模型是"全科医生",MoE 模型是"专家会诊"——各科专家按需到场,其余休息。
DeepSeek-V2 并不是 MoE 领域的第一个探索者。Google 的 Switch Transformer、Mixtral 的 8×22B 都是知名先例。但 DeepSeek-V2 的突破在于,它不仅将 MoE 做到了前所未有的规模(236B 总参数),更在注意力机制上引入了自研的 MLA(Multi-head Latent Attention,多头潜在注意力) 技术,从 KV 缓存这个长期痛点切入,实现了效率的质的飞跃。
DeepSeek-V2 的架构由两大核心组件构成:
MLA(多头潜在注意力) 是本项目最具原创性的技术创新。传统 MHA(多头注意力)在长上下文推理时,KV 缓存成为严重瓶颈——上下文越长,需要缓存的 Key-Value 向量越多,显存压力呈线性增长。MLA 的解决方案是"低秩压缩":不直接存储完整的 Key-Value,而是将它们压缩到低维潜在空间,推理时再解压。这使得 KV 缓存体积大幅缩减,为长上下文(最高 128K tokens)提供了硬件可行性。
DeepSeekMoE 则是一种高性能 MoE 架构。它采用了细粒度的专家分割策略(fine-grained expert segmentation)和共享专家隔离(shared expert isolation)技术,在保持专家多样性的同时,避免了负载不均衡导致的计算资源浪费。相比粗粒度的传统 MoE,DeepSeekMoE 能够在同等激活参数下获得更强的模型表达能力。
这两项技术的结合,让 DeepSeek-V2 在多项基准测试中与 LLaMA3 70B 打得有来有回,而实际推理成本却远低于对手。例如,在中文理解基准 C-Eval 上,DeepSeek-V2 得分 81.7,远超 LLaMA3 70B 的 67.5;在代码任务 LiveCodeBench 上,DeepSeek-V2 Chat (RL) 得分 32.5,也明显领先于 LLaMA3 70B 的 30.5。
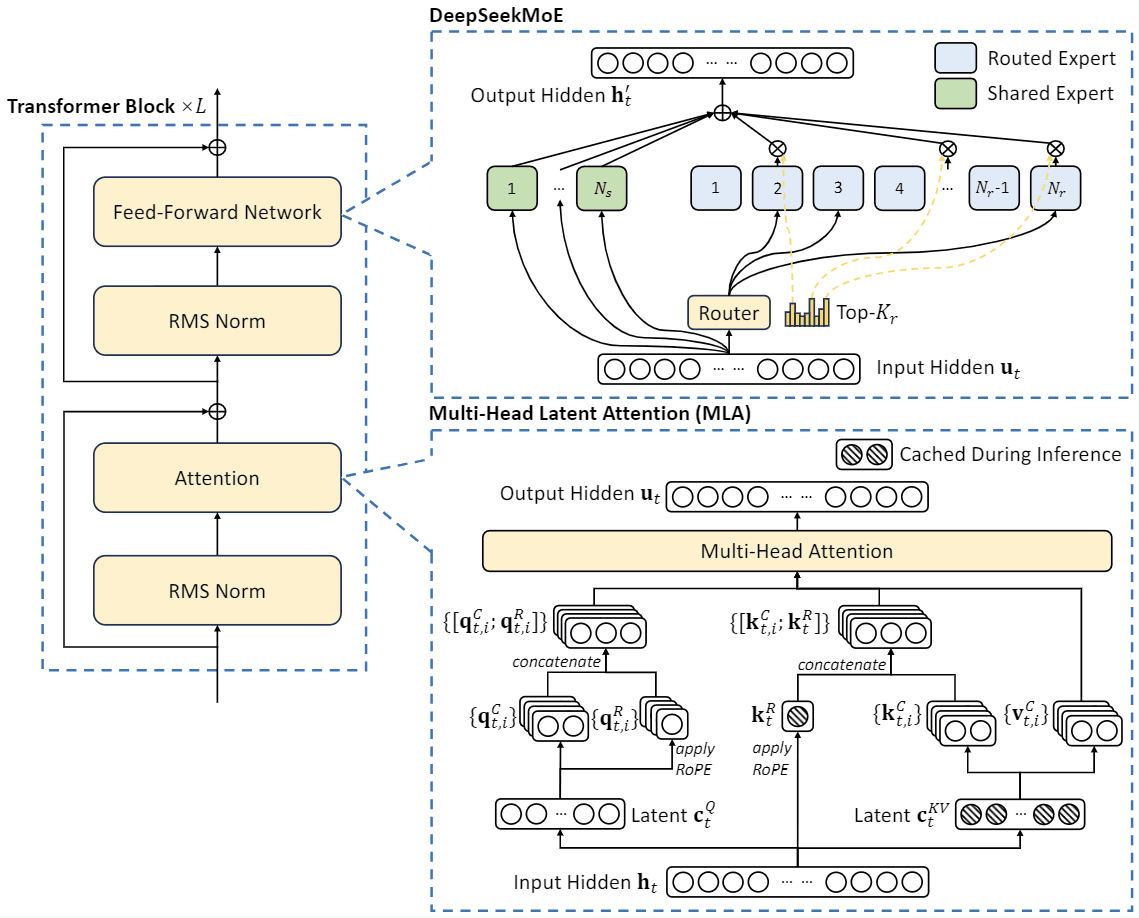
图1:DeepSeek-V2 整体架构,MLA 与 DeepSeekMoE 协同工作
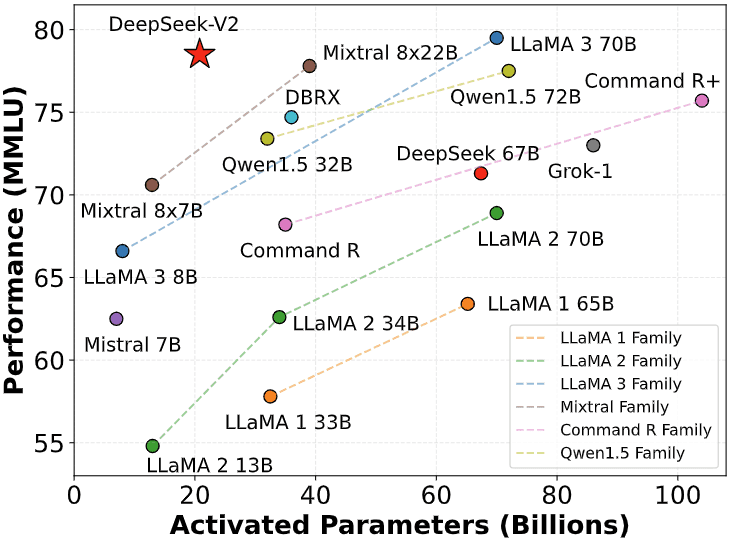
图2:不同模型的总参数量与激活参数量对比,DeepSeek-V2 以 236B 总参数、21B 激活参数实现高效推理
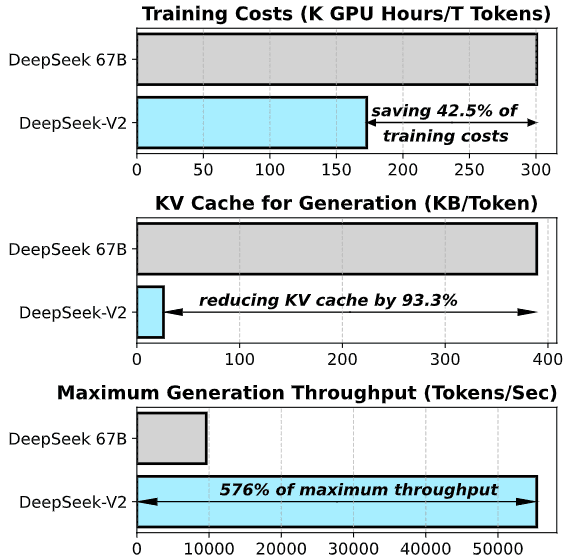
图3:训练成本对比,DeepSeek-V2 相比 DeepSeek 67B 节省 42.5% 训练成本
从评测结果来看,DeepSeek-V2 是一个相当均衡的选手:
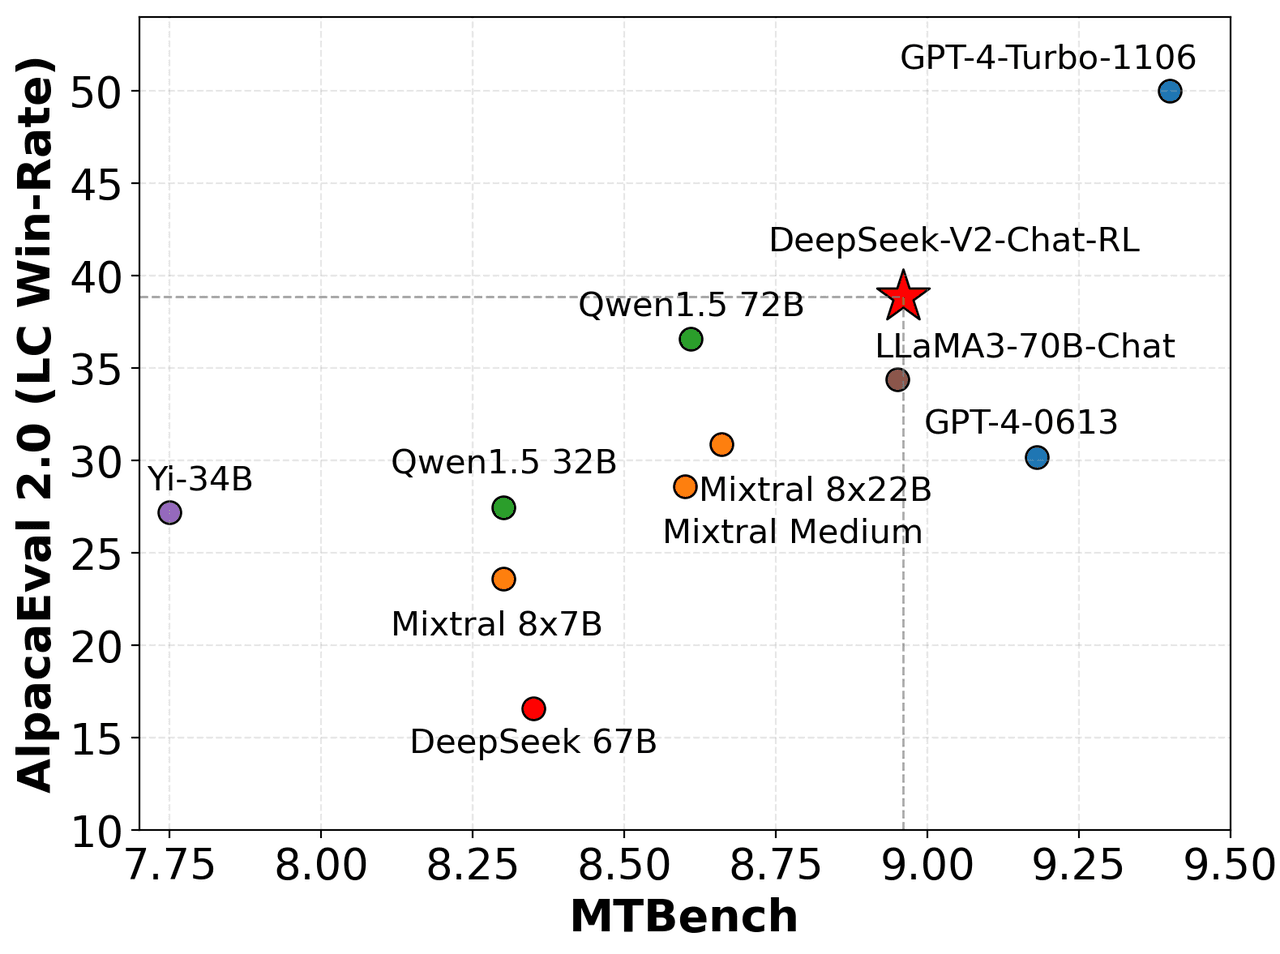
图4:MT-Bench 多轮对话评测,DeepSeek-V2 Chat (RL) 表现与 GPT-4-Turbo 相当
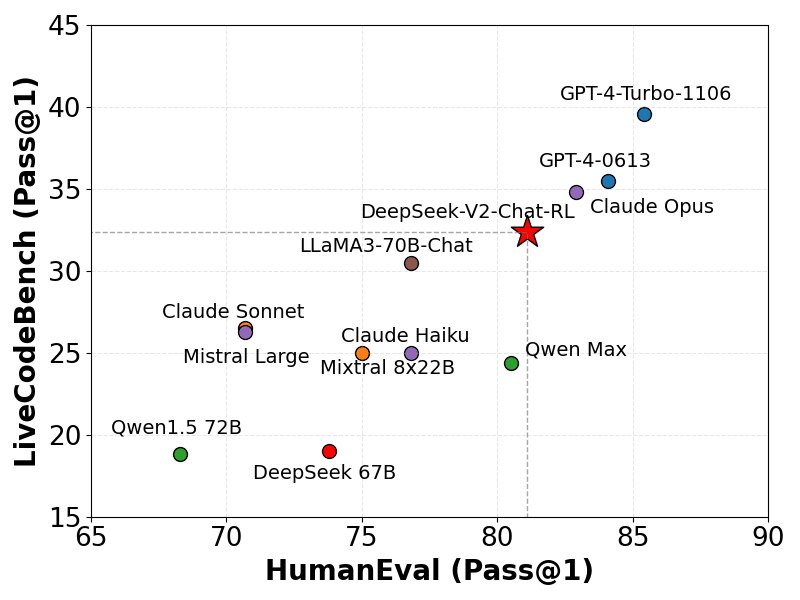
图5:LiveCodeBench 实时代码评测,DeepSeek-V2 在各规模模型中表现优异
与同期的闭源和开源竞品对比,DeepSeek-V2 的核心优势在于性价比:官方 DeepSeek API 的定价远低于 GPT-4 等主流闭源模型,同时性能表现接近甚至部分超越。这使得它成为对成本敏感的开发者和中小企业极具吸引力的选择。
推荐普通用户使用官方 API:DeepSeek 提供了与 OpenAI API 兼容的接口(platform.deepseek.com),只需将 base_url 替换为 https://api.deepseek.com,几乎不需要改动代码即可迁移。注册即送大量免费额度,按 token 计费,成本约为 GPT-4 的 1/10。
进阶开发者本地部署:如果想完全自托管,需要做好充分的硬件准备。BF16 精度推理最低需要 8 × 80GB GPU(如 A100 或 H100/H800)。推荐使用 SGLang 或 vLLM 框架,两者都针对 DeepSeek-V2 做了专门优化(SGLang 支持 MLA 加速、FP8 量化、FP8 KV Cache 等特性)。量化到 FP8 后,推理门槛可以大幅降低,适合研究用途。
需要注意的是,DeepSeek-V2 仓库本身不包含训练代码,仅提供推理脚本和模型权重。如需复现训练过程,需参考同期发布的技术报告(deepseek-v2-tech-report.pdf),自行实现预训练/SFT/RL 流程,难度极大。
DeepSeek-V2 并非没有短板:
硬件门槛极高:即使使用 FP8 量化,单卡 A100/H100 也难以承载完整推理,8 卡分布式部署是实际落地的基本配置。这使得个人开发者和小型团队难以负担。
代码能力仍有提升空间:虽然 HumanEval 81.1 已属优秀,但与 GPT-4 系列仍有差距,复杂的多文件协作编程场景表现有待验证。
开源协议有条件限制:模型权重采用独立的 Model Agreement(非标准开源协议),商业使用需申请许可,并非完全自由的 Apache/MIT 许可。
HuggingFace 推理性能偏慢:官方明确指出,由于 HuggingFace 框架的限制,权重在 HF 上运行的实际性能不如内部实现,推荐使用 vLLM/SGLang 以获得最佳效率。
DeepSeek-V2 的出现,不仅是一个技术产品的发布,更是一个信号:
DeepSeek-V2 的星标数量(5000+)印证了社区的高度认可。它不仅是一个能用的模型,更是一个值得深入研究的技术范本——无论你是想直接调用 API 解决实际问题,还是想研究 MoE + MLA 的底层实现,DeepSeek-V2 都值得你花时间了解。
