DeepSeek-OCR
deepseek-ai/DeepSeek-OCR加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
你正在用 Claude 撰写一份万字长文,它突然"失忆"了——不是因为上下文窗口不够,而是因为注意力机制的计算成本随序列长度呈二次方增长。处理 10,000 字的对话历史,其计算量是 1,000 字的整整 100 倍。这是现代大模型的核心瓶颈之一。
DeepSeek-OCR 给出了一个出人意料的答案:为什么非要把文字当文字处理?把它渲染成一张图,让模型去"看"不就行了?
这就是 DeepSeek-OCR 的核心洞察——光学压缩(Optical Compression)。它将文本渲染为高分辨率 2D 图像,通过一个专门的视觉编码器压缩为极少的"视觉 token",再由大语言模型解码还原。整个过程不需要消耗二次方增长的注意力计算,只需利用 VLM 架构中本就存在的视觉编码器。
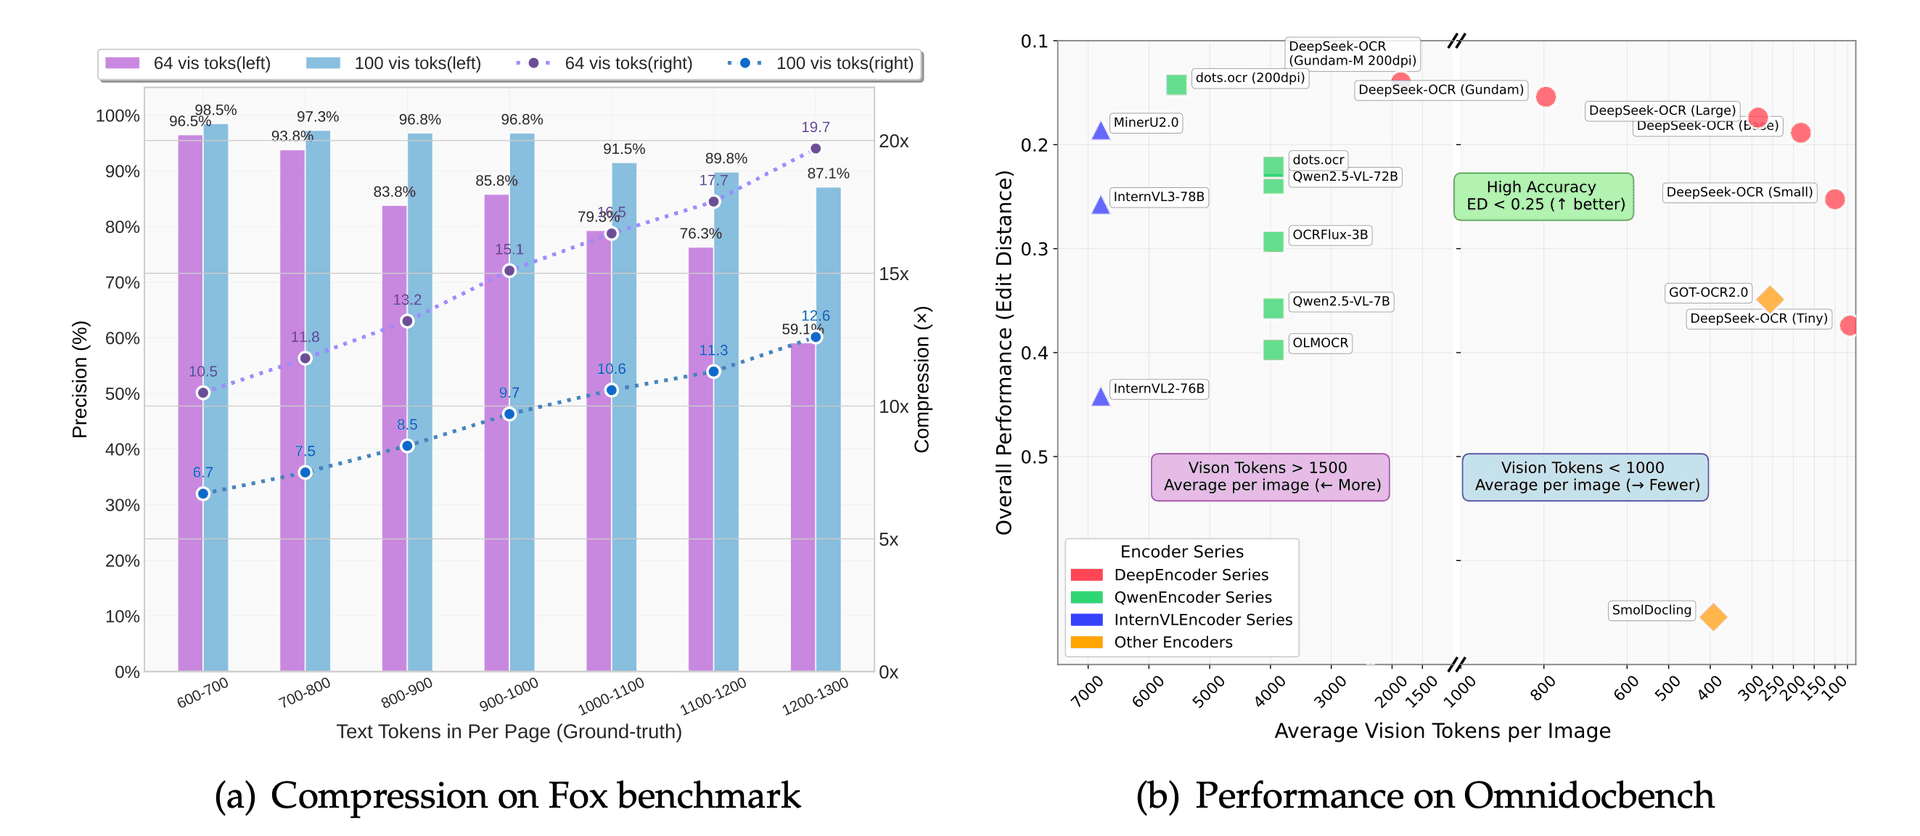
图:DeepSeek-OCR 的核心思想——将文本压缩为视觉 token,再用 LLM 解压
2025 年 10 月 21 日,DeepSeek 团队发布了 DeepSeek-OCR,这是继 DeepSeek-VL 系列之后,他们在多模态领域的又一次重要探索。
论文通讯作者魏浩冉来自中国科学院,团队此前在 OCR 领域已有深厚积累——他们开发了 GOT-OCR2.0 和 Vary 等业界知名的视觉模型。
DeepSeek-OCR 的立项动机有两层:
理论层面:探索视觉模态能否成为文本的"高效压缩介质",即用远比传统 token 更少的方式存储文本语义信息
工程层面:构建一个真正能用的 OCR 工具,超越现有开源方案的性能
2025 年 10 月 23 日,vLLM 官方宣布在 upstream 中支持 DeepSeek-OCR,使其获得了生产级推理性能保障。
想象你有一本 500 页的书,需要存入一个只能放 50 张图片的空间。你把每 10 页书的内容缩印到一张图上,共 50 张"缩略图"。当你需要阅读某页时,把对应的缩略图放大"看"——DeepSeek-OCR 就是这样一个系统,只不过"放大还原"的工作由 AI 模型完成。
DeepSeek-OCR 的压缩比实验数据:
| 压缩比 | OCR 解码精度 | 实际意义 |
|--------|-------------|----------|
| 9-10x | 96-97% | 接近无损压缩 |
| 10-12x | ~90% | 轻度有损 |
| 20x | ~60% | 中度有损,作者称其为"遗忘机制" |
这意味着:当文本量是视觉 token 量的 10 倍以内时,模型能以 97% 的精度还原原文。即使压缩到 20 倍,仍能保留 60% 的内容——这为 LLM 的"长期记忆"压缩提供了理论依据。
DeepSeek-OCR 由两个核心组件构成:
DeepEncoder 是整个系统的创新核心,包含三个级联阶段:
第一阶段:窗口注意力(SAM)
高分辨率文档图像(如 1024×1024)首先进入 Meta 的 SAM(Segment Anything Model)进行局部感知。SAM 仅使用窗口注意力(Window Attention),可以处理大量初始 patch token(如 4096 个),但不会引发全局注意力的二次方内存爆炸。
第二阶段:16x 卷积压缩
SAM 输出的 4096 个 token 通过一个简单的 2 层卷积模块,执行 16 倍空间下采样,压缩至仅 256 个 token。这是最关键的"光学压缩"步骤——一个硬性的信息瓶颈。
第三阶段:全局注意力(CLIP)
仅剩的 256 个 token 才进入 OpenAI 的 CLIP-Large 模型,进行稠密的全局注意力推理。因为 token 数量已被大幅削减,这一计算密集步骤变得完全可控。
DeepEncoder 本身含约 3.8 亿参数,结合 SAM(8000 万)和 CLIP(3 亿)的能力,通过串行混合注意力设计智能分离了任务:廉价局部注意力处理高带宽像素数据,卷积瓶颈强制压缩,昂贵全局注意力只在低带宽潜在表示上工作。
视觉 token 最终进入 DeepSeek3B-MoE-A570M(570 亿参数,活跃参数约 30 亿)作为解码器。它的任务是充当"解压仪"——将 256 个视觉 token 还原为原始的数千个文本 token。
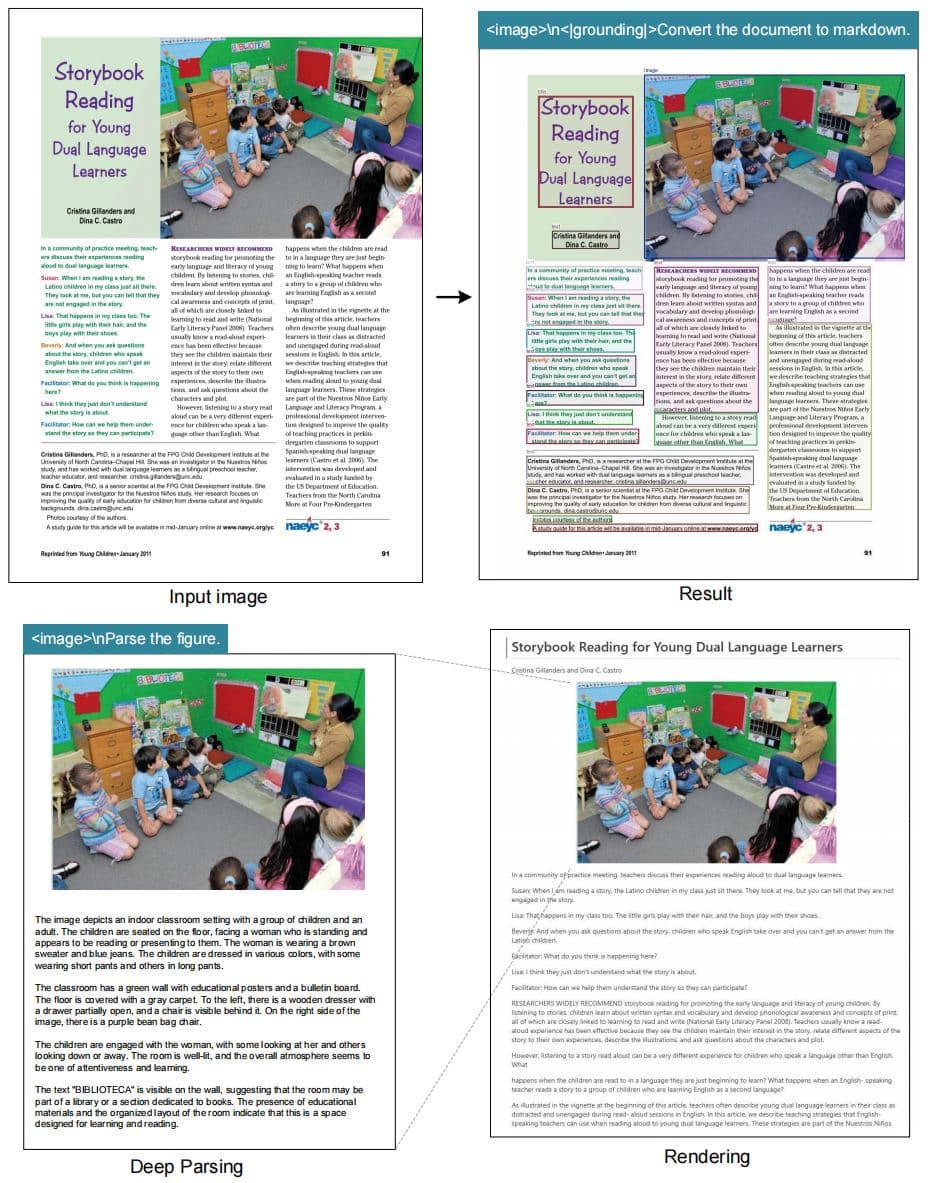
DeepSeek-OCR 在不同文档类型上的处理效果
DeepSeek-OCR 支持 6 种不同的分辨率模式,适用于不同复杂度的文档:
| 模式 | 输入分辨率 | Vision Tokens | 适用场景 |
|------|-----------|--------------|---------|
| Tiny | 512×512 | 64 | 简单幻灯片 |
| Small | 640×640 | 100 | 书籍、报告 |
| Base | 1024×1024 | 256 | 复杂排版文档 |
| Large | 1280×1280 | 400 | 高精度需求 |
| Gundam | n×640 + 1×1024 | <800 | 报纸、长文档 |
| Gundam-Master | 超高分辨率拼接 | <1000 | 极端复杂文档 |
DeepSeek-OCR 在 OmniDocBench(业界权威文档解析基准)上展示了惊人的 token 效率:
| 模型 | Vision Tokens/页 | 性能对比 |
|------|-----------------|---------|
| GOT-OCR2.0 | 256 | 基准 |
| DeepSeek-OCR (Small) | 100 | 超越 GOT-OCR2.0 |
| MinerU2.0 | 6000+ | 基准 |
| DeepSeek-OCR (Gundam) | <800 | 超越 MinerU2.0 |
用不到 MinerU 1/8 的 token 数量取得更好效果,这一数据充分说明了 DeepEncoder 架构的高效性。
此外,DeepSeek-OCR 还支持多语言识别(约 100 种语言)、图表深度解析(转 Markdown/Graph)、化学公式、几何图形等高级功能,扩展了其作为数据生产工具的实用性。
vLLM 路径支持异步批量推理,性能最优(单卡 A100-40G 吞吐量约 2500 tokens/s):
from vllm import LLM, SamplingParams
from vllm.model_executor.models.deepseek_ocr import NGramPerReqLogitsProcessor
from PIL import Image

llm = LLM(

    model="deepseek-ai/DeepSeek-OCR",

    enable_prefix_caching=False,

    mm_processor_cache_gb=0,

    logits_processors=[NGramPerReqLogitsProcessor]

)


model_input = [

    {"prompt": "<image>
Free OCR.", "multi_modal_data": {"image": Image.open("doc1.png").convert("RGB")}},

    {"prompt": "<image>
Free OCR.", "multi_modal_data": {"image": Image.open("doc2.png").convert("RGB")}}

]


sampling_param = SamplingParams(

    temperature=0.0, max_tokens=8192,

    extra_args=dict(ngram_size=30, window_size=90,

        whitelist_token_ids={128821, 128822}),

    skip_special_tokens=False
)


model_outputs = llm.generate(model_input, sampling_param)
for output in model_outputs:

    print(output.outputs[0].text)
from transformers import AutoModel, AutoTokenizer
import torch

model = AutoModel.from_pretrained(

    "deepseek-ai/DeepSeek-OCR",

    _attn_implementation='flash_attention_2',

    trust_remote_code=True, use_safetensors=True
).eval().cuda().to(torch.bfloat16)


tokenizer = AutoTokenizer.from_pretrained("deepseek-ai/DeepSeek-OCR", trust_remote_code=True)


res = model.infer(

    tokenizer,

    prompt="<image>

<|grounding|>Convert the document to markdown.",

    image_file="your_image.jpg",

    output_path="output/",

    base_size=1024, image_size=640,

    crop_mode=True, save_results=True, test_compress=True
)
官方推荐环境为 CUDA 11.8 + PyTorch 2.6.0,不支持 CUDA 12.x。硬件需求至少一块 NVIDIA A100(40GB)——这是一个明确的门槛要求。
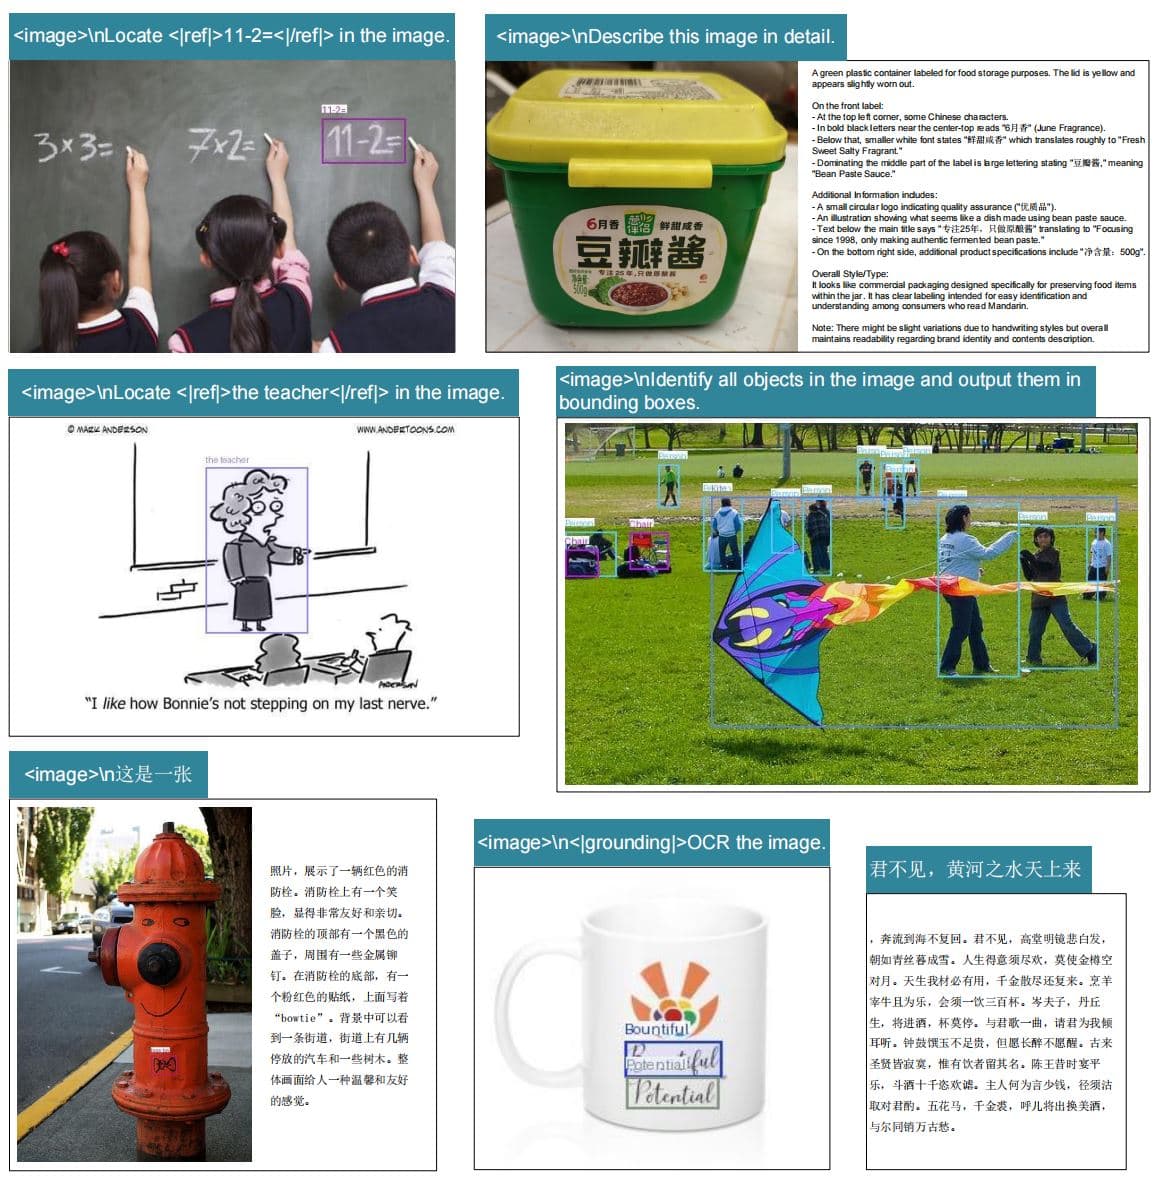
DeepSeek-OCR 对 PDF 文档的流式处理
DeepSeek-OCR 不是没有弱点:
1. 架构描述不够透明
论文对 DeepEncoder 的描述停留在高层,缺乏具体层数、激活函数、token 压缩机制细节。Pith 审稿指出这一问题后,作者承诺在修订版中补充。
2. 实验数据缺乏细节
压缩比实验没有给出完整的 Error Bar、数据集描述和逐类别分解。在实际评测中,表格、多列布局、非标准字体的处理效果仍有待独立验证。
3. 仅限 OCR,不验证真正的长上下文压缩
论文标题暗示这是"Long-Context Compression"的解决方案,但目前只做了 OCR 任务验证。真正的 Needle-in-a-haystack 测试(大海捞针)还未进行,数字-光学文本交织预训练也尚未实现。
4. 硬件门槛较高
40GB VRAM 的要求使个人开发者难以在消费级显卡上使用,降低了普及性。
DeepSeek-OCR 的核心价值不只是 OCR 本身,而在于验证了视觉作为文本压缩介质的可行性:
LLM 长期记忆压缩:将多轮对话历史渲染为图像压缩存储,10 倍压缩下 97% 精度意味着 AI 可以"记住"更多历史而不显著增加计算成本
训练数据生产:单卡 A100-40G 每天可处理 20 万页文档,20 节点集群每天 3300 万页——这是构建大规模预训练数据集的利器
VLM token 分配优化:为多模态系统的 token 预算分配提供了定量参考
2026 年 1 月 27 日,DeepSeek 发布了 DeepSeek-OCR2,进一步扩展了这一方向的能力边界。
DeepSeek-OCR 是一个兼具理论野心和工程价值的项目。它用 OCR 作为切入点,系统地探索了视觉模态能否成为文本的"光学压缩器"。实验数据表明,在 10 倍压缩比下可以达到 97% 的解码精度,在 OmniDocBench 上以不到 MinerU 1/8 的 token 量超越后者。这些结果为 LLM 的长期记忆压缩和训练数据高效生成指明了一条有前景的技术路线。
当然,这仍是一个初步探索:完整的架构细节尚未公开,长上下文"大海捞针"测试也未完成。但作为一个开源可用的 OCR 工具,DeepSeek-OCR 本身就足够有价值——它提供了两种成熟的推理路径(vLLM / Transformers),有完整的文档和示例代码,适合有 GPU 资源的团队用于文档数字化和训练数据生产。