
DeepInfer
deepseek-ai/DeepInfer加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下:你打开 DeepSeek 的对话框,问它一个问题,屏幕上的字一个个往外蹦。你可能以为这背后只是"模型很聪明",但真正决定这条消息花你几毛钱、服务器烧多少度电的,是中间那层你从来看不见的东西——推理框架。
2026 年 10 月 20 日下午,DeepSeek 官方账号发了一串公告:把内部生产环境使用的推理框架 DeepInfer 全面开源了。同批开源的还有生产级 Token 编解码组件 deepseek-recipe,以及一份把集群架构、并行策略、缓存设计讲得极其彻底的部署 Q&A 文档。
这不是"又开源了一个模型"。DeepSeek 已经开源过模型权重、TileLang 编译工具、FlashMLA / DeepGEMM / DeepEP 等一堆算子库。这次动的是更靠上的一层——推理引擎本身。
用官方自己的话讲:大模型的能力边界由模型本身划定,但如何以合理成本提供超大规模的模型服务,取决于一个长期未被公众了解的中间层——推理框架。训练让模型"学有所成",推理让模型"为人所用"。
DeepInfer 正是撑起 DeepSeek-V4.1-Flash 大规模服务的那套生产栈。官方披露的数据颇为惊人:单个集群每天服务 155 万亿 token,谷时定价下折算每 GPU 小时收入 38 美元。这个数字背后,就是 DeepInfer 的调度效率。
类比一下:模型权重相当于食材,推理框架相当于后厨。后厨决定了同样一公斤食材能做出多少道菜、每道菜上桌多快。绝大多数开源社区能拿到"食材"(模型权重),但后厨一直是黑盒。DeepSeek 这次把后厨的图纸和一部分设备公开了。
从仓库和官方 Q&A 看,DeepInfer 不是一个通用推理框架,而是一套针对 DeepSeek 系模型的深度定制高性能引擎。
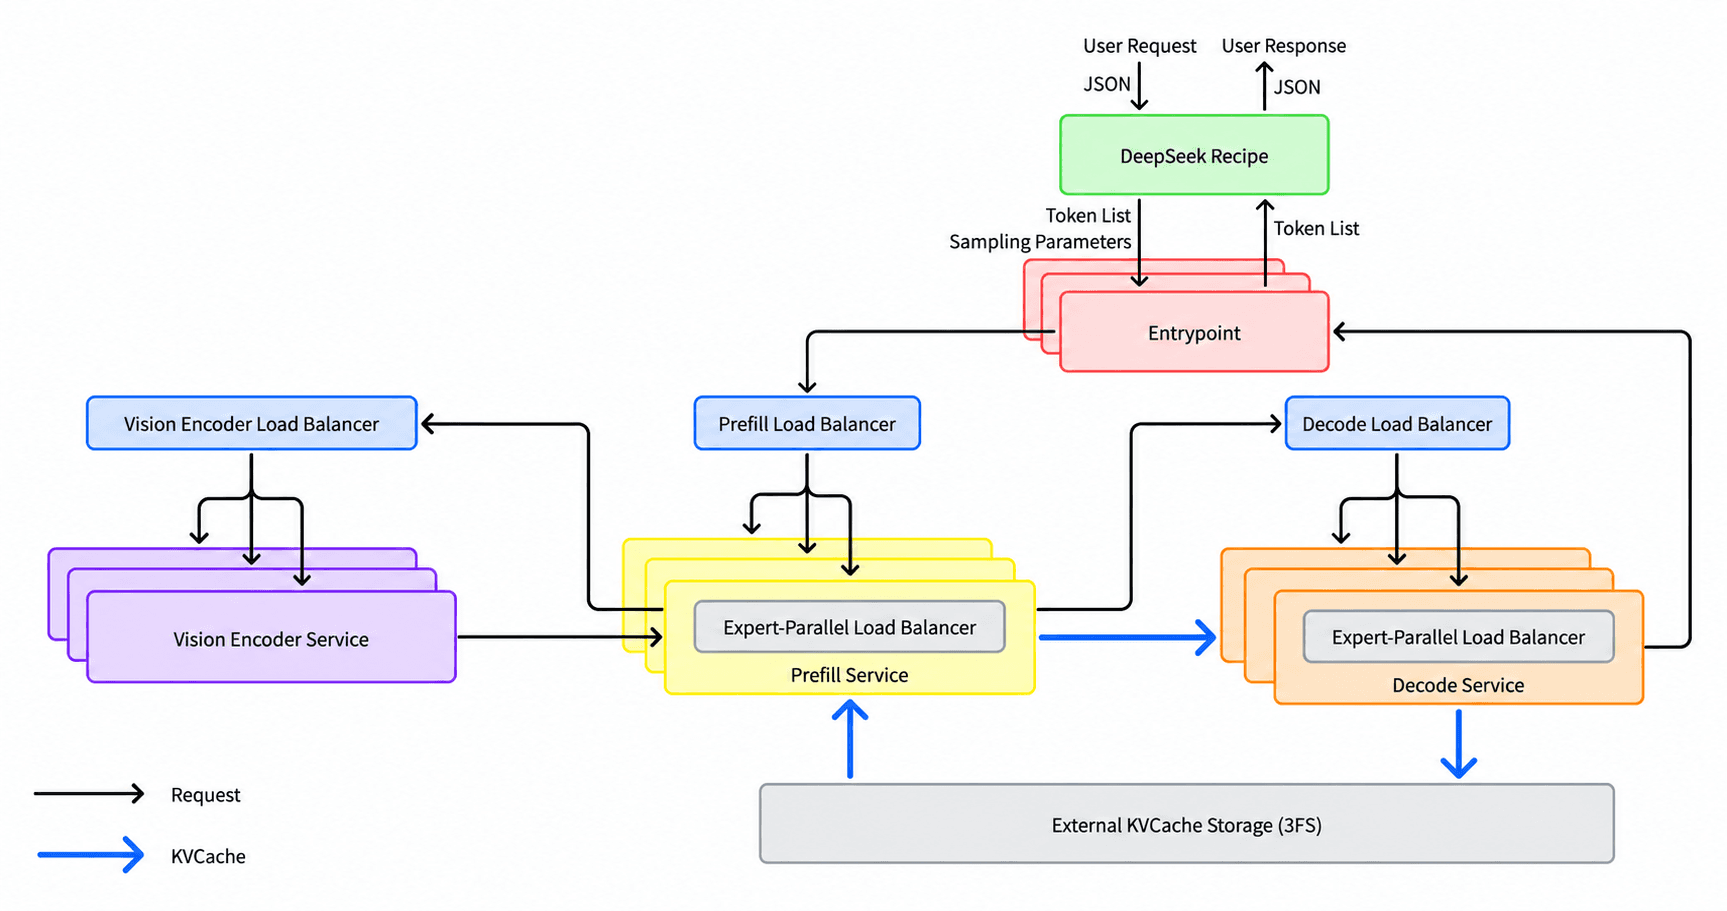
图:DeepSeek V4.1 Flash 推理系统参考架构——E/P/D 分离部署 + 专属 KV Cache 存储节点
并行策略是它的第一张牌。 官方架构采用 E/P/D(Vision Encoder / Prefill / Decode)分离部署,加上专属存储节点。Prefill 侧用 EP2–8 / DP2–8,Decode 侧用 EP64–128 的 Wide-EP,TP 和 CP 暂不使用。Wide-EP 的作用是大幅削减 MoE 专家部分的每步显存搬运量,官方实测 EP64 相比 EP8 有明显吞吐提升。
专家负载均衡(EPLB)是第二张牌。 每张 GPU 除负责的专家外,还冗余托管若干热门专家副本;收集最近 N 步的专家负载统计,每 M 步重新分配一次,权重通过 NVLink symm_mem 在组内洗牌。Prefill 侧从每 GPU 4 个冗余专家起步、100 步窗口、1000 步重分配一次,测得 moe_lb(最慢 rank / 均值)约 1.045–1.074;Decode 侧从 1 个冗余起步、1000 步窗口、10000 步重分配,moe_lb 约 1.090。
内核族是第三张牌。 官方集成并链接了自研的 FlashMLA、DeepGEMM、DeepEP、TileKernels、DeepSelect,以及大量用 TileLang 编写、放在 deepinfer/model_executor/layers/tilelang_ops 下的自定义内核。
几项较新的工程特性:
DEEPINFER_ENABLE_MTP_VARLEN=1 开启,DEEPINFER_USE_NEXTN_DECODE 控制最大草稿长度(默认 5)。KEEP_TOKENS=140。DEEPINFER_BATCH_INVARIANT=1 后,相同输入在不同批次组成下结果保持一致(仅 NVIDIA)。seq_seed,相同 token 与采样参数产出完全一致的输出。so_args 以正则、JSON Schema 或 EBNF 文法约束生成。代码规模不小:Python 约 234 万字节、C++ 约 27.8 万字节、Shell 约 9KB,主体是 Python 与 C++ 混合。
deepinfer/
├── engine/            # LLMEngine 主编排、参数解析、性能剖析
├── worker/            # 模型执行、CUDA Graph runner、缓存引擎
├── model_executor/    # 模型加载、eplb、并行工具、层实现
├── ve/                # 视觉编码器(多模态)
├── structure_output/  # 结构化输出编译与匹配
├── distributed/       # 共享内存广播
└── csrc/              # C++/CUDA/NPU 扩展源码
后端抽象做得比较干净:setup.py 里根据 DEEPINFER_ACCELERATOR 环境变量在 CUDAExtension 与 NpuExtension 之间切换,csrc/asc_utils.cpp 与 csrc/cuda_utils.cpp 分列两侧,架构探测放在 deep_cluster/hardware。这让"一套代码跑英伟达和昇腾"在源码层面是真的成立,而不是口号。
工程规范上:ruff 严格 lint(启用 pyupgrade、flake8-bugbear、flake8-simplify、isort、类型标注检查)、line-length 140、pytest 配了 ci / ci_npu / gpu / benchmark / long_context 五类 marker,C++ 侧有 .clang-format。
必须说清楚现实边界。
硬件门槛是硬性的。 官方支持范围只有两类:NVIDIA SM100(Blackwell) 和 华为昇腾 950 NPU。你手上的 H100 / A100 / 4090 都不在支持列表内。README 明确要求 Linux、GCC ≥ 13.0、Python 3.12、NVIDIA 侧需 CUDA 13、昇腾侧需 CANN 9.2。
部署形态只有离线推理。 官方写得很直白:完整的线上推理服务还需要 KV cache 系统、VE/Prefill/Decode 分离的外围、以及跨数据并行副本的负载均衡——这些"与内部基础设施耦合较深"的代码暂未完整开源。README 也强调,撑起生产服务所需的 KV Cache 与分离部署能力"本仓库不包含"。
最小有效单元是 64+64 GPU。 官方建议 Prefill 用普通 8 卡机、Decode 用 64–128 卡 supernode,P/D GPU 配比约 1:1,最小高效部署单元是 64 卡 prefill + 64 卡 decode。存储侧推荐每台 KV cache 服务器 20 块 30.73TB SSD、至少 40GB/s 读、5GB/s 写,集群逻辑容量约每 GPU 14.4TB。跨数据中心部署 P/D 技术上可行,每 8 卡需预留约 400Gbps 互联带宽。
构建流程也不轻松。 ./build.sh 会先按加速器装依赖(NVIDIA 侧强制 nvidia-nccl-cu13==2.32.3),再编译 vendored 依赖,再编译本体 C++ 扩展,需要 conda 或 venv 环境。
没有容器化。 仓库根目录没有 Dockerfile、没有 docker-compose、没有 k8s manifest,全是源码构建。
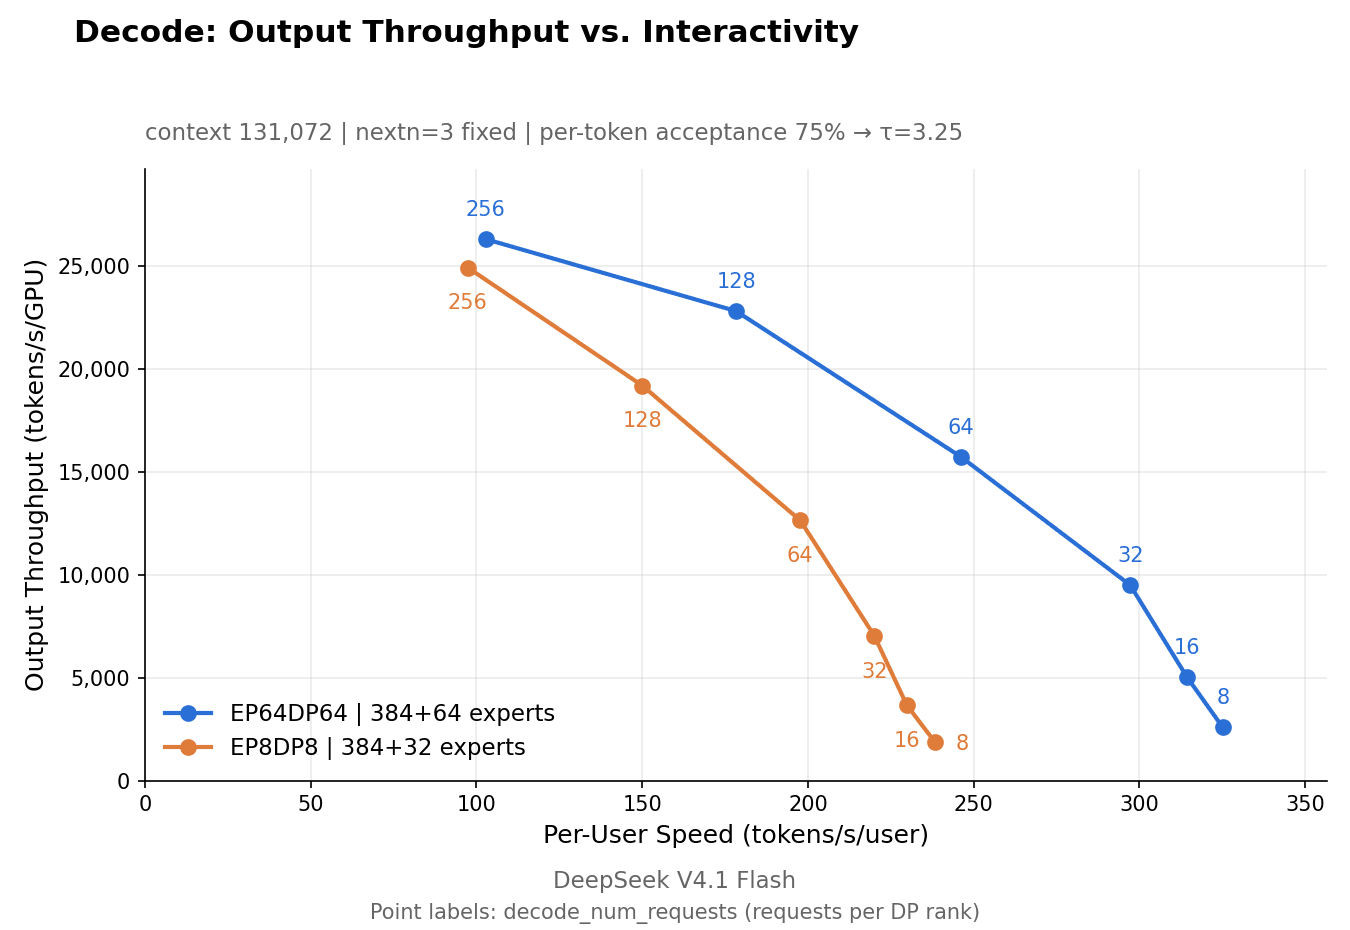
图:Wide-EP 对解码吞吐的增益——EP64 相比 EP8 大幅降低 MoE 专家部分的每步显存搬运量
所以实际结论是:个人开发者、小团队、以及没有 Blackwell 或昇腾集群的用户,现阶段仍然应该选 vLLM 或 SGLang。DeepInfer 的价值在于——给有高端集群、想大规模部署 V4.1-Flash 的厂商提供一份**"模型与引擎由同一团队设计能简化到什么程度"的参照实现**,同时给整个行业提供了第三方自部署"原汁原味"的可能性。
第一,开源的边界是刻意划的。 "Open models. Open kernels. Open inference." 这句口号很响,但 KV cache 存储与负载均衡这两块恰恰是最贴近生产核心、也最有商业价值的部分,没有开源。开源的是引擎的"骨架 + 内核",不是整套机房运维。
第二,支持面窄到极致。 只有一个模型(V4.1-Flash)、只有两种硬件、只有离线推理。对通用推理框架市场而言,这几乎不具备替代性。官方的表态是"未来 DeepSeek 新模型的推理代码及后续优化都将在 DeepInfer 持续更新"——但这个承诺需要时间验证。
第三,仓库历史极短。 GitHub 上总提交数仅 4 条,最后一次提交是 2026-10-21 的 DeepEP 版本升级。虽然代码质量(源自 vLLM 血统)不差,但社区协作、issue 处理、文档迭代的真实节奏还无从观察——开源不到两周的项目,成熟度需要更长周期的检验。
第四,评测口径需要谨慎解读。 官方基准的表述是"Prefill 在 4 张 SM100 上测,Decode 在 64 张 SM100 上测,每组落在同一个 scale-up 域内",并特意说明正文不抄具体 token/秒数字以免从图上误读——这种克制值得肯定,但也意味着横向对比数据缺失。
第五,环境变量开关的复杂度。 DEEPINFER_BATCH_INVARIANT、DEEPINFER_ENABLE_MTP_VARLEN、DEEPINFER_YOCO_PREFILL_TRUNCATION_MODE、DEEPINFER_USE_NEXTN_DECODE……相当多的行为开关散布在环境变量里,且部分特性仅 NVIDIA 可用,Ascend 用户需要逐项核对。
这次开源释放了一个值得整个行业注意的信号:开源大模型竞争的下一个战场,正在从参数规模和跑分,转向推理吞吐量、延迟、GPU 利用率、显存效率和单位服务成本。
过去开源模型社区比的是参数量、benchmark、推理能力、数学和编码。下一步会比的是工程账——同样的模型,你跑得更快更省,API 价格就能压得更低,服务也就能覆盖更多用户。
对 API 使用者来说,间接影响更实在。此前云厂商不太愿意大规模供给 DeepSeek 模型:权重虽然公开、可以自部署,但怎么调都做不到官方 API 的价格和服务质量。引擎加上与官方 API 对齐的 deepseek-recipe 编解码组件之后,第三方自部署第一次有底气宣称"行为一致",量化降智的顾虑被正面拆掉,中转站靠魔改引擎赚差价的模式承压。
对国产算力链来说,昇腾 950 出现在官方支持列表里,信号意义可能大于功能意义——这说明国产 NPU 集群已经可以承载头部厂商自己设计模型的完整推理栈。
examples/sweep/run_sweep.sh),照着做基线复现,再决定是否把 V4.1-Flash 自建进自己的服务栈。本文基于 deepseek-ai/DeepInfer 公开仓库(Apache-2.0)、官方部署 Q&A 文档与公开报道整理分析,数据截至 2026-10-22。
