
AI-Resume-Analyzer
deepakpadhi986/AI-Resume-Analyzer加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
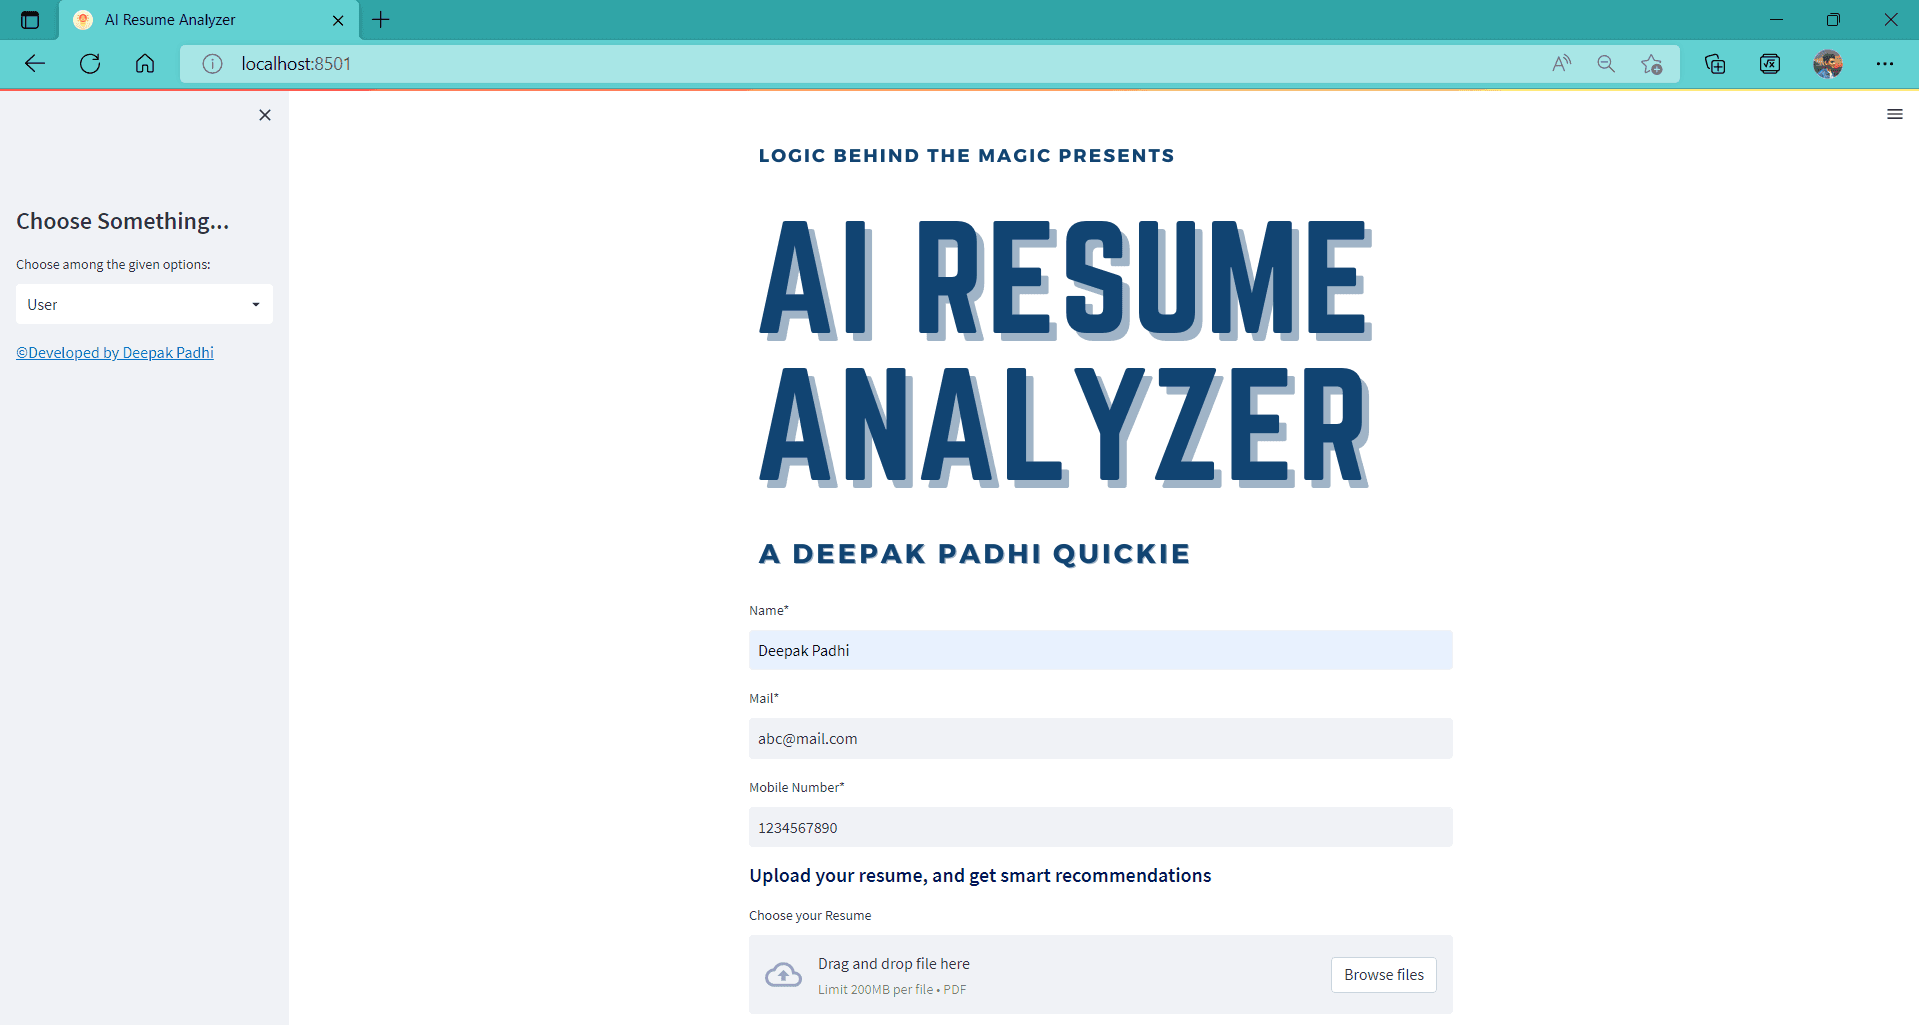
图:Streamlit 客户端主界面,上传 PDF 后即时给出分析结果
想象这样一个场景:应届生小李投了 60 份简历,收到 2 个面试邀请。他反复修改,排版越来越花哨,却始终不知道自己到底缺什么。HR 打开他的简历,平均停留 7 秒,扫到「熟悉 Java/Python」就翻到下一页。
AI Resume Analyzer 试图做那台「会读简历的 HR 助手」:你丢进去一份 PDF,它解析出姓名、邮箱、技能、学历,抽取关键词,把技能归到数据科学 / Web / 安卓 / iOS / UI-UX 五个赛道,再按加分项打一个 0-100 的分数,最后告诉你「你缺 Kubernetes 和 CI/CD,简历里没有项目描述」。
项目作者 Deepak Padhi 在 Kirti 学院读 B.Sc CS 时把它作为 2022-23 学年毕业设计提交,2022 年 9 月开源,如今在 GitHub 上收获 920 star、256 fork,MIT 协议,最近一次提交在 2026 年 10 月 24 日——四年过去,仍在维护。
技术路径并不「AI」,但相当实用。
第一层:解析。 核心依赖 pyresparser + pdfminer3 做 PDF 文本抽取,spacy 2.3.5 的 en_core_web_sm 模型做实体识别(NLTK 停用词做清洗),拿到 name、email、mobile_number、degree、skills、no_of_pages 等结构化字段。作者还在仓库里自带了一份改过的 pyresparser/resume_parser.py,要求使用者覆盖掉 site-packages 里的原版——这是全项目最大的部署坑。
第二层:预测。 岗位赛道靠关键词匹配硬编码:技能列表里出现 tensorflow/pytorch/flask 就判为数据科学,命中 react/django/php 判为 Web,以此类推;经验等级则直接看 PDF 全文里有没有 INTERNSHIP / EXPERIENCE 字样,分成 Fresher / Intermediate / Experienced 三档。这套逻辑朴素但透明,命中即给出一整套推荐技能清单。
第三层:打分。 简历评分是一套加权规则:项目 19 分、经验 16 分、成就 13 分、教育 12 分、证书 12 分、技能 7 分、目标陈述 6 分、实习 6 分、兴趣 5 分、爱好 4 分,总分 100。
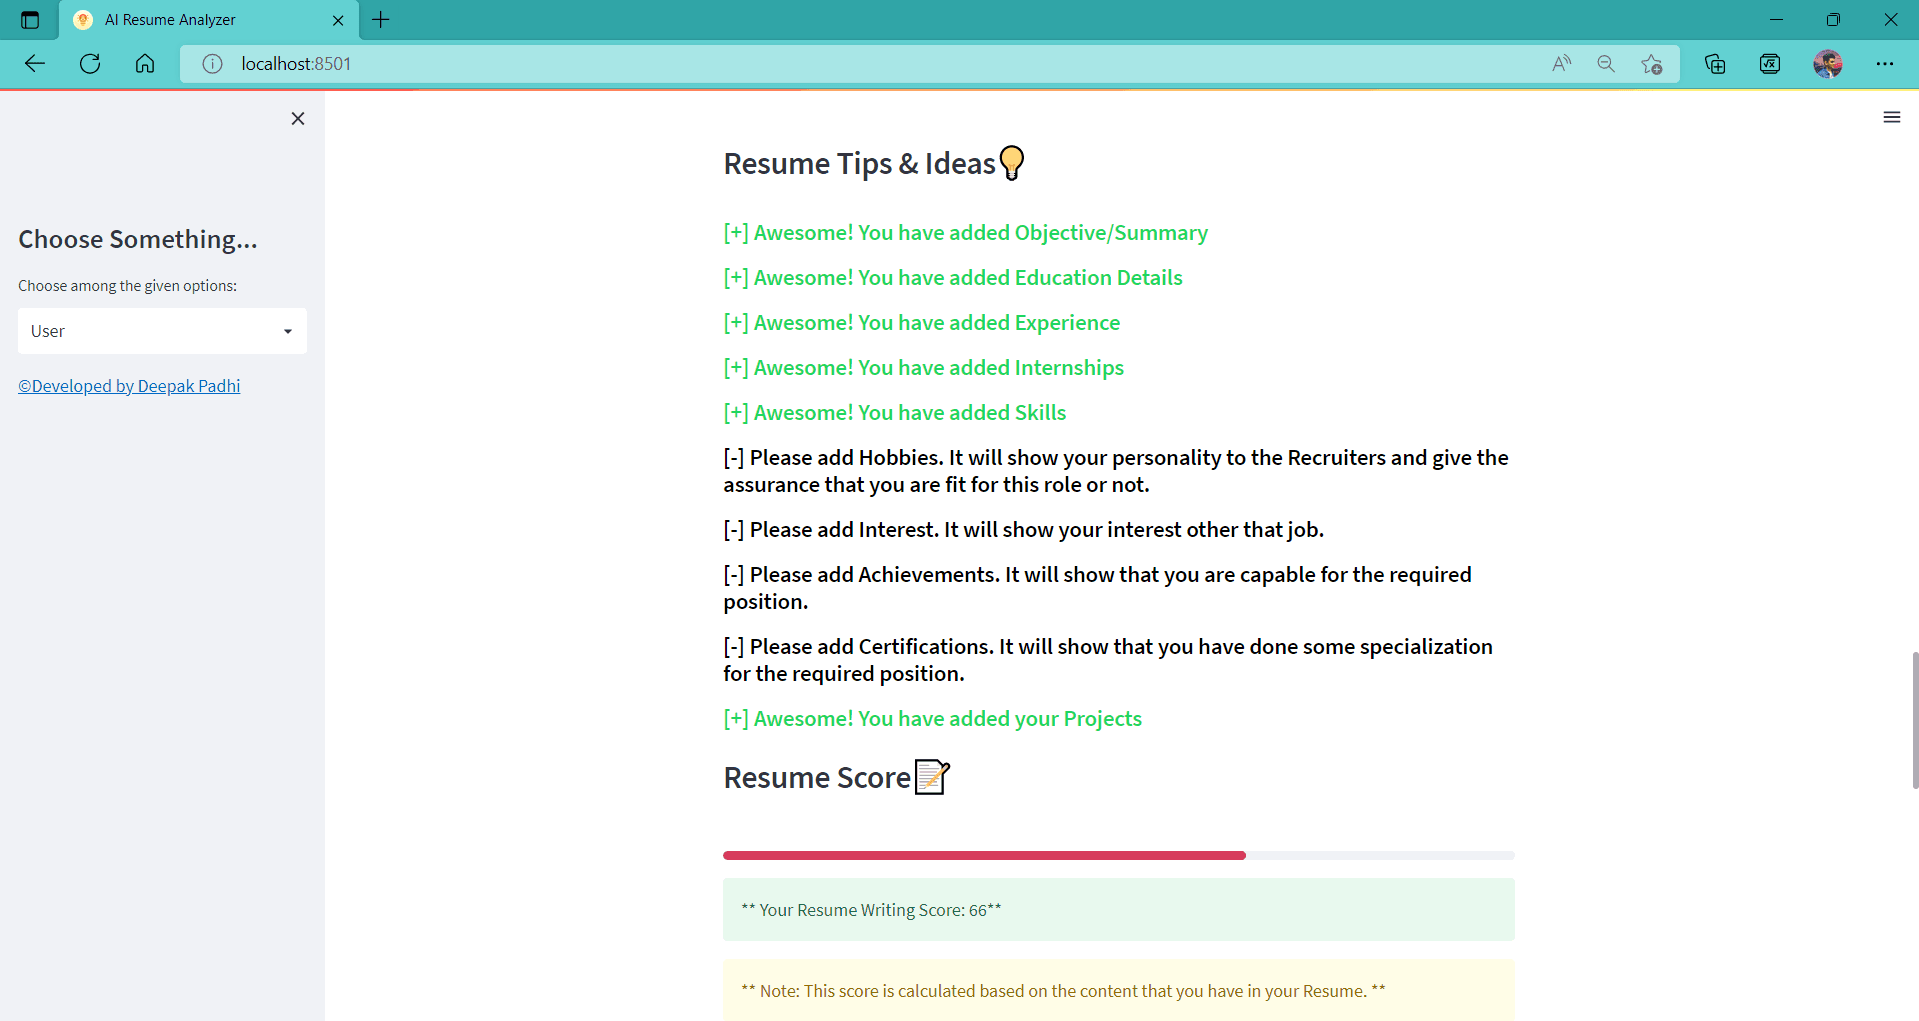
图:逐项命中/未命中的评分提示条与总分进度条
第四层:管理后台。 所有上传者的姓名、邮箱、IP、地理位置、预测岗位、经验等级、推荐技能、课程清单全部落库 MySQL,管理员可导出 CSV、查看七张分析饼图(评分分布、岗位分布、经验分布、用户数、城市、州、国家)。
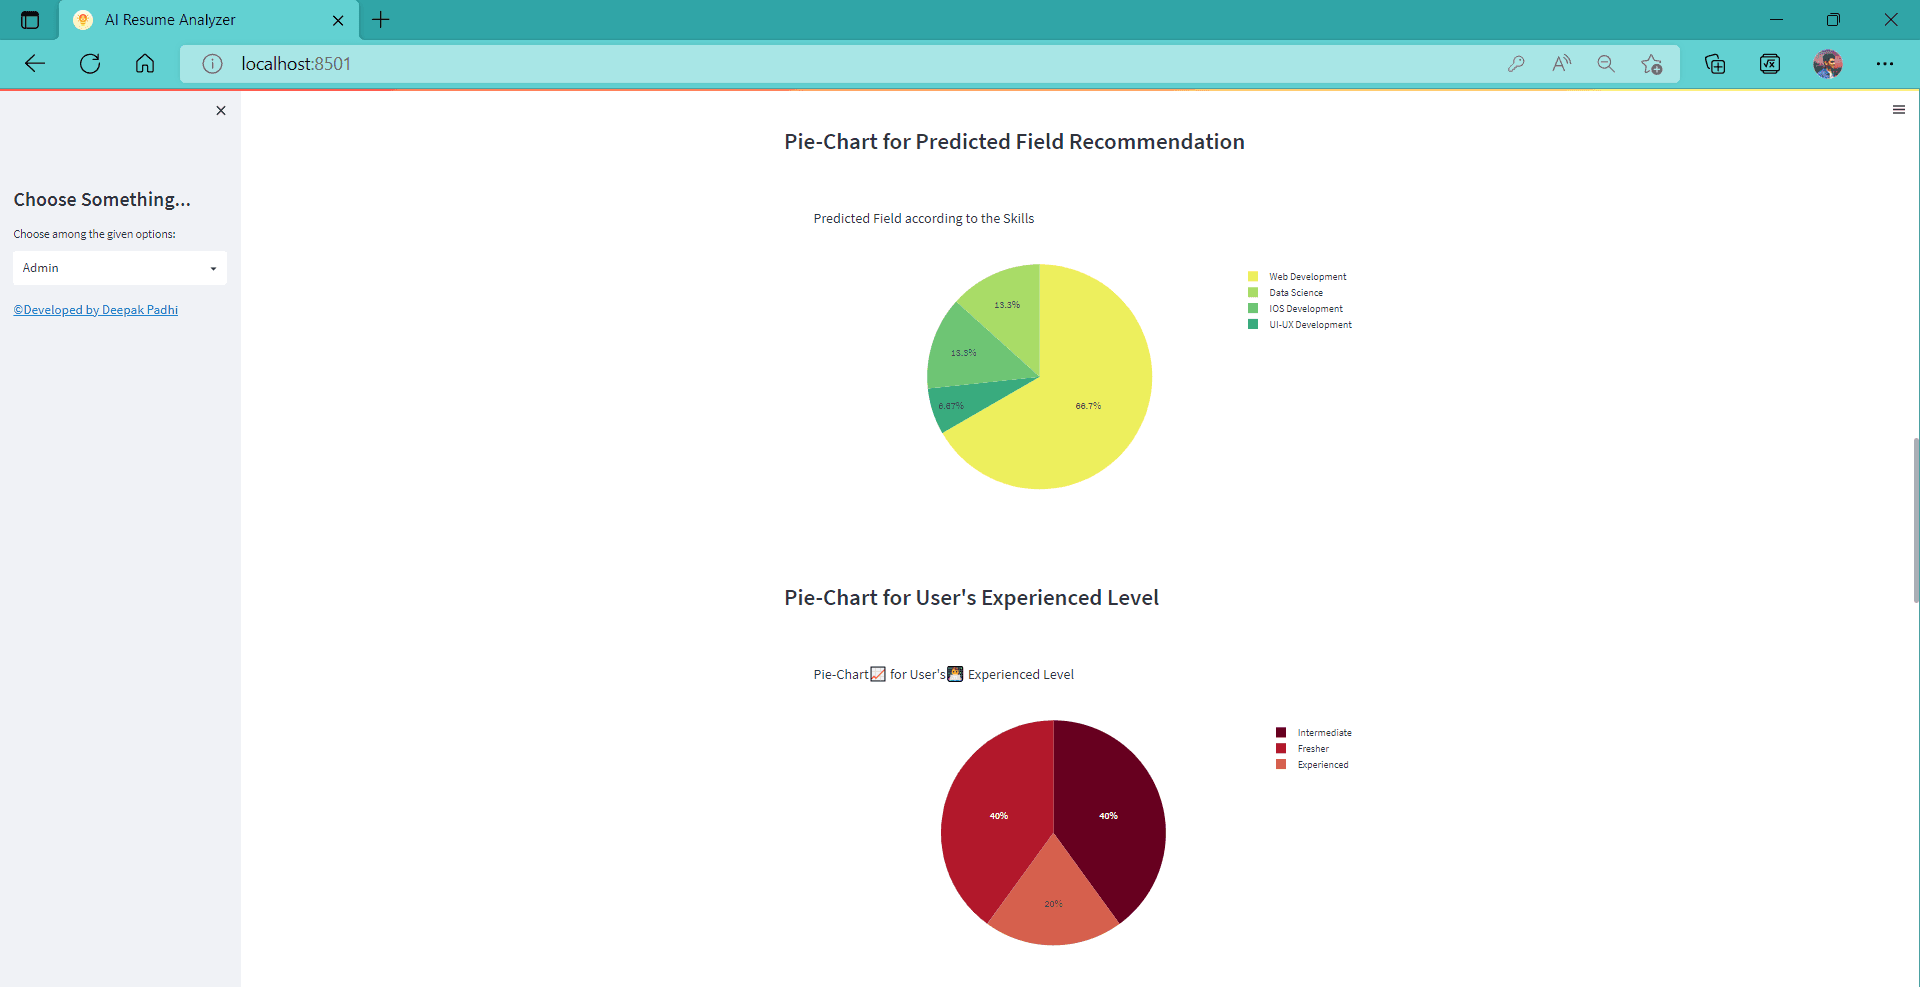
图:管理员端集群分析饼图
streamlit run App.py
真正难的是这条命令之前。仓库无 Dockerfile、无 docker-compose(社区 PR #20 提出添加 Dockerfile + Jenkins CI/CD,至今未合并)。使用者需要装 Python 3.9.12、MySQL 并手工创建 cv 库和两张表、装 Visual Studio Build Tools 供 spacy 2.3.5 / thinc 7.4.5 本地编译,再把 App.py 第 95 行的硬编码账号密码改掉。
更麻烦的是两处「时代遗留」:依赖里同时存在 pdfminer.six 与 pdfminer3(后者早已停止维护),以及代码直接调用 nltk.download('stopwords') 在导入时联网下载语料——内网或无外网环境会直接卡住或报错。此外 App.py 直接 pymysql.connect(host='localhost', user='root', password='root@MySQL4admin'),明文密码进版本库,部署前必须改掉。
诚实地讲,这个项目和当下主流的「AI 简历分析」有代差。
if 'Objective' or 'Summary' in resume_text: 这类写法永远为真——'Objective' 是非空字符串即真值,等于无论简历写没写都加 6 分。作者后续 PR #19 也只修了空行问题,未修这个逻辑 bug。多项分数因此存在虚高。App/Uploaded_Resumes/ 目录。用于企业内部场景前必须做脱敏。admin / admin@resume-analyzer 硬编码在 README 中;unsafe_allow_html=True 广泛用于渲染 PDF 内容,理论上存在注入面。不过它也有真实价值:作为教学项目,它把「PDF 抽取 → 关键词抽取 → 分类 → 评分 → 可视化」这条链路完整走通了一遍;对中文简历解析、ATS 适配排版这类方向,都是很好的起点参考。
2022 年做简历解析,主流方案还是规则 + 关键词;今天同一件事已经被大模型重做了一遍——把简历丢给 LLM,几秒给出结构化反馈、岗位匹配度甚至改写建议,ATS 排版优化也成了独立品类。AI Resume Analyzer 的 920 star 记录了那个「规则时代」的窗口期。
值得注意的是,它在 README 里挂了自己的商业产品 CVInsight 的推广链接和优惠码,作者已把这条路商业化。这类「学生毕设 → SaaS 化」的路径,正在成为开源项目变现的常见样本。
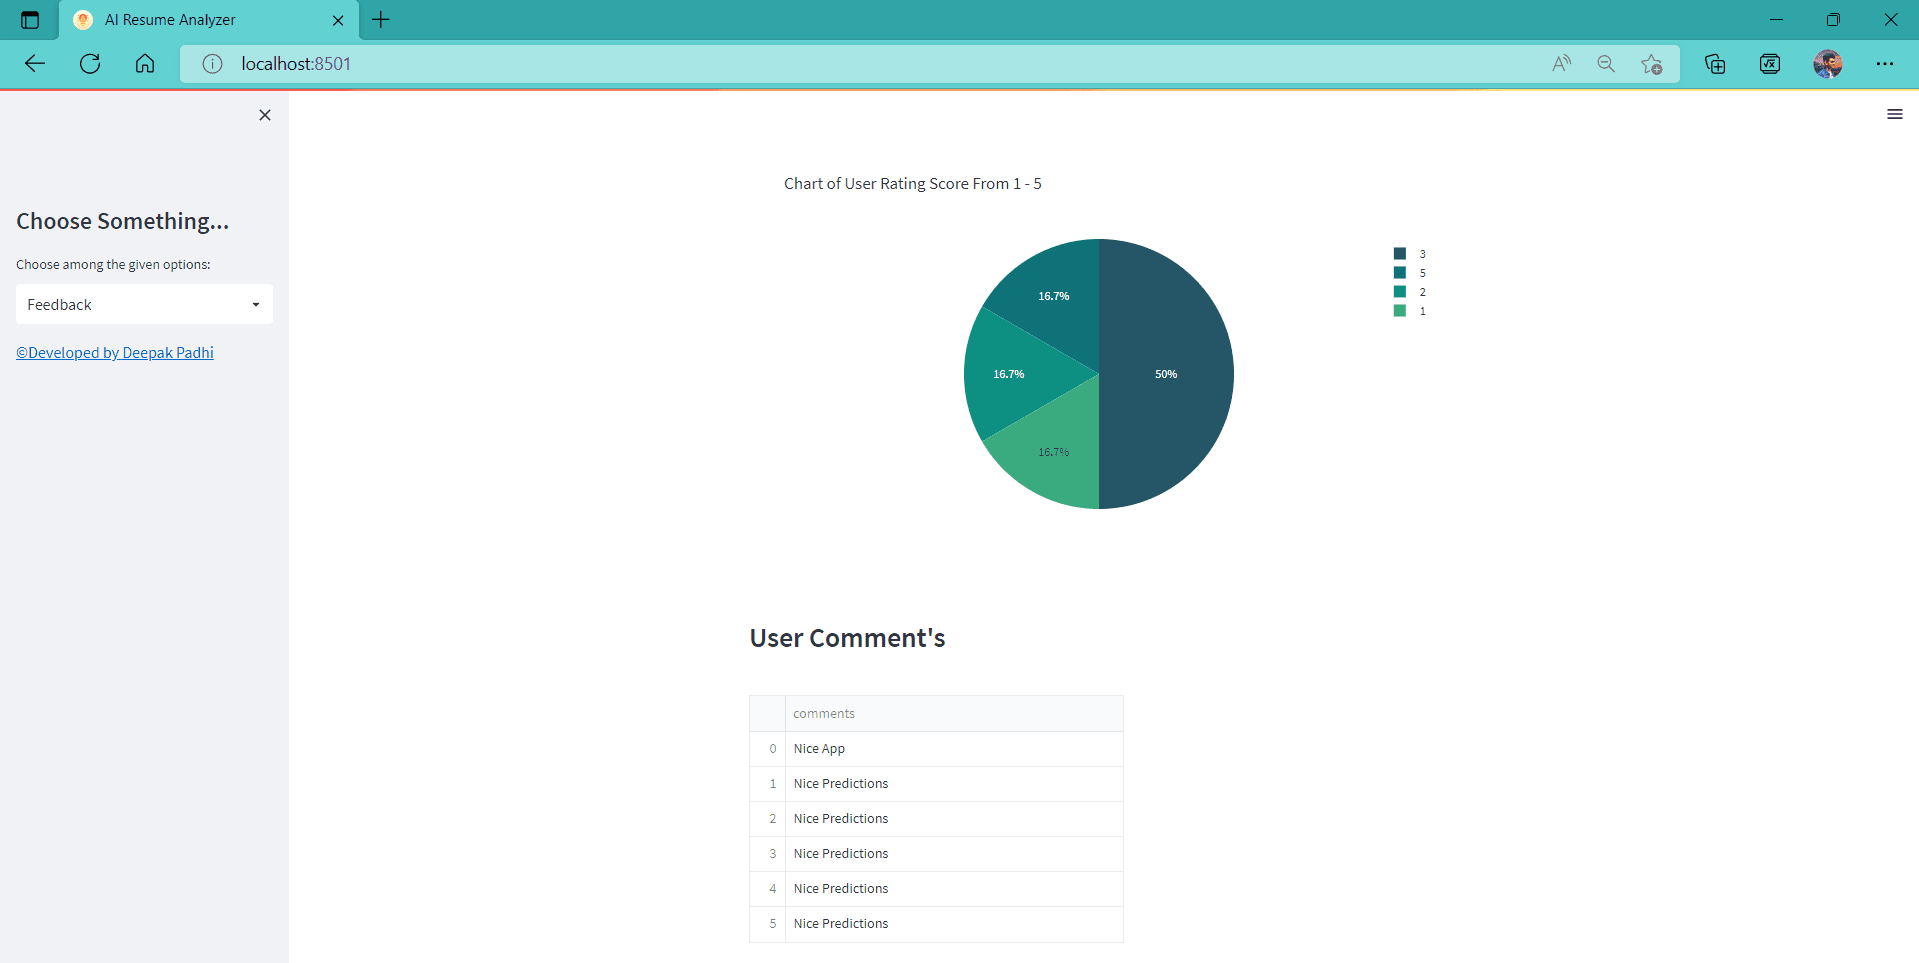
图:用户反馈评分与评论历史
结论:适合作为 Streamlit + NLP 教学参考、简历解析链路的原型验证,或用于二次开发改造;不适合直接作为生产级招聘筛选工具投入企业使用——需要重写依赖、重做评分逻辑、接入 LLM、清理隐私与安全缺陷后再评估。
| 项目 | 信息 |
|---|---|
| 仓库 | deepakpadhi986/AI-Resume-Analyzer |
| Star / Fork | 920 / 256 |
| 语言 | Python(100%) |
| 协议 | MIT |
| 提交数 | 40(单一贡献者) |
| 最后提交 | 2026-10-24 |
| 部署方式 | Streamlit 本地 + MySQL,无容器化 |
| 快速部署 | partially_supported |
