
Data-Pipelines-with-Airflow
ddgope/Data-Pipelines-with-Airflow加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2023年,上海某音乐流媒体公司的数据工程师李明(化名)遇到了一个典型困境:公司每日产生数GB的用户播放日志和歌曲元数据,这些数据分散存储在 Amazon S3 的 JSON 文件中,分析师每次取数都需要等上好几个小时。他的团队尝试用 cron 脚本来调度 ETL,但当数据量增长、重跑历史数据、甚至某天管道失败时,整个流程就陷入混乱——没有日志、没有监控、没有重试机制,一切靠手工维护。
李明花了两周时间,基于 Udacity 数据工程纳米学位的课程项目,搭建了一套基于 Apache Airflow 的自动化数据管道。所有 ETL 任务实现了可视化调度、历史回填、数据质量监控,工程师再也不需要凌晨爬起来手动触发任务。这个过程被整理后上传 GitHub,如今已成为许多中文数据工程师入门 Airflow 的参考项目。
这个项目就是 Data-Pipelines-with-Airflow。
在大数据时代,ETL(Extract-Extract-Transform-Load)不再是"写一个脚本跑一次"那么简单。现代数据仓库的 ETL 面临几个核心挑战:
Apache Airflow 是解决这些问题的行业标准工具。它以 DAG(有向无环图)的方式描述任务依赖关系,提供 Web UI 实时监控每一次执行历史,支持条件分支、并行执行、告警邮件等高级特性。
本项目的业务场景来自一个虚构的音乐流媒体公司 Sparkify。数据从两个来源进入系统:
log_data/ 路径下的 JSON 文件,记录用户播放行为(歌曲名、艺术家、播放时长、会员等级等)song_data/ 路径下的 JSON 文件,记录歌曲的基本信息项目构建了一个经典的 星型模式(Star Schema) 数据仓库,底层运行在 Amazon Redshift 上:
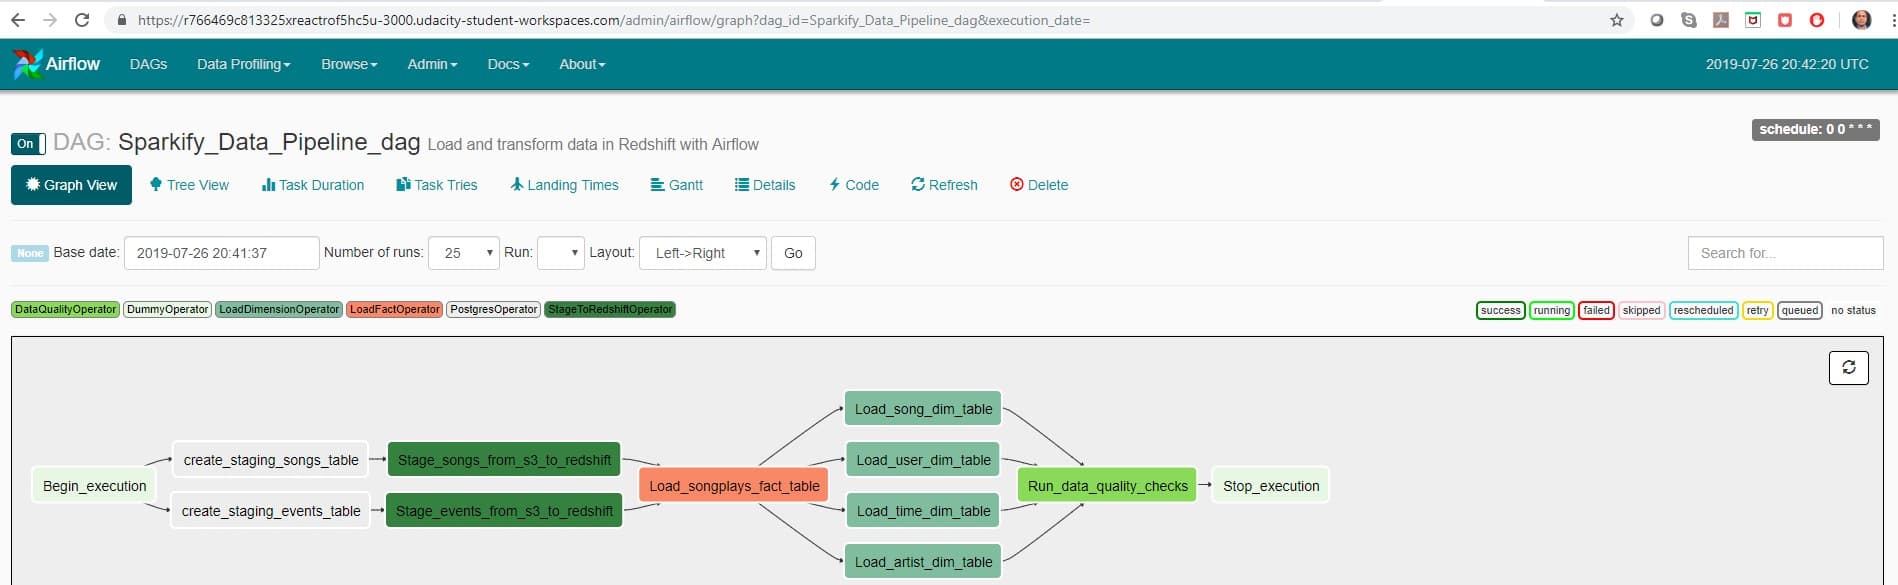
DAG 任务流:从数据加载到质量检查的完整链路
整个管道包含以下关键阶段:
1. Stage 层——数据加载
StageToRedshiftOperator:自定义 Airflow Operator,将 S3 中的 JSON 文件 COPY 到 Redshift 的 staging 表2. Fact 表——核心业务事实
LoadFactOperator:将 staging_events 与 staging_songs 通过 JOIN 生成 songplays 事实表3. Dimension 表——分析维度
LoadDimensionOperator:从 staging 表抽取用户维度(users)、歌曲维度(songs)、艺术家维度(artists)、时间维度(time)4. 数据质量检查
DataQualityOperator:在 ETL 最后执行数据质量校验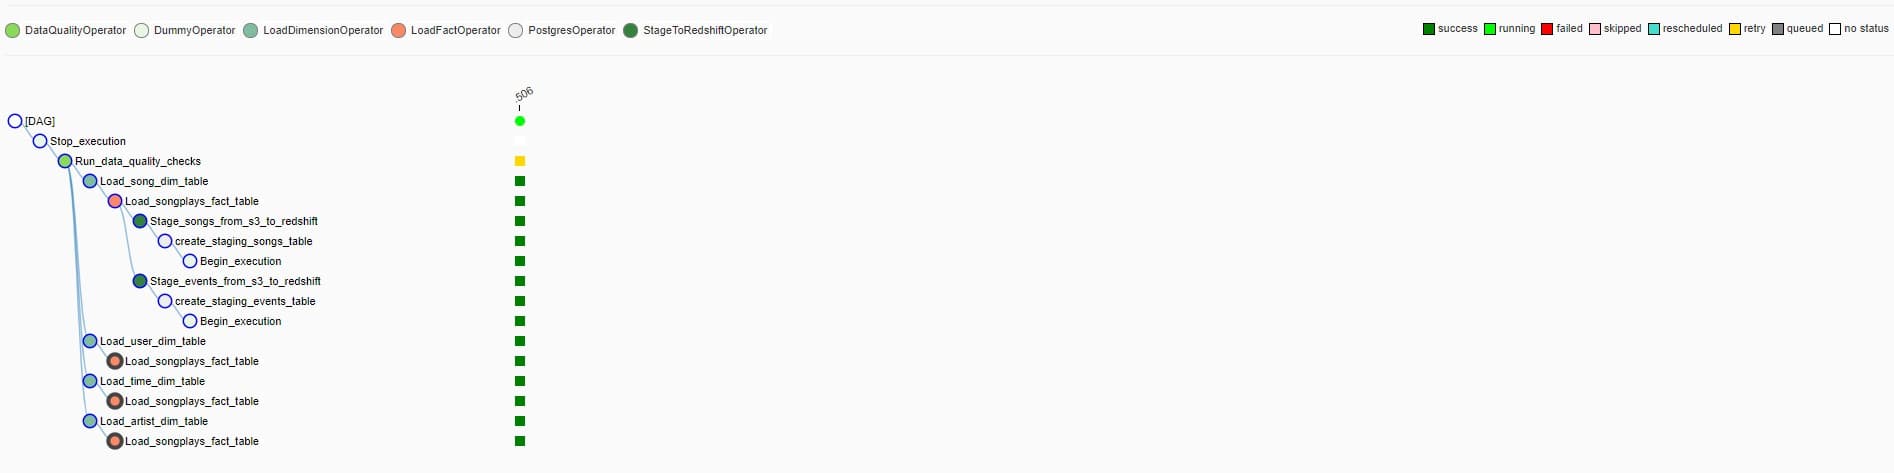
完整数据管道架构:S3 → Redshift Staging → Star Schema
项目在 plugins/operators/ 中实现了四个自定义 Operator,均继承自 BaseOperator:
AwsHook 获取临时凭证,支持 Jinja 模板化的 S3 路径参数化这种 "Operator 化" 的设计思路,使得 ETL 逻辑高度可复用,新任务只需配置参数而无需重写代码。
项目 README 总结了五条核心设计原则,每一条都直接体现在代码中:
start_date 和 DAG 的 schedule_interval='0 0 * * *' 实现每日分区主 DAG Sparkify_Data_Pipeline_dag 包含以下任务节点:
start_operator → create staging tables → stage events/songs →
create fact/dim tables → load fact → [load dim tables] →
data quality checks → end
DAG 每天午夜 0 点执行(schedule_interval='0 0 * * *'),覆盖前一天的日志数据。
| 层级 | 技术选型 |
|---|---|
| 调度框架 | Apache Airflow |
| 数据仓库 | Amazon Redshift |
| 对象存储 | Amazon S3 |
| 编程语言 | Python 3 |
| 数据格式 | JSON + SQL |
| 部署方式 | 手动安装 Airflow(无容器化) |
项目未提供 Dockerfile 或 docker-compose,需要手动安装 Apache Airflow 并配置以下连接:
redshift conn_id)aws_credentials conn_id)典型部署路径:
pip install apache-airflow$AIRFLOW_HOME部署过程中最大的挑战是 AWS 凭证和 Redshift 安全组配置,对于没有 AWS 账号的用户,需要额外搭建本地 PostgreSQL 来模拟环境。
AWS_KEY = os.environ.get('AWS_KEY') 形式的占位符,真实部署需要通过 Airflow Connection 安全管理凭证作为 2021 年提交的教育类项目,本仓库目前(2026年8月)获得 104 颗 GitHub Stars,规模属于中小型教育参考项目。它代表了数据工程领域从手动脚本调度向专业化 DAG 编排工具迁移的典型学习路径。
近年来,随着数据平台现代化的推进,Apache Airflow 已被广泛应用于以下场景:
本项目的设计思路——自定义 Operator、Star Schema 星型模型、数据质量检查——在当下的数据平台工程中仍然是主流实践。
Data-Pipelines-with-Airflow 是一个面向学习的实战级 ETL 管道项目,将 Apache Airflow 的核心概念(Sensors、Operators、DAGs、Connections)落地到真实业务场景中。虽然未提供容器化支持、代码规模不大,但对于想入门数据工程、理解生产级 ETL 设计原则的开发者来说,是一个值得研究的参考实现。
项目的核心价值不在于代码本身,而在于 ETL 设计原则的完整梳理——数据分区、增量加载、幂等性、参数化、数据质量检查,这五条原则至今仍是数据管道工程的黄金法则。
