
datahub
datahub-project/datahub加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
2024 到 2026 年,几乎每个团队都试过让 AI Agent 查公司数据、回答业务问题,然后撞上同一堵墙:Agent 不知道你的数据长什么样。它不知道"订单表"里 status 字段有 47 种取值,不知道报表和看板挂在哪些表上,也不知道某个指标的口径是哪个 ETL 脚本算出来的。
DataHub 的存在,就是把这堵墙拆掉。它不是又一个数据目录,而是 LinkedIn 在 2019 年开源的、现在服务 Netflix、Visa、Slack、Apple 等 3,000+ 家组织的上下文平台(Context Platform)。
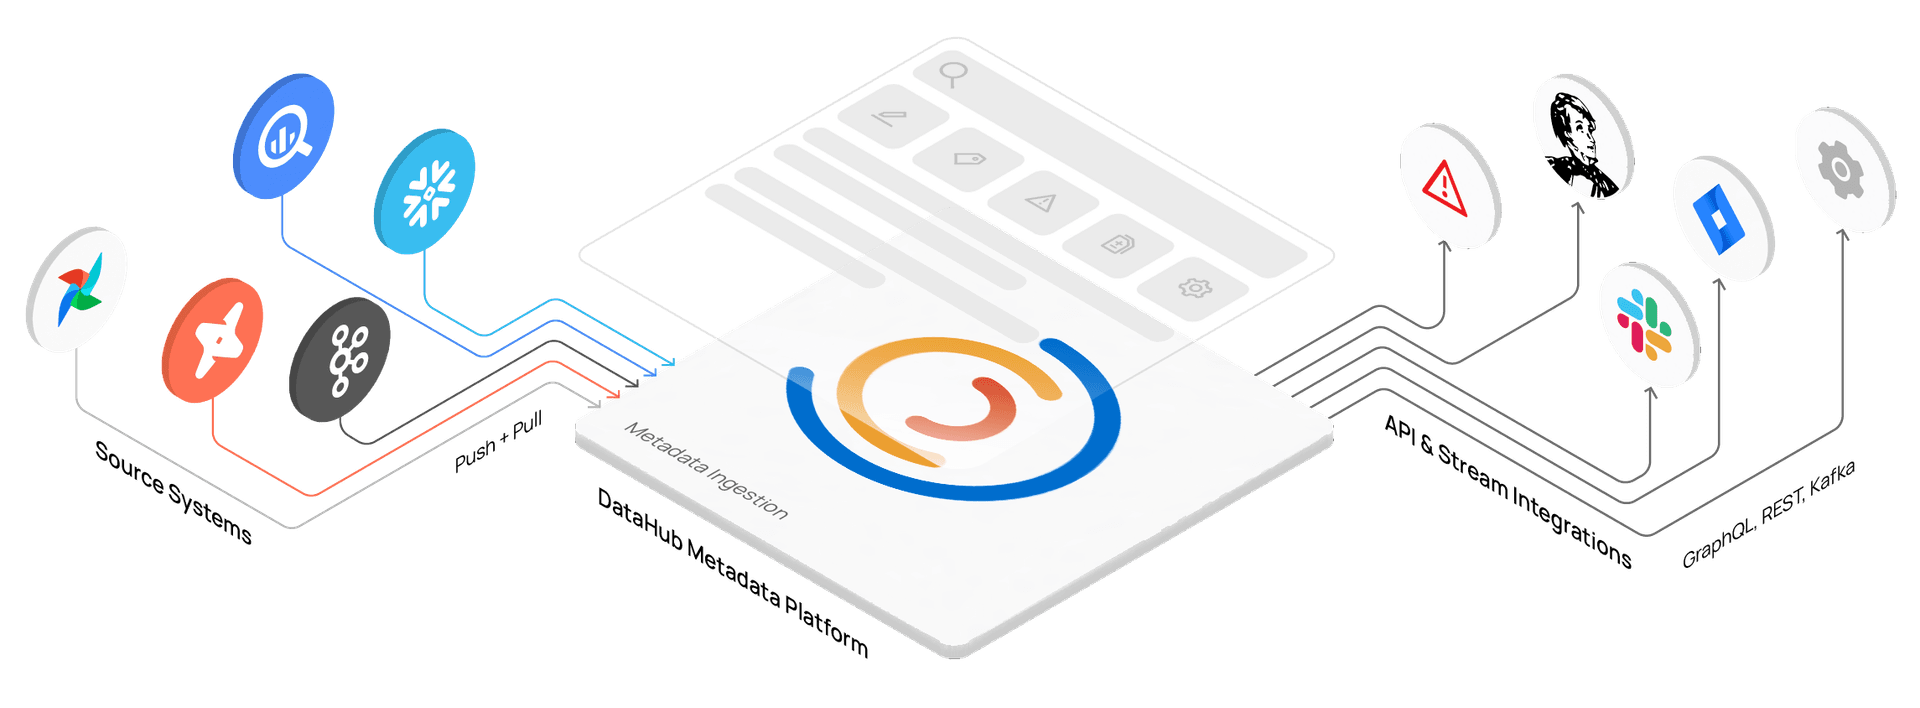
LinkedIn 的数据目录经历了三代:第一代是 Flask 前端 + MySQL + Elasticsearch 的经典单体;第二代是开源的 WhereHows(2016);第三代就是 DataHub(2019),核心跃迁在于引入元数据变更日志(Metadata Change Log)——元数据以事件流的方式持续推送到索引,而不是定期全量拉取扫描。
这个设计决策带来两个质变:一是索引始终新鲜,二是数据血缘(lineage)从"猜测"变成了"事件累加出来的确定事实"。DataHub 现在管理着生产环境里 1000 万+ 资产,列级血缘覆盖 150+ 个数据集成源。
如果把 LLM 比作一个新来的实习生,DataHub 就是公司给他准备的那本厚重的员工档案册——不是介绍照片(那只是 schema),而是完整记录每个人的部门、职级、汇报关系、绩效历史和调动轨迹。
血缘关系就是组织架构图。所以当 Agent 听到"上季度华东区 GMV",它能顺着血缘回溯到这个数字具体由哪个 SQL、哪张表、哪次调度生成,而不是靠猜一个看起来合理的答案。这是从"会说话"到"能查证"的分界线。
1. Context Ingestion(统一上下文接入) 150+ 个连接器把 dbt、Power BI、Confluence、Notion、各种数据仓库的元数据拉进一张统一的上下文图谱。
2. Column-level Lineage(列级血缘) 字段级追踪,是 DataHub 最难也最有壁垒的部分。
3. 官方 MCP Server —— 这是 2026 年最重要的新增 DataHub 提供了官方 Model Context Protocol Server,让任意 AI Agent 通过标准协议查询你的元数据图谱。同时提供 DataHub Skills(search、lineage、enrichment、quality 工作流)和 Analytics Agent(开源的、基于目录问答的 Agent,用你自己的 LLM)。
4. 治理与权限 基于策略的访问控制、断言(assertions)、数据质量监控、所有权与域(Domain)管理。
5. 全家桶工程实践
datahub-agent-context/、datahub-actions/(事件驱动的自动化)、.agent-skills/、.claude/、.cursor/ 目录说明它已经把 Agent 生态当作一等公民。
开发/试用:datahub quickstart 会下载 docker-compose.quickstart-profile.yml 到 ~/.datahub/quickstart,拉起 GMS(Java,8080)、Frontend React(9002)、Kafka、MySQL、OpenSearch、Schema Registry、Neo4j 等一整套。这一步确实是一键的,普通机器 8GB 内存能跑。
生产部署则完全是另一回事:需要拆解 compose 配置、接入真实 Kafka 集群与 MySQL、调优 OpenSearch、配置元数据鉴权、设置密钥与 TLS、监控告警。项目里的 docker/ 目录有 33 个子目录覆盖 mysql/mariadb/postgres/cassandra/elasticsearch/kafka/zookeeper/neo4j 各种组合,datahub-kubernetes/ 另有 K8s manifest。这是本项目最大的真实成本——不是装不上,是装上之后要养。
源码构建门槛也不低:Gradle 多模块 + Java 17 + Python 3.9 + Node(前端),全量构建耗时长。
DataHub 的定位变化很能说明问题:它从"数据目录工具"变成了"面向 AI Agent 的上下文供给层"。看它的 topics 列表——agent-platform、context-management、data-observability——以及 README 标题"The Context Platform for your Data and AI Stack",就知道公司战略重心已经从"给人查数据"转向"给 Agent 查数据"。
横向看,同类有 Lyft 的 Amundsen、Netflix 的 Metacat、Apache Atlas。DataHub 的胜出在于把 Agent 接入做成了官方一等能力(MCP Server + Skills),而不是让社区自己拼装。
适合:已有 Hadoop/Snowflake/Databricks 存量、需要统一元数据治理的中大型团队;正在建设企业级 AI Agent、需要可信上下文底座的团队;需要列级血缘做合规审计的数据团队。
不适合:数据资产只有几张表的小团队;只想查 schema、不需要血缘和治理的用户。
一句话结论:DataHub 是目前开源世界里最完整的"企业上下文底座",尤其值得重视的是它把 Agent 接入做成了官方标准——但它是"养得起才划算"的重型设施。
