
datafoundry
datagallery-lab/datafoundry加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
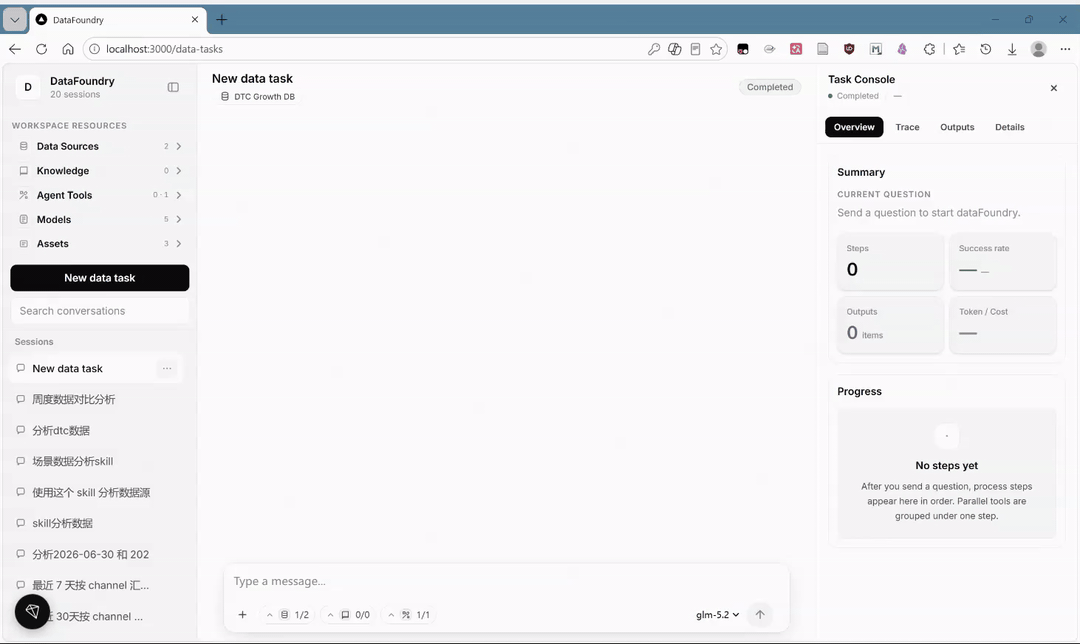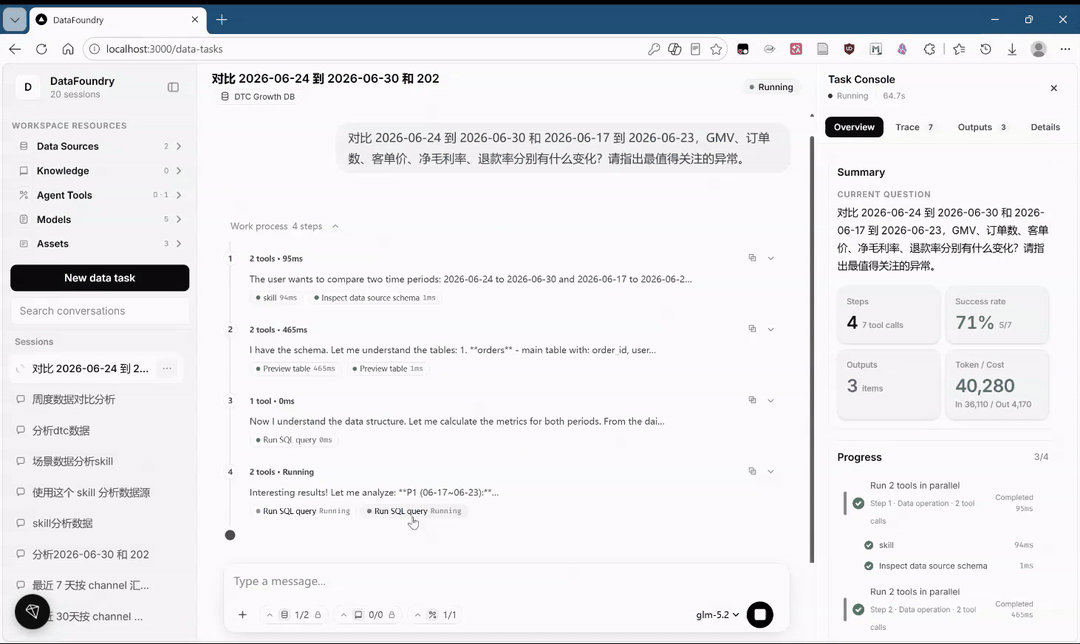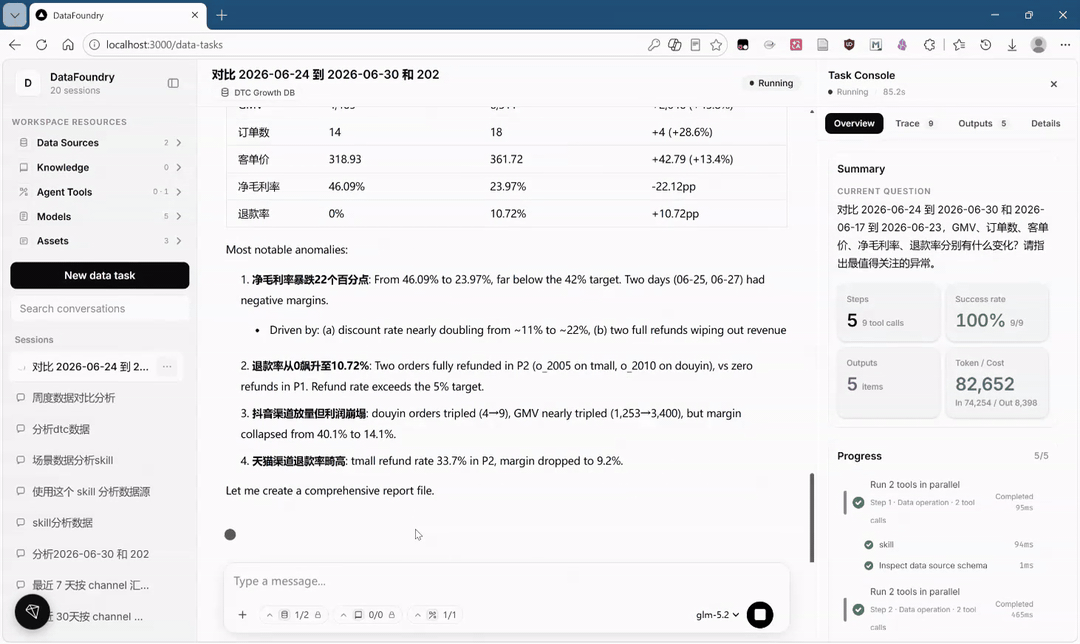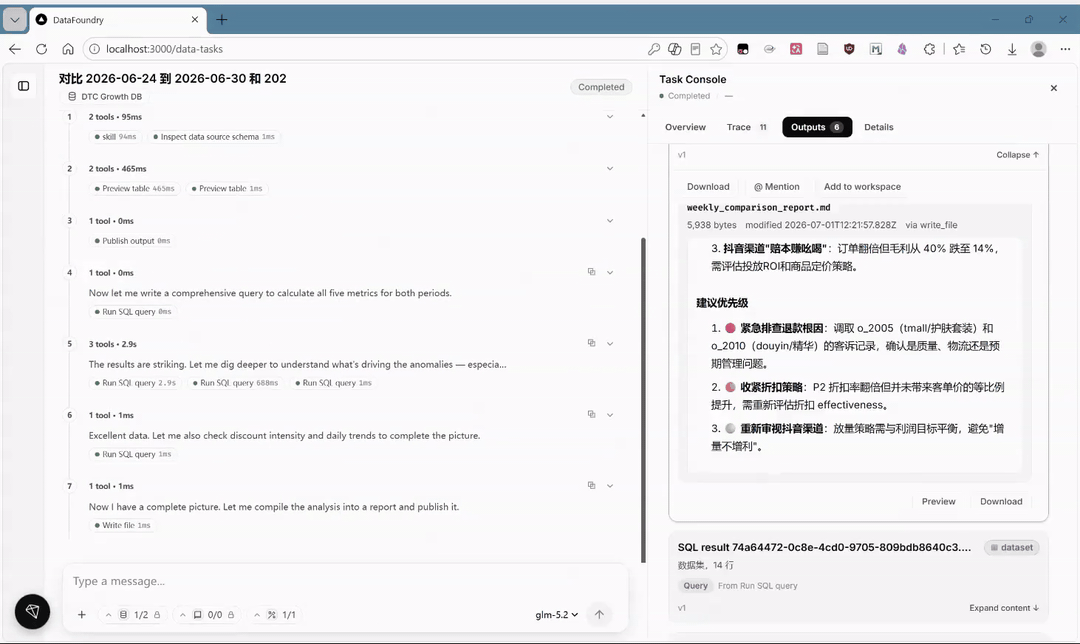
图1:DataFoundry Web 工作台界面
某天晚上,电商公司的数据分析师小林收到老板的消息:「能不能让 AI 帮我们查一下上个月各区域的复购率?」他打开了某款 AI SQL 工具,输入:「上个月各区域复购率是多少?」
AI 秒回了一段 SQL 和答案。小林照着在数据库里跑了一遍,发现数据跑飞了——原来 AI 根本不知道公司的「复购率」口径是「30天内有二次购买的用户」,它按字面意思理解成了「有购买记录的用户」。更糟糕的是,这段 SQL 在测试环境跑没问题,但如果直接在生产库跑,涉及的字段和表关联完全可能引发数据事故。
这个场景揭示了企业数据场景中 AI 落地的真实困境:团队最担心的从来不是「模型会不会写 SQL」,而是:它懂不懂业务口径?会不会误改生产数据?凭据会不会漏进上下文?结论出了问题能不能复盘? 大多数工具把问题简化成 prompt → SQL → answer,demo 惊艳,进企业就卡死。
DataFoundry 正是为解决这个问题而生。它由 DataGallery 实验室开源,是一个企业级 Data Agent 工作台——把 AI Agent 放进一个有语义层、有权限管控、有证据链的数据任务系统里,让自然语言查询升级成可控、可信、可验证的数据工作。
DataFoundry 站在三个成熟开源技术的肩膀上:
@mastra/core)—— Agent runtime 引擎,处理多步推理、工具调用和记忆管理ag-ui-protocol/ag-ui)—— 前后端通信协议,基于 SSE 传输结构化事件流,Web UI 和 TUI 共用同一套 Agent 交互逻辑vadimdemedes/ink)—— 构建 TUI(终端用户界面),同一个 Agent runtime 在终端里也能工作整个项目采用 TypeScript monorepo 架构(npm workspaces),分为 apps/(API、Web、TUI 三端)和 packages/(10个内部包)两大部分。这种架构让 Agent runtime 与 UI 层完全解耦:同一个后端可同时服务 Web 页面、终端界面和第三方产品的 CopilotKit/AG-UI 嵌入。
DataFoundry 将一次数据查询拆解为一条完整链路:提出问题 → 对齐语义 → 受控执行 → 沉淀产出 → 回放复盘
传统 NL2SQL 的核心痛点是 AI 不知道企业的「GMV」对应哪张表、哪个字段、口径是什么。DataFoundry 通过 Data Gateway 强制 schema-first:在 Agent 执行查询前,先让它检查数据源的 schema 和可用上下文,把「复购率」落到真实表和字段上。这大幅减少了字段猜测和错误关联,从根上提升分析准确性。
在 v0.2.0 中,团队引入了自研的 Data Link 技术——将表和字段连接到业务概念、实体、可 JOIN 路径和带置信度的关系,为 Agent 提供更强的语义支撑。
Data Gateway 是整个系统的安全中枢。所有数据源访问都经过这个适配层,默认只读查询,附带 SQL guard(防止危险 SQL 模式)、行数限制、超时控制和字段脱敏。每一条 SQL 都留下审计日志,可在运行历史中完整回放。模型 API Key、数据库凭据和 MCP Token 不会进入 Agent 的 messages 或 context,真正实现了凭据隔离。
DataFoundry 原生支持 28 种数据源类型,覆盖主流关系型数据库(PostgreSQL、MySQL、Snowflake、BigQuery、ClickHouse)、NoSQL(MongoDB、Redis、Elasticsearch)和文件型数据(CSV、Excel、DuckDB、SQLite)。内置 DTC 增长经营复盘案例,开箱即用,无需准备业务数据即可体验完整流程。
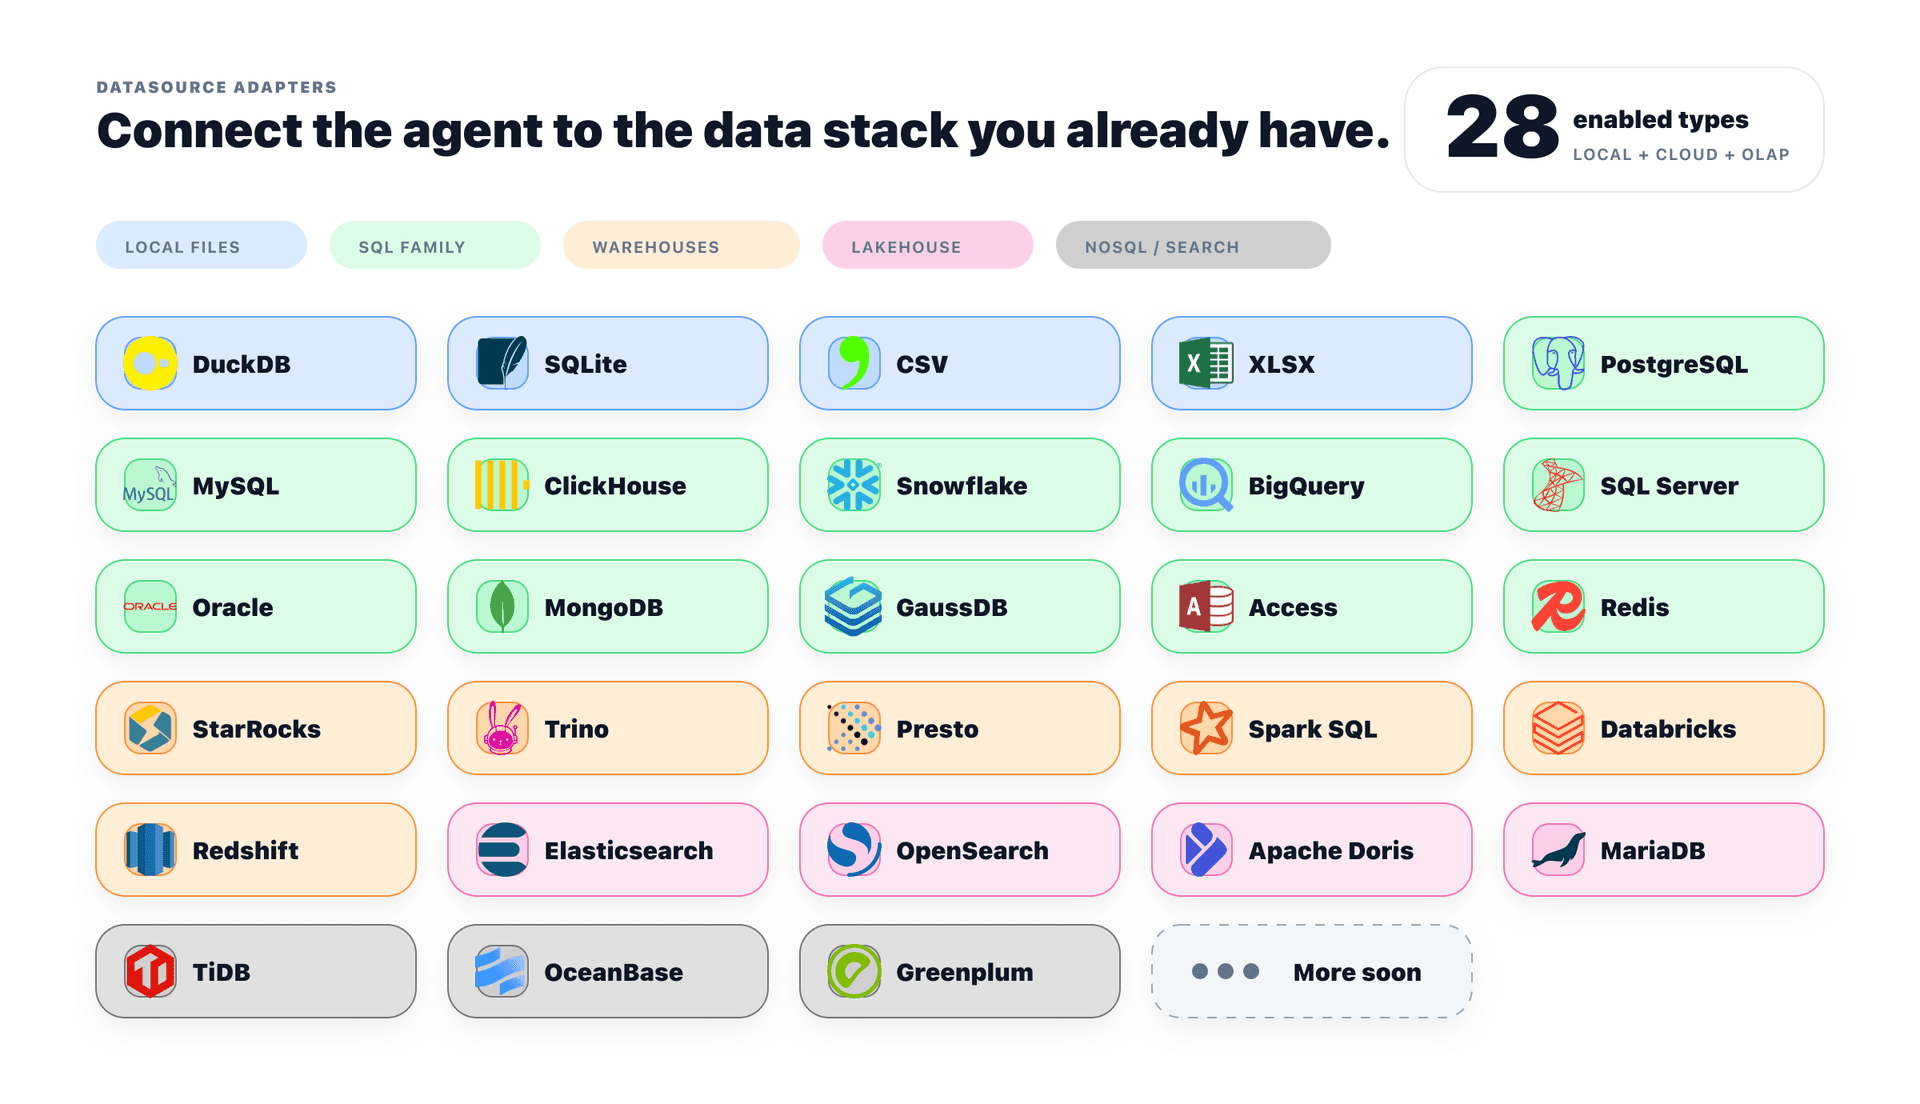
图2:DataFoundry 支持的丰富数据源生态
v0.2.0 引入了一个关键能力:可分支的并发分析。多个会话可同时运行,恢复历史后可以从任意 checkpoint 创建新分支,不覆盖原分析路径。这解决了 AI 分析中「想对比不同假设」的真实需求——你可以从同一个起点出发,探索两条不同的分析路径。
DataFoundry 提供了三种交互方式:Web 工作台(Next.js,适合日常分析)、TUI(Ink 终端,适合远程服务器)和 REST API + CopilotKit/AG-UI(嵌入自己的产品)。
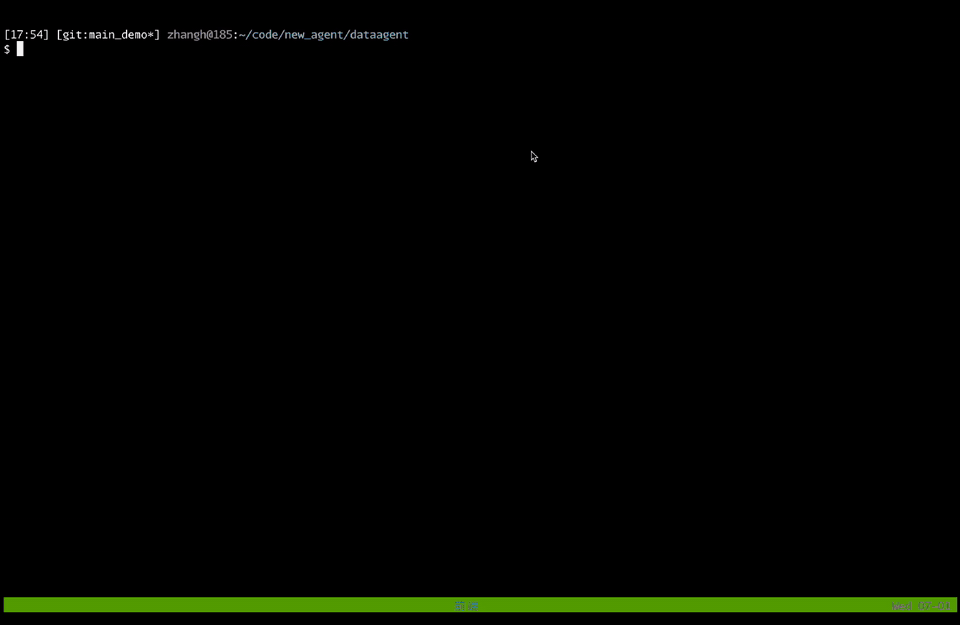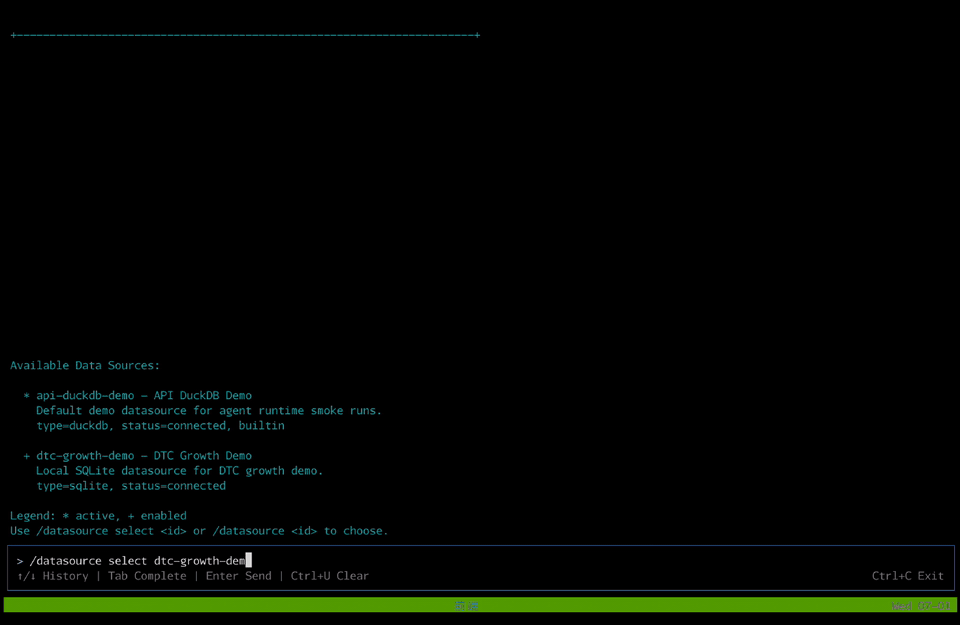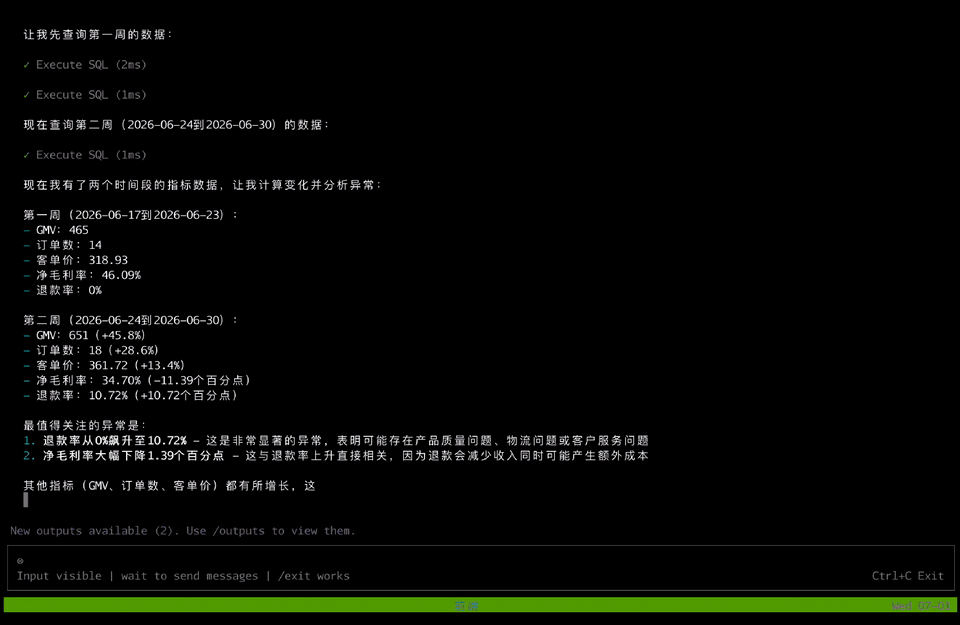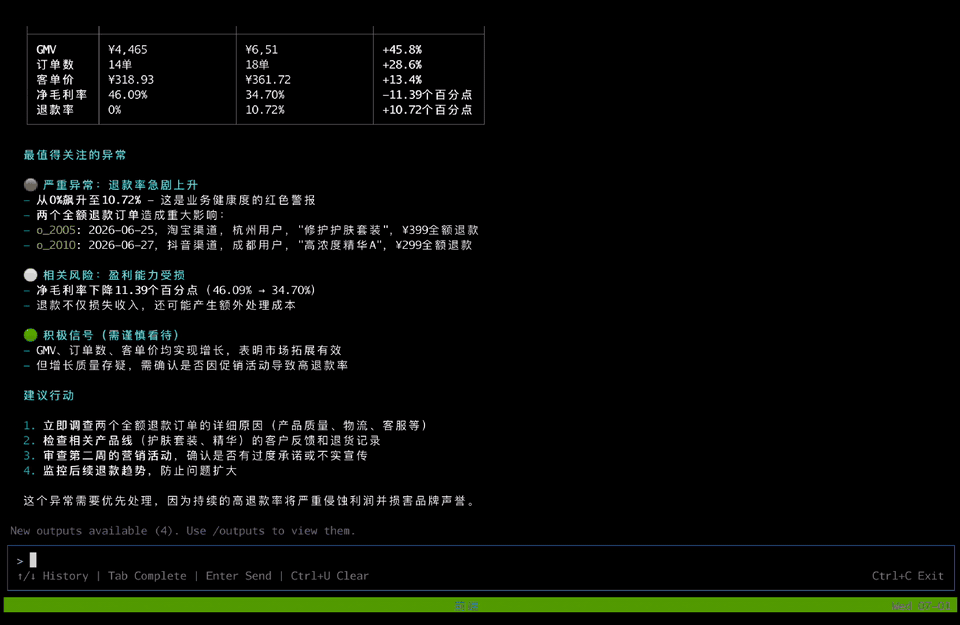
图3:DataFoundry TUI 终端界面
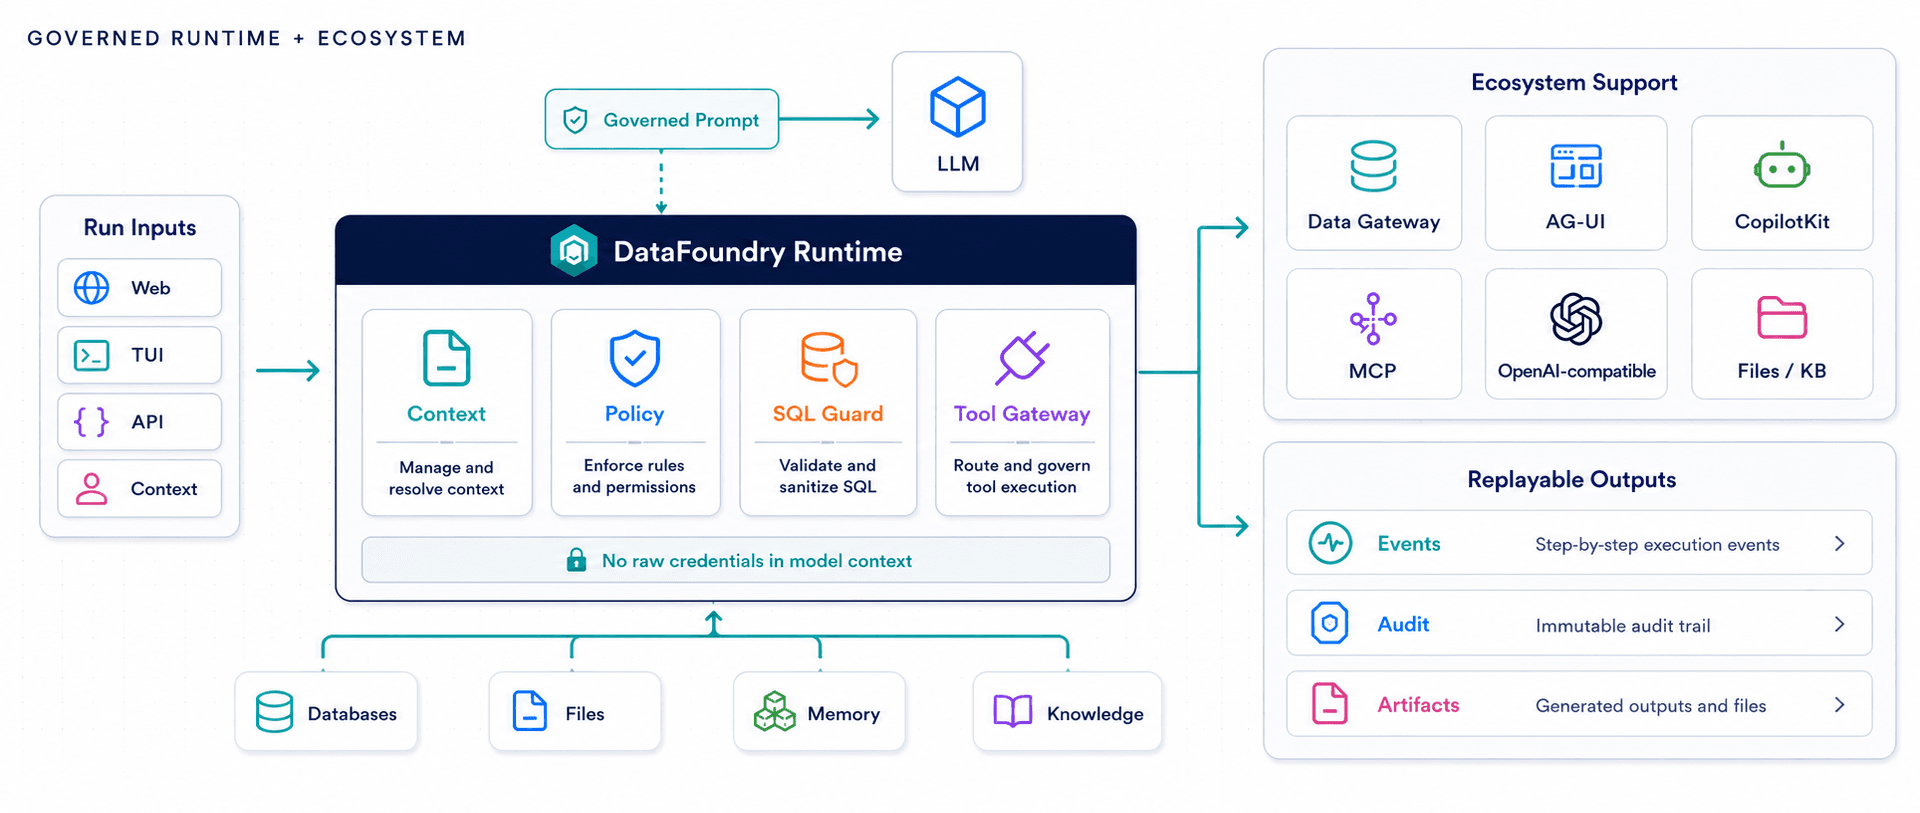
图4:DataFoundry 数据任务运行全流程
datafoundry/
├── apps/
│   ├── api/      # REST API 服务(Node.js,端口 8787)
│   ├── web/      # Next.js Web UI(端口 3000)
│   └── tui/      # Ink 终端界面
├── packages/
│   ├── agent-runtime/   # 核心,基于 Mastra 的 Agent runtime
│   ├── providers/       # LLM provider 适配(OpenAI-compatible)
│   ├── data-gateway/    # 数据源适配层 + 安全管控
│   ├── skills/          # 技能包(builtin/data-analysis 等)
│   ├── knowledge/       # 知识库支持
│   ├── artifacts/       # 产出物管理(表格、图表、报告)
│   ├── files/          # 文件管理
│   ├── metadata/       # 元数据管理
│   └── contracts/      # 类型协议
├── deploy/              # 部署配置(nginx)
└── docs/                # 完整文档(英文 + 中文)
核心依赖:@mastra/core(v1.46.0)Agent 编排引擎、@ag-ui/core(v0.0.57)AG-UI 协议、@mastra/memory Agent 记忆管理、@ai-sdk/openai 模型调用、zod(v4.2.1)运行时类型验证。100% TypeScript,Zod 做严格类型校验,整体质量评分较高。
部署难度为中等(3/5),需要 Node.js >= 22 环境且需配置 LLM API Key。但内置 DTC 案例数据无需额外准备:
git clone https://github.com/datagallery-lab/datafoundry.git
cd datafoundry
npm install
cp .env.example .env
# 编辑 .env,填入 LLM API Key(支持 OpenAI-compatible,qwen/deepseek/gpt 均可)
npm run build
npm run start:api    # 端口 8787
npm run start:web    # 端口 3000
打开 http://127.0.0.1:3000/login 注册登录,进入 /data-tasks,直接提问即可体验。局限:目前没有 Dockerfile 或 docker-compose,生产环境需要自己写部署脚本或使用 PM2/Supervisor 管理进程。
v0.2.0,仍在进化中:项目明确标注状态为「early but usable」,部分功能尚不完整:
NL2SQL 赛道已经非常拥挤。从开源的 Vanna.ai、SQLCoder,到各路 SQL Chatbot,都在解决「让非技术人员查数据库」的问题。但大多数产品停留在「demo 好用」阶段,原因是缺少三个关键能力:
DataFoundry 在这三个维度上都做了系统性设计。它代表了企业 AI 数据分析工具的一个新方向:不是让 AI 替代数据分析师,而是给数据分析师一个可信的 AI 协作环境。对于需要私有化部署、对数据安全有要求的企业,DataFoundry 值得重点关注。
