dataagent
datagallery-ai/dataagent加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
加载项目详情…
本应用为开源项目,仅供学习研究,请遵守其开源协议。
想象一下这个场景:业务部门提了一个问题——"第三季度华北区域的复购率是多少?"你打开一个 AI 工具,输入这个问题,AI 返回了一个数字。你敢直接用这个数字做决策吗?
大多数人的第一反应是:不敢相信。
原因很现实:AI 真的理解"复购率"在你公司的定义吗?它用的是哪张表、哪个口径?会不会改了我的生产数据?凭据会不会泄露?事后出了问题,我该怎么复盘?
这些问题,传统的 prompt → SQL → answer 模式根本回答不了。DataFoundry 正是为解决这些问题而生——它不是又一个"AI 写 SQL"的工具,而是一套把 Agent 放进语义层、权限层和审计层的企业级数据任务系统。
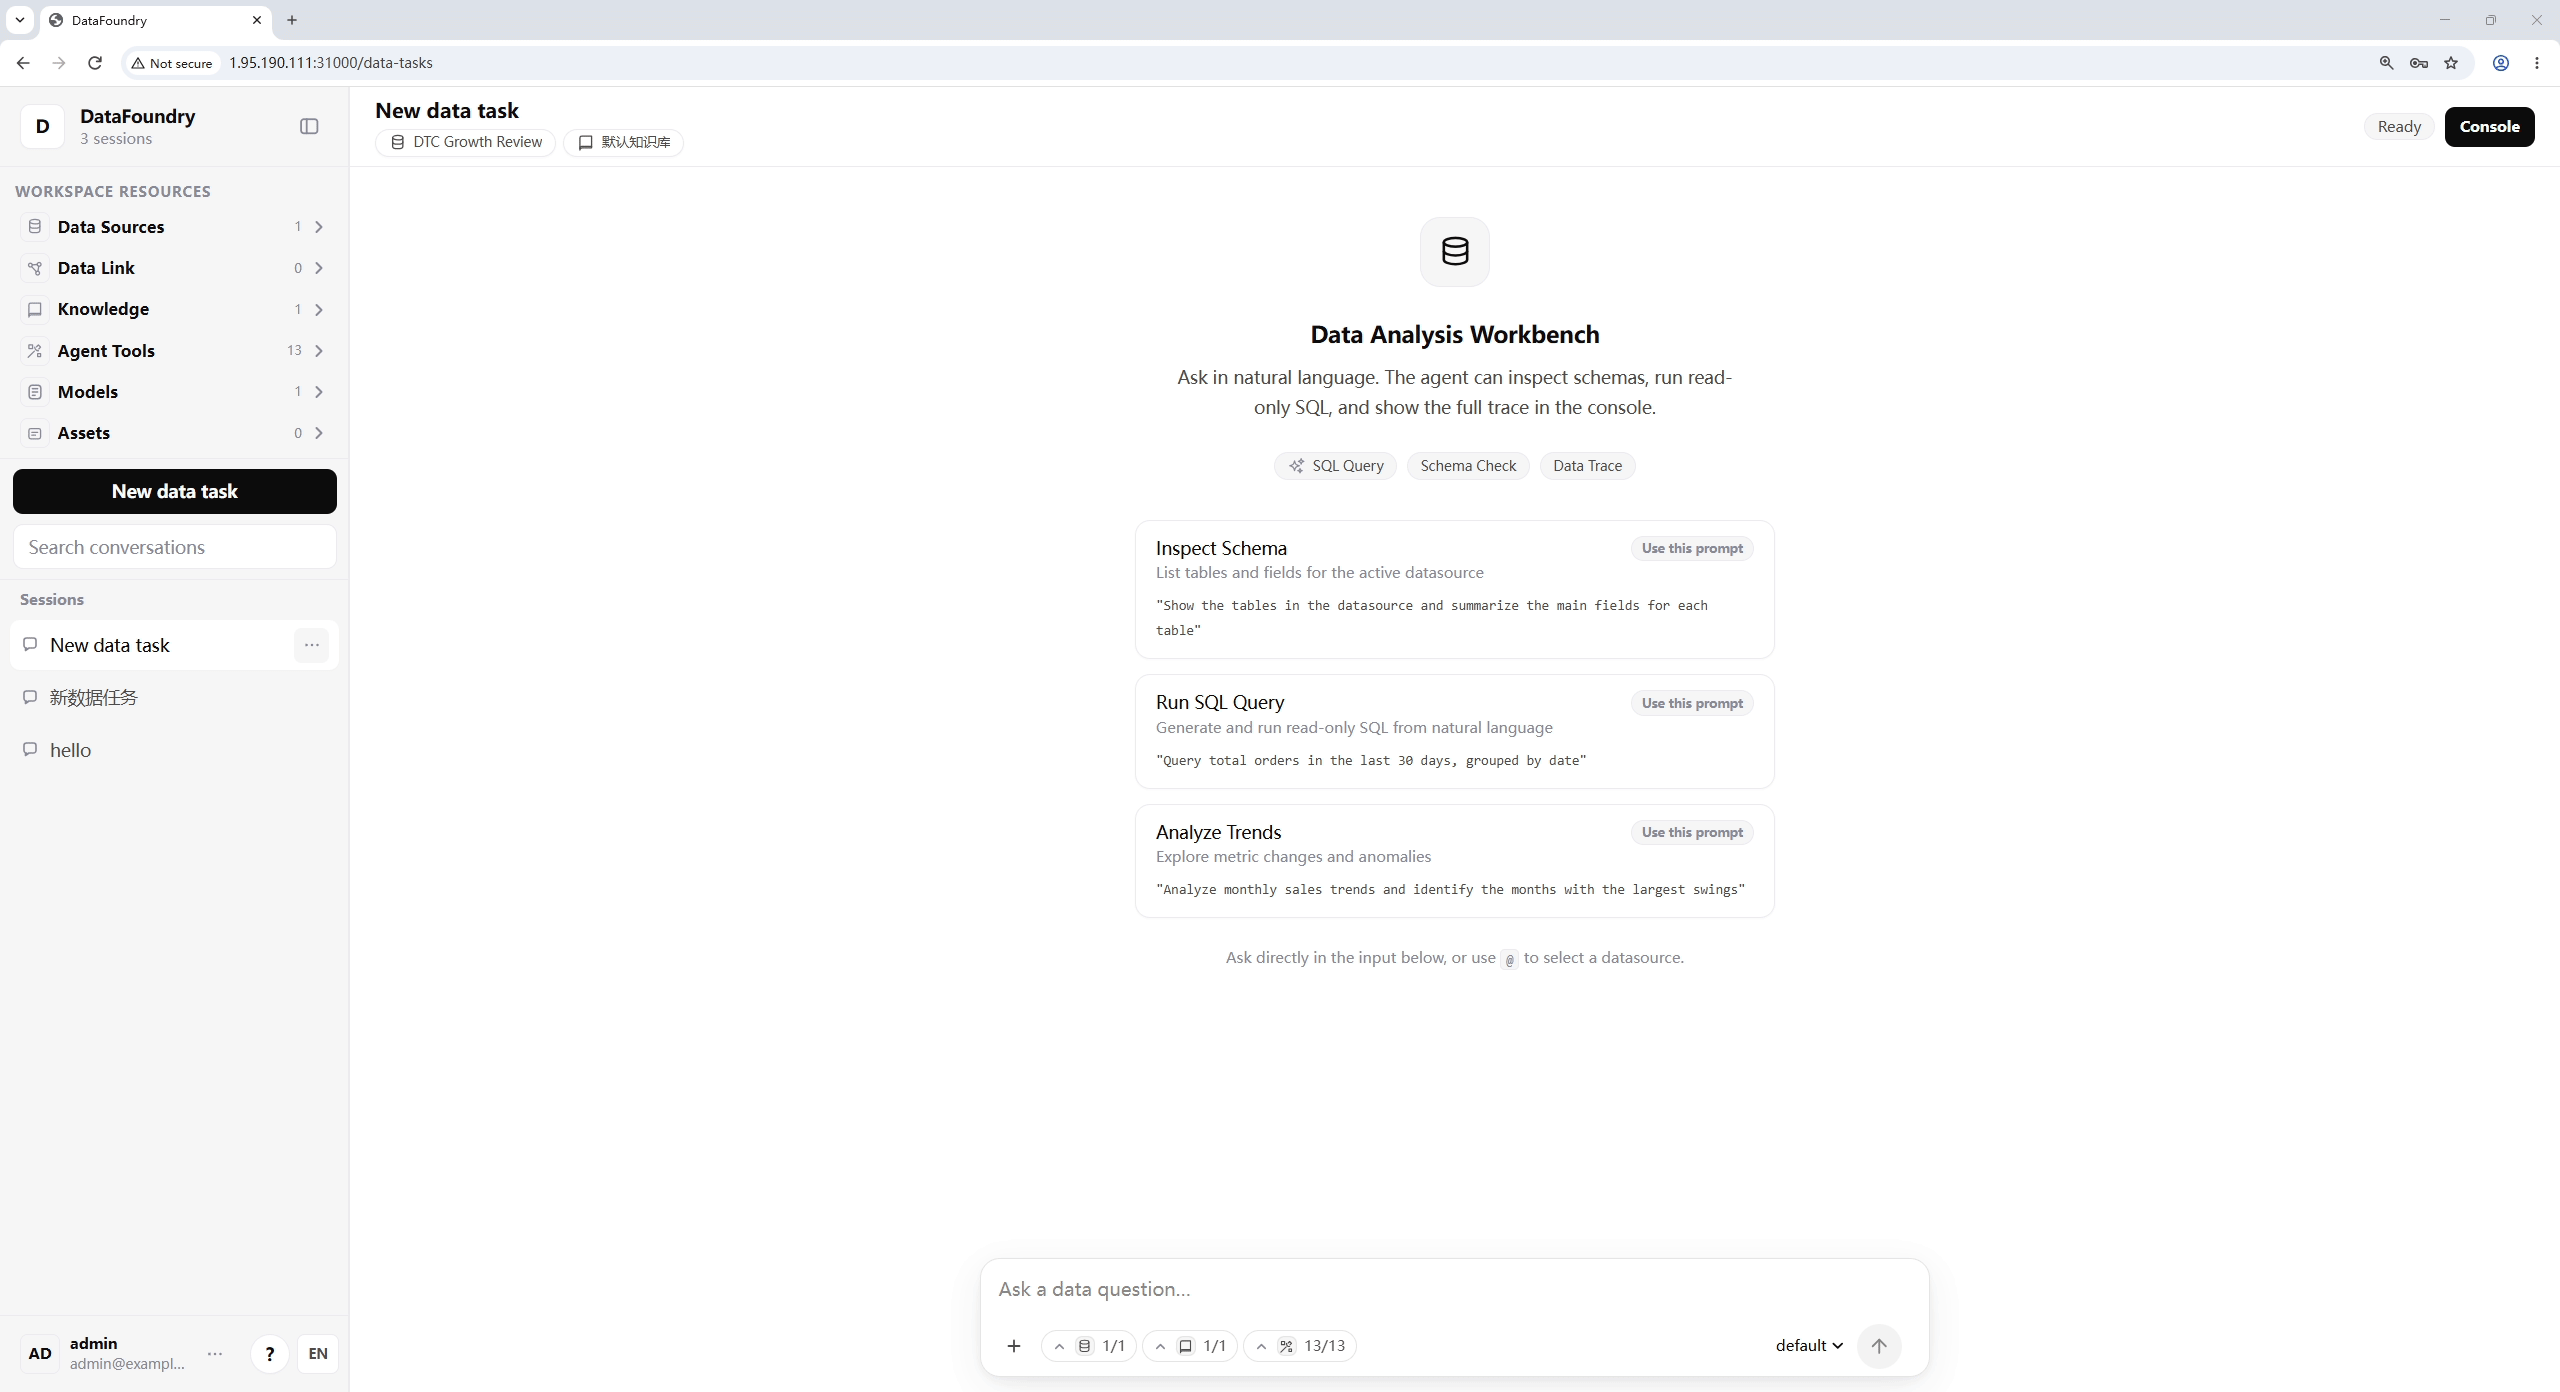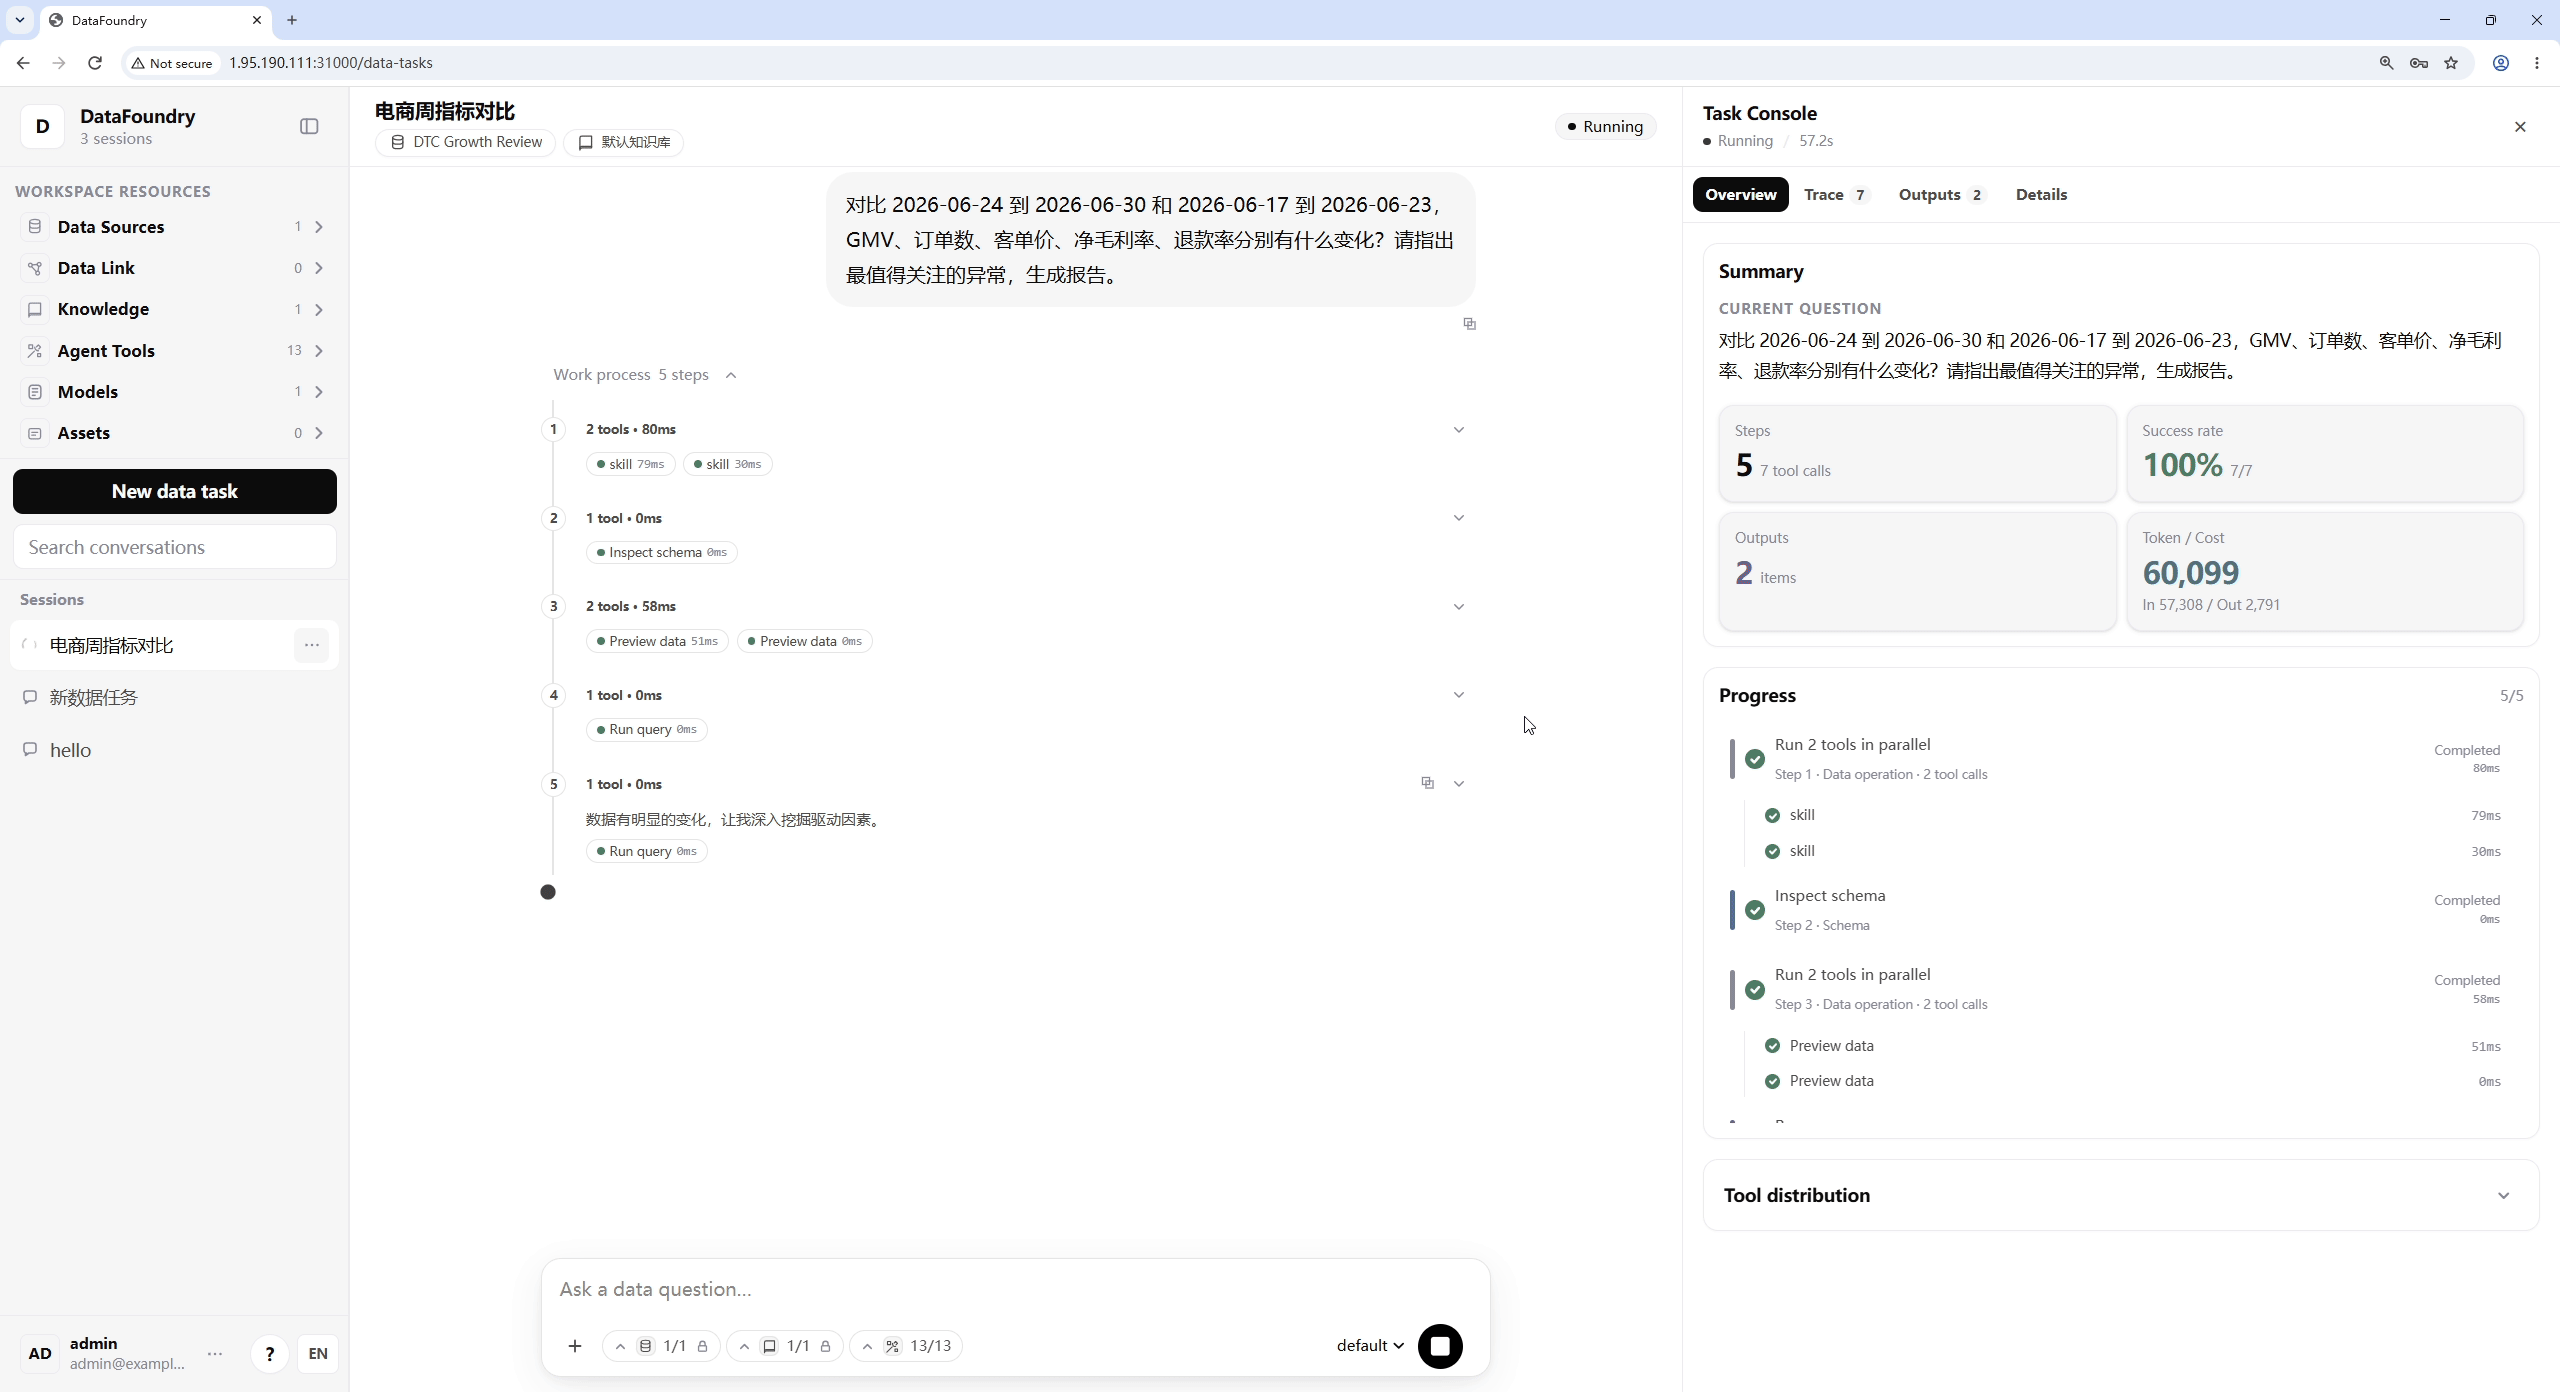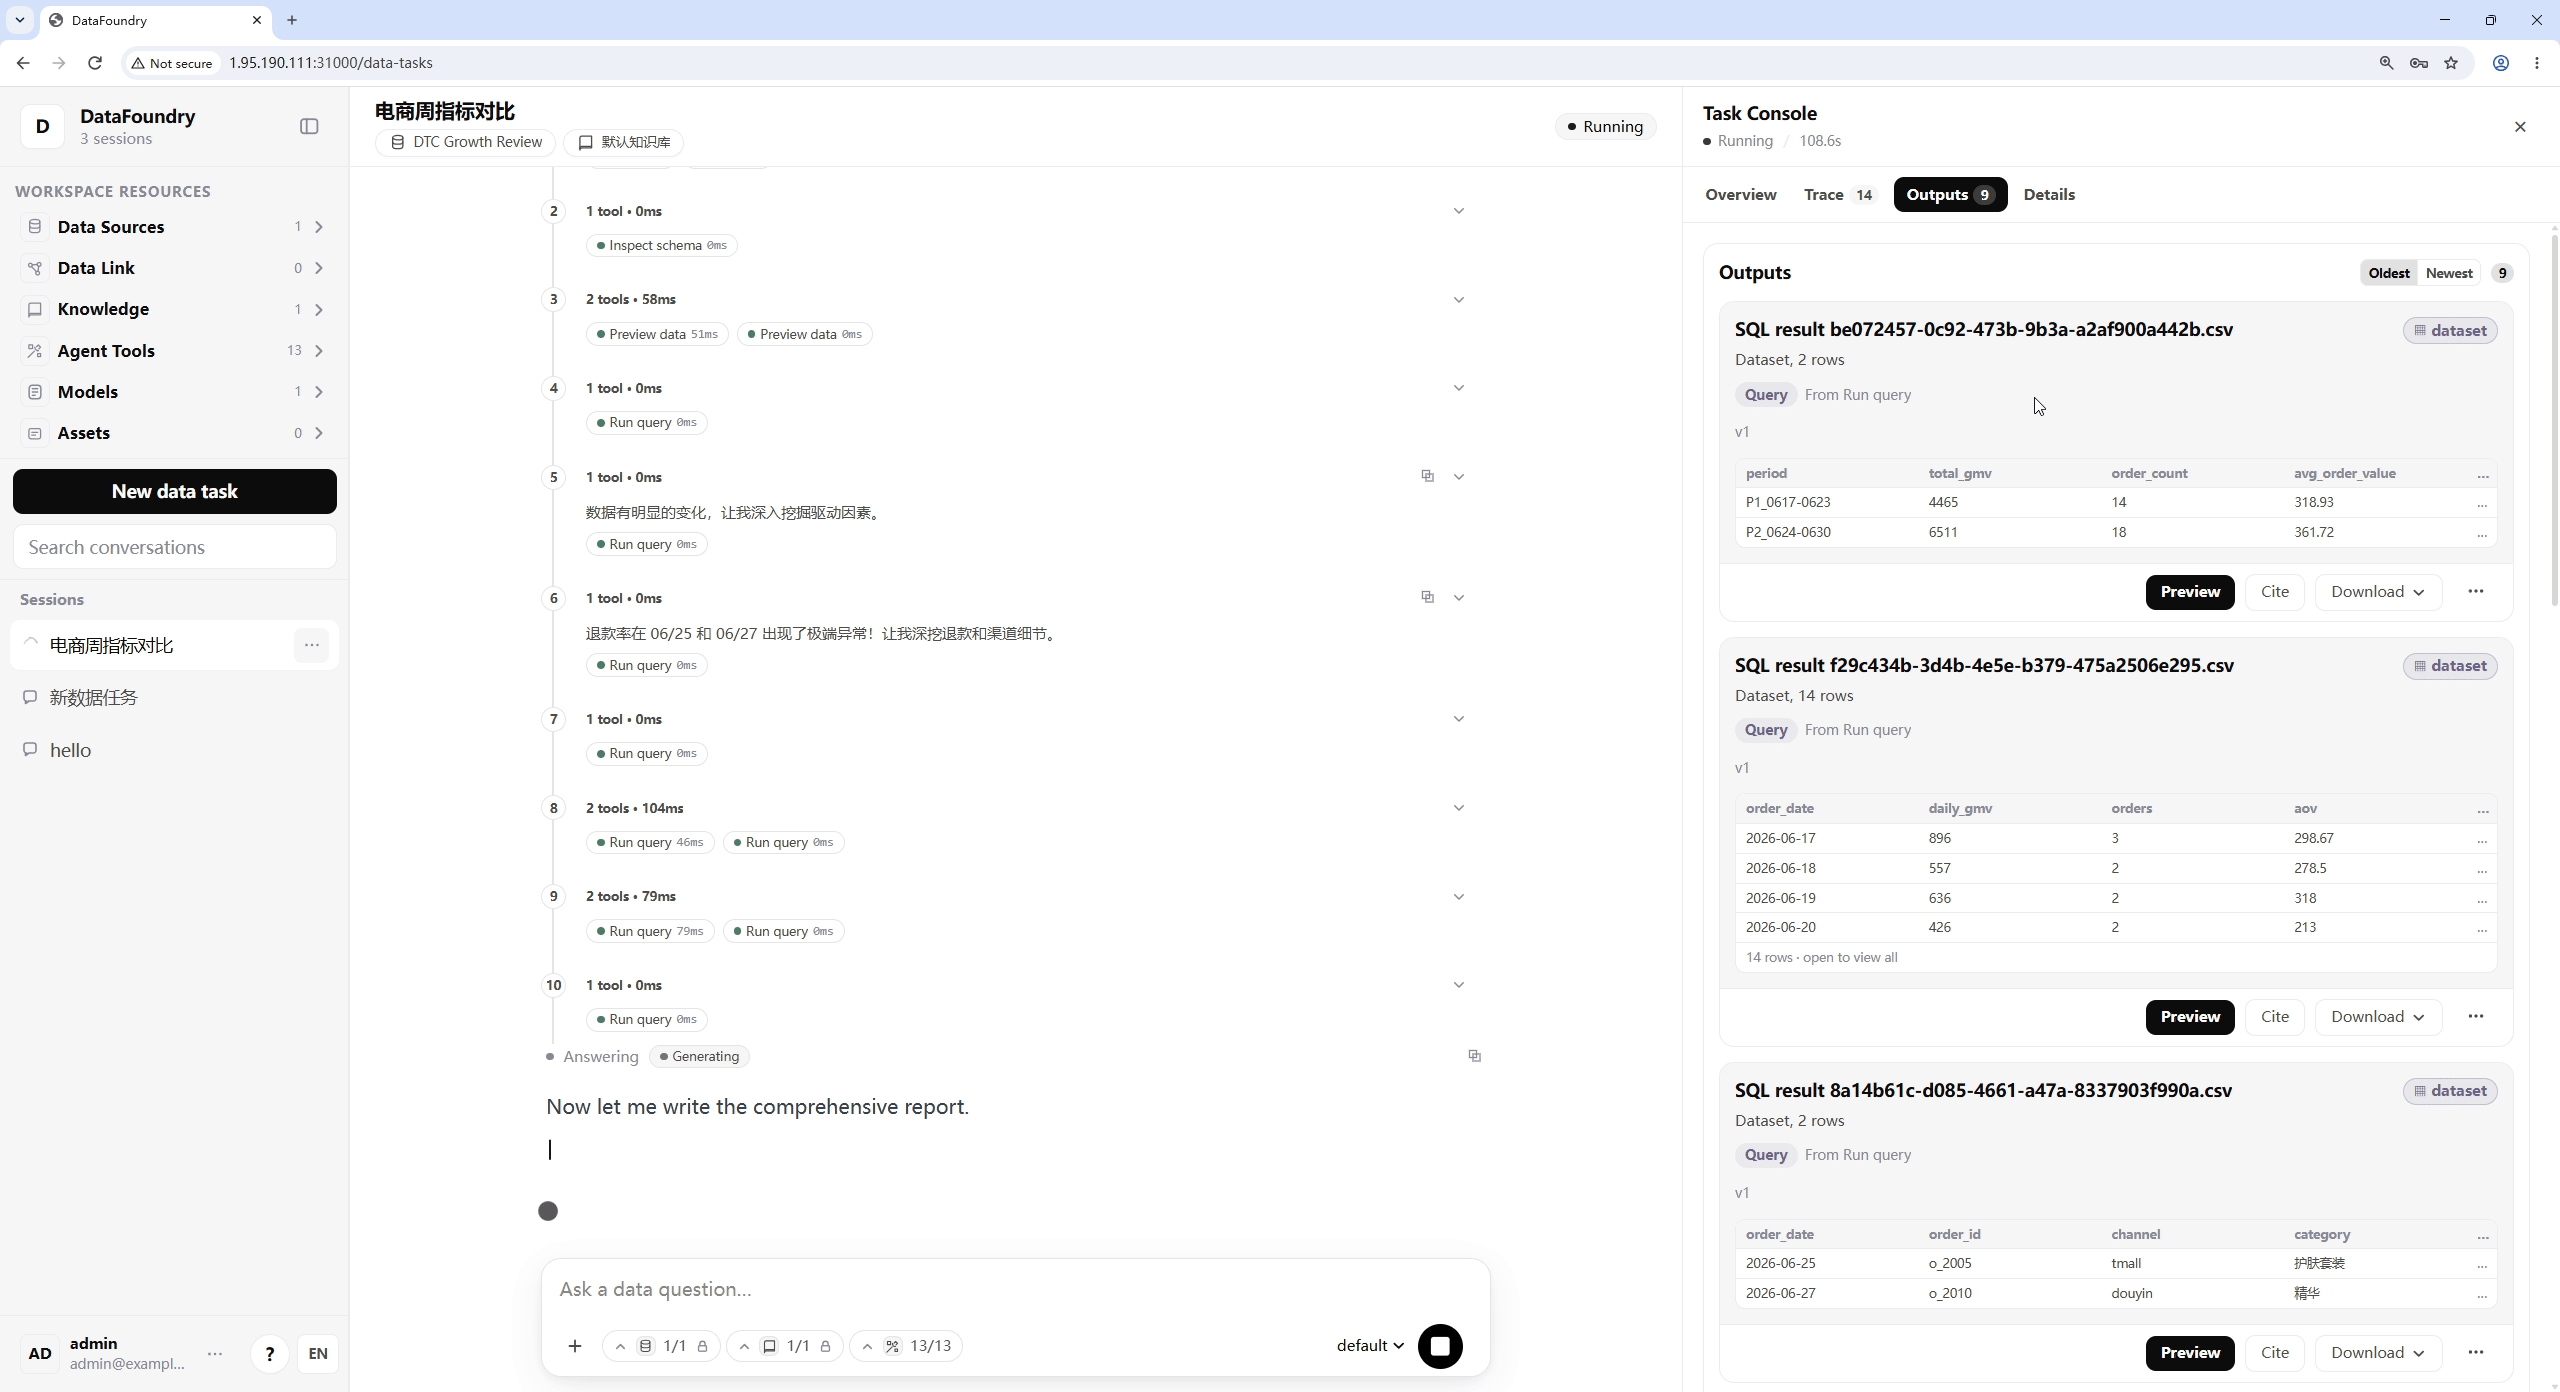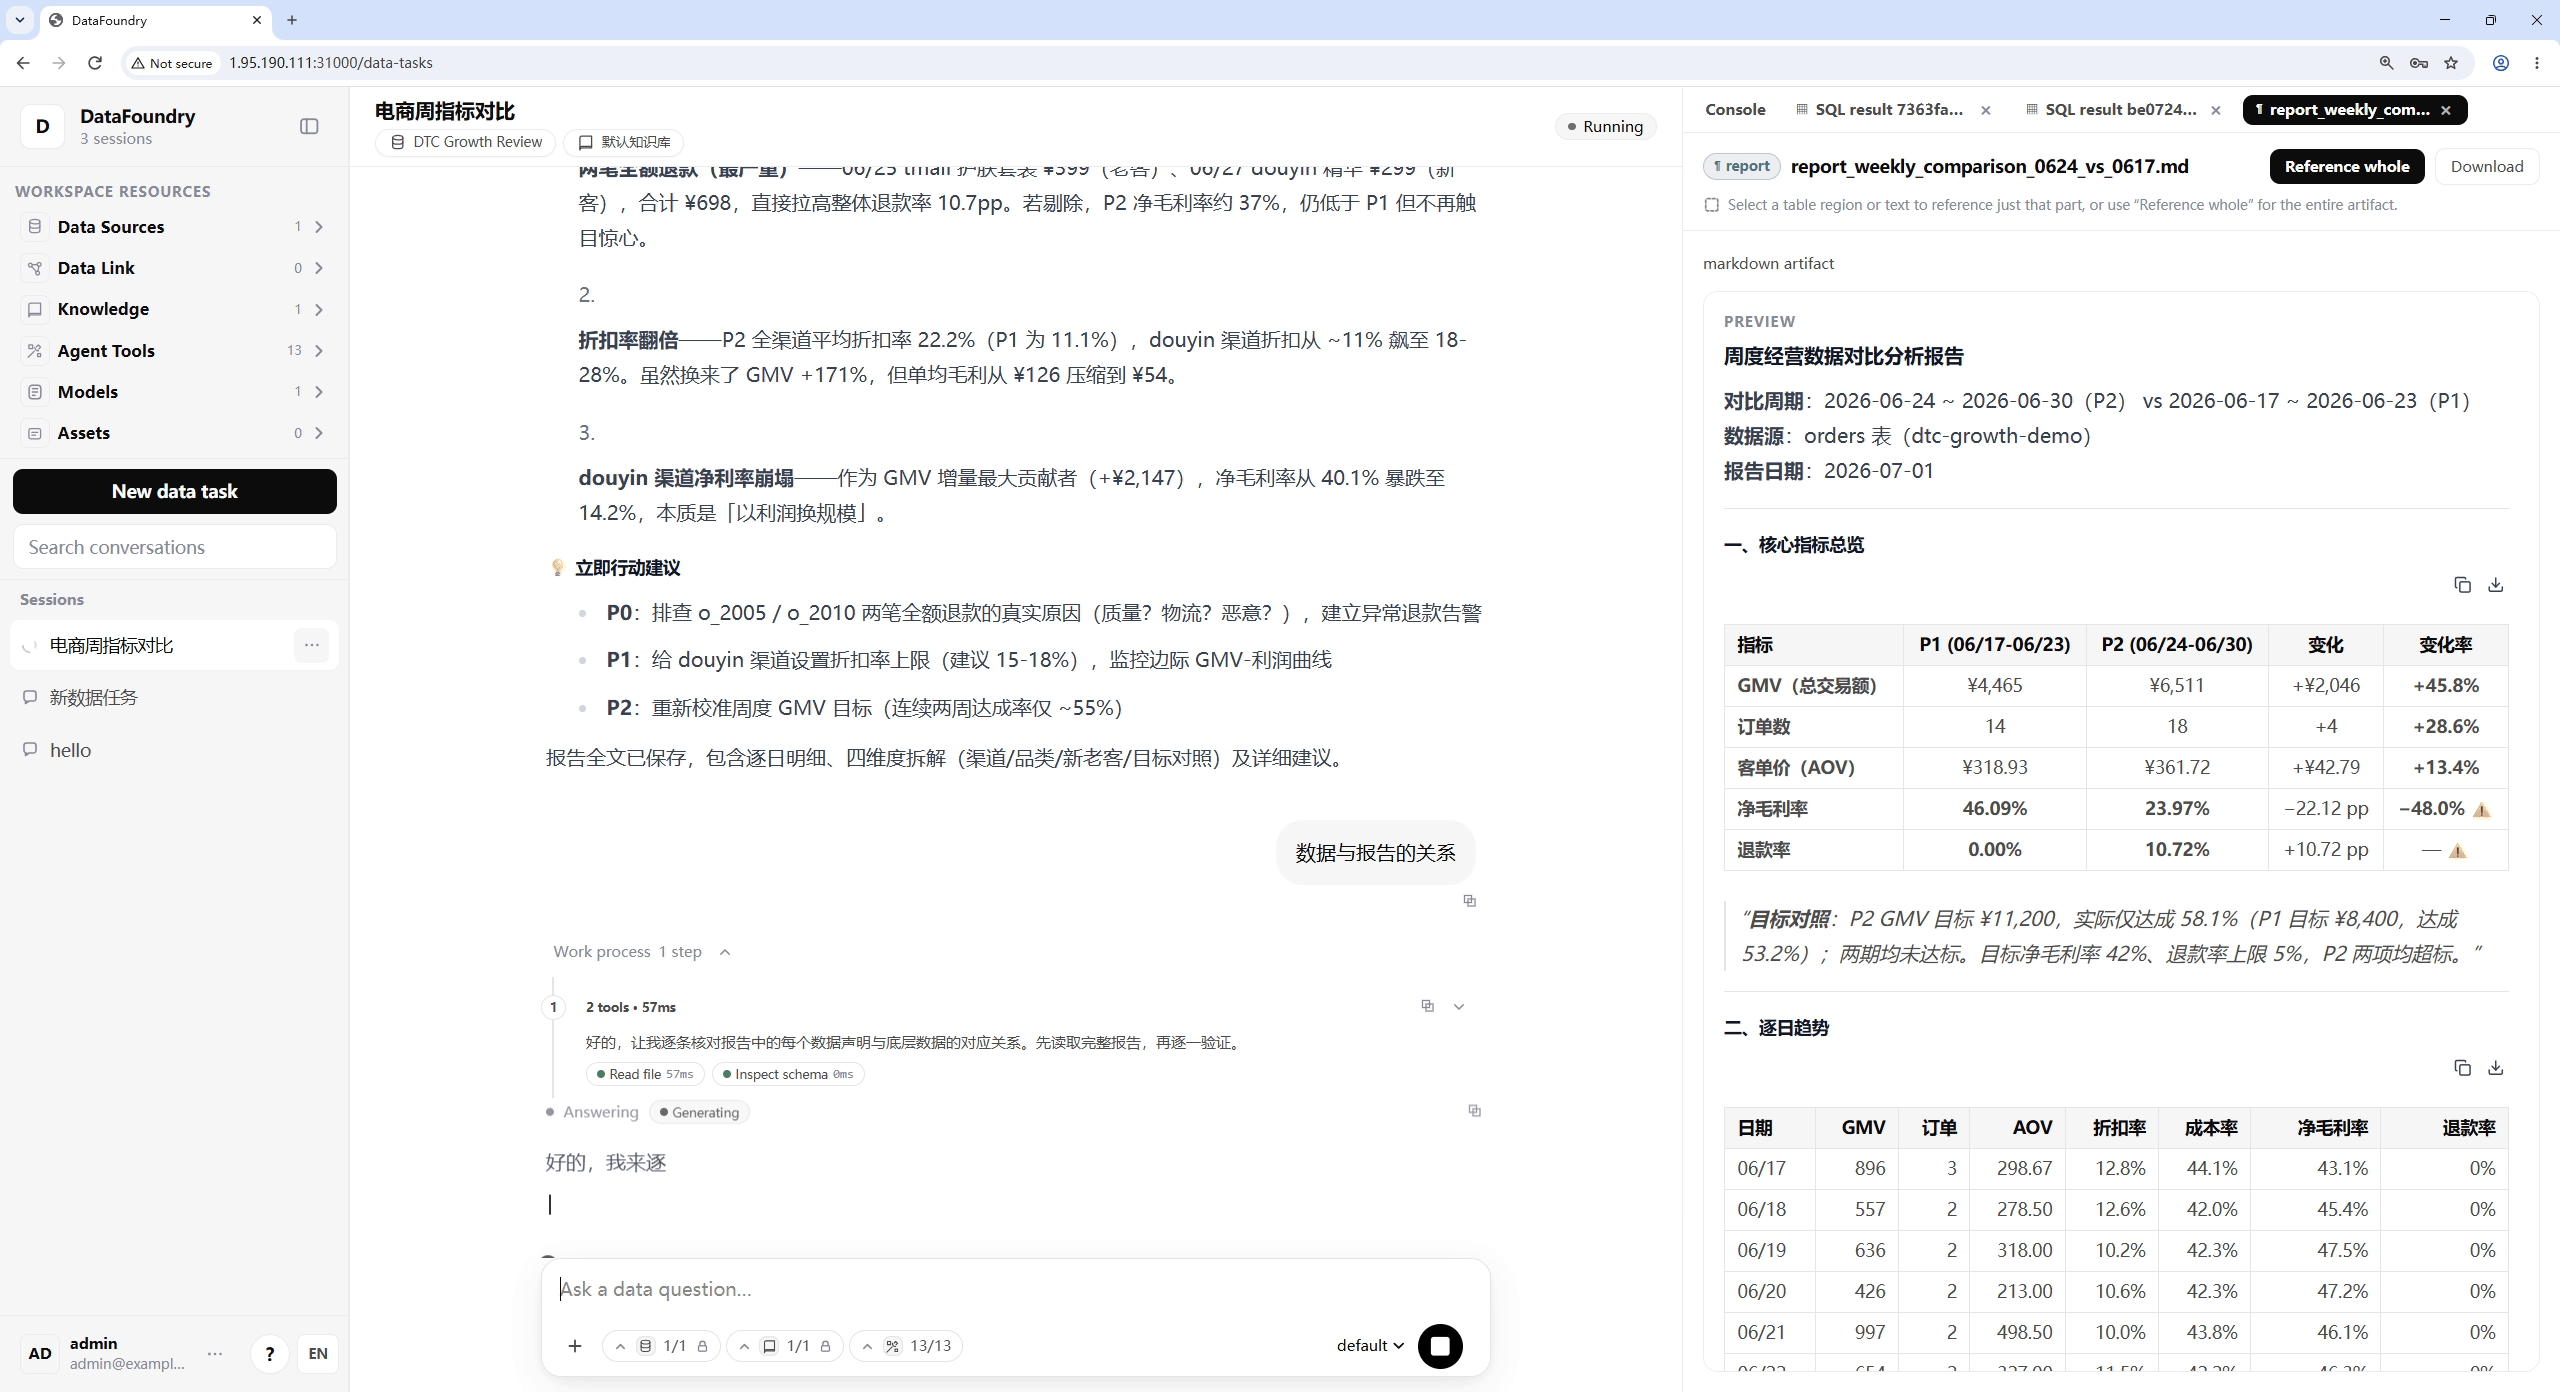
DataFoundry 由 DataGallery 团队开发,GitHub 仓库 stars 759、forks 105,是其 DataAgent 产品线的开源实现。
DataGallery 在企业 AI 数据领域有真实的落地经验。据 AI Magazine 报道,DataGallery 的技术已在国内某头部银行落地,为约 20,000 名数据分析师和 200,000 名管理和营销人员提供自然语言数据访问和 Agent 辅助分析服务。这不是 demo,是真实的生产级验证。
DataFoundry 的定位是数据领域的 Agent 基础设施:DataGallery 负责语义上下文、权限管控和效果评估,DataFoundry 负责将自然语言查询转化为可信、可控、可追溯的数据工作。
DataFoundry 开箱支持 28 类数据源,包括 PostgreSQL、MySQL、Snowflake、BigQuery、ClickHouse、MongoDB、Redis、Elasticsearch 等。无论企业数据在本地数据库还是云端数据仓库,都能快速打通,无需重复造轮子。
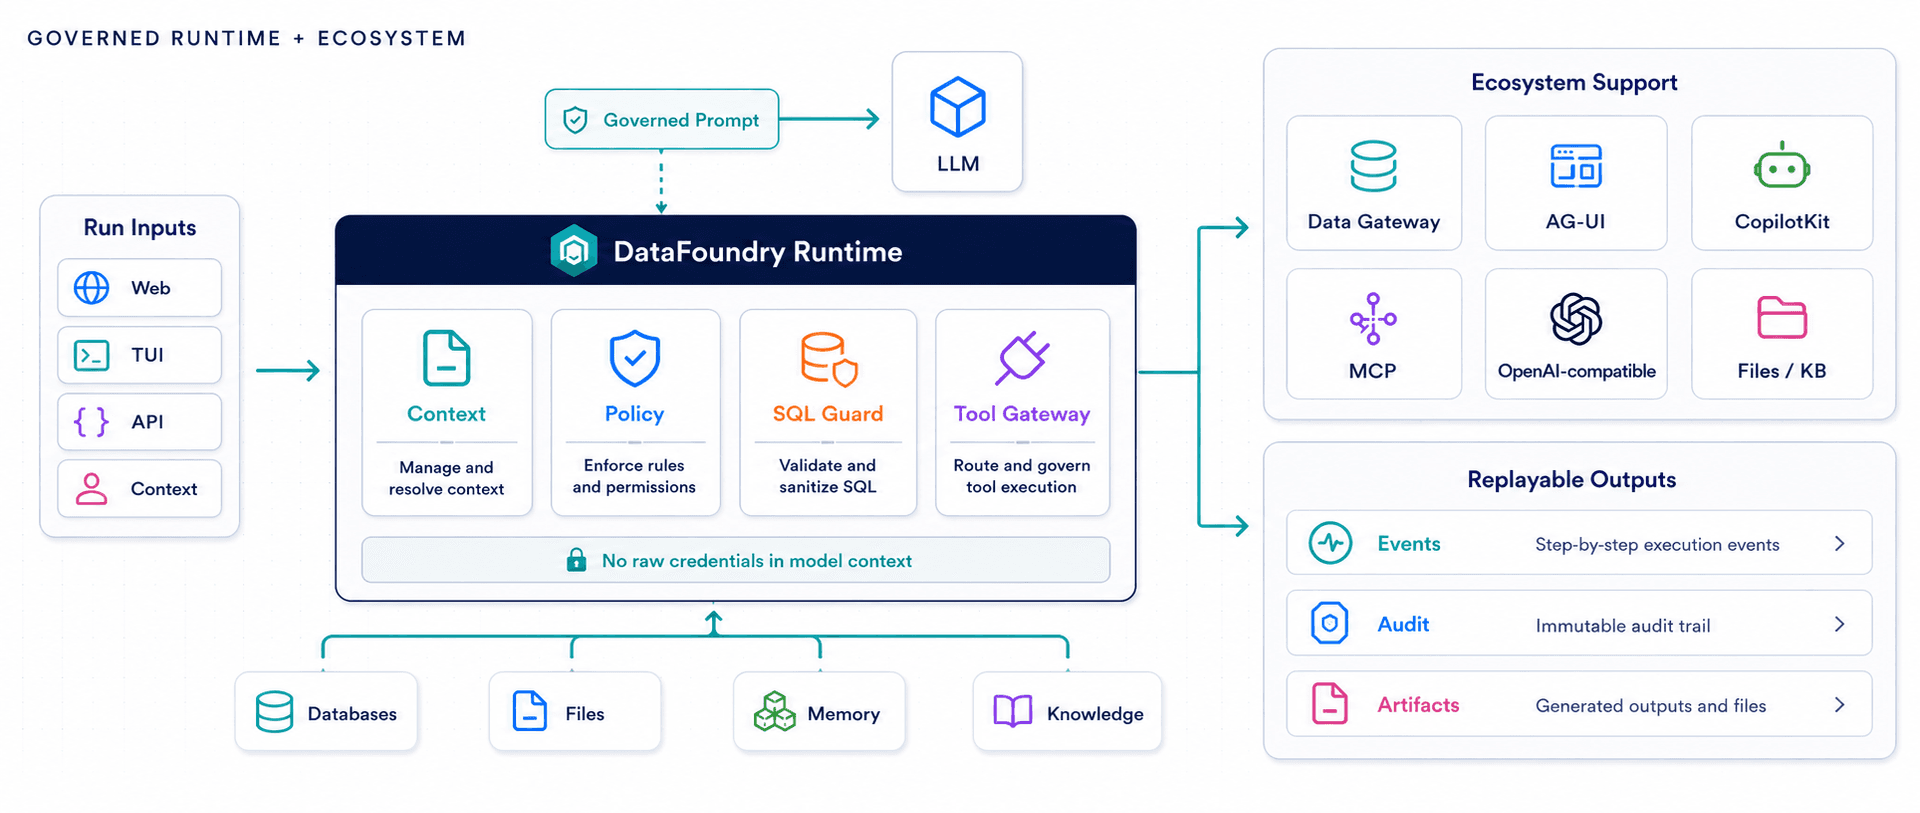
传统 NL2SQL 的核心问题是语义不对齐——"GMV"在不同部门可能指不同的表和字段。DataFoundry 引入统一语义引擎(Unified Semantic Engine),统一管理 schema、指标口径和字段关系。
举一个具体例子:当用户问"本月活跃用户数"时,系统不是简单匹配"user"字段,而是通过语义层理解"活跃"的定义(如最近 30 天有登录行为)、引用正确的用户表和时间范围,确保口径与企业业务定义一致。
DataFoundry 的安全设计是"从架构上强制",而非依赖 prompt 约束:
不同于简单的一问一答,DataFoundry 面向多表、多字段、多步骤的复杂分析任务。Agent 会将复杂问题逐步拆解、验证每一步的结果、收敛到可信结论,最终以表格、图表和报告形式输出。这些产出可以沉淀为团队共享的工作区资产。
DataFoundry 采用 TypeScript Monorepo 架构,仓库组织清晰:
datafoundry/
├── apps/
│   ├── api/        # Node.js REST API(端口 8787)
│   ├── web/        # Next.js Web UI(端口 3000)
│   └── tui/        # Ink 终端 UI
├── packages/
│   ├── agent-runtime/    # Agent 运行时核心
│   ├── data-gateway/     # 数据源网关
│   ├── knowledge/        # 知识库管理
│   ├── metadata/         # 元数据与语义层
│   ├── skills/           # Agent Skills
│   └── ...               # contracts, files, artifacts 等
└── services/
    └── datalink/         # DataLink 语义连接服务
核心技术栈:
| 组件 | 技术选型 | 说明 |
|---|---|---|
| Agent 运行时 | Mastra | 开源 AI Agent 框架,支持多模型、多工具 |
| 前端 UI | Next.js + AG-UI 协议 | 事件流驱动 UI,支持实时 Agent 交互 |
| 终端 UI | Ink | React风格的终端界面框架 |
| 数据连接 | MCP (Model Context Protocol) | 标准化数据源接入协议 |
| 编排工具 | CopilotKit | AI Copilot 集成框架 |
| Python 沙箱 | venv (numpy/pandas/matplotlib/scikit-learn) | 数据分析执行环境 |
值得注意的是,项目对多个新兴协议和框架的整合:AG-UI(事件流协议)、Mastra(Agent 运行时)、Ink(终端 UI)和 CopilotKit,说明 DataFoundry 的目标是成为这些新兴标准的参考实现,而非自建封闭生态。
DataFoundry 的定位是面向有数据工程能力的技术团队。部署需要:Node.js >= 22、配置 LLM API Key(默认通义千问)、接入数据源、配置语义层(定义业务口径)。这不是一个"下载就能用"的工具,而是需要一定定制化投入的企业级平台。
Unified Semantic Engine 的价值在于口径一致性,但这也意味着语义层需要人工定义和维护。随着业务增长,语义层需要持续迭代,这是隐形的维护成本。
项目未提供 Dockerfile 或 docker-compose,不支持 Kubernetes。这对于已容器化的企业基础设施来说是个遗憾。官方仅提供 deploy.sh 脚本 + nginx 配置示例,生产部署需额外工程工作。
版本为 v0.2.0,README 自述"early but usable"。在大规模并发、多租户场景下的稳定性尚未经过充分的社区验证。
DataFoundry 背后反映的趋势是:企业 AI 应用正在从"能力展示"走向"生产就绪"。过去两年,行业看到了大量 NL2SQL 工具,但在真实企业中落地者寥寥——核心原因不是 AI 写不出 SQL,而是缺少语义层、权限层和审计层的配套。
DataFoundry 的贡献在于,它把 Agent 不是一个简单的 SQL 生成器,而是一套完整的数据任务操作系统。这个方向与 Palantir Foundry、Databricks Unity Catalog 等企业数据平台的思路一致,但以开源方式实现。
据 Thomson Reuters Institute 分析,2026 年企业 AI 能否规模化,取决于"数据 foundry"——即能否建立一套可控、可信、可追溯的数据工作流基础设施。DataFoundry 正处于这一趋势的前沿。
DataFoundry 需要 Node.js >= 22。克隆仓库后:
git clone https://github.com/datagallery-ai/dataagent
cd dataagent
cp .env.example .env
# 编辑 .env,配置 LLM_PROVIDER、LLM_API_KEY 等
./deploy.sh
Web UI 访问 http://localhost:3000,API 服务在 http://localhost:8787。详细文档见 datagallery-lab.github.io/datafoundry。
| 维度 | 评价 |
|---|---|
| 定位 | 企业级 Data Agent 工作台,非玩具 demo |
| 核心优势 | 28 类数据源、语义层、只读安全、全程审计 |
| 技术亮点 | Mastra + AG-UI + Ink + MCP 全协议整合 |
| 适用场景 | 有数据工程能力的企业团队,需要可信的 AI 数据分析 |
| 门槛 | 中等偏高,需要配置语义层和数据源 |
| 容器化 | 暂不支持,需手动部署 |
| 成熟度 | v0.2.0,有真实生产案例但社区尚在早期 |
DataFoundry 是一个有真实企业落地经验背书的开源项目。它解决的不是"AI 能不能写 SQL",而是"AI 能不能在企业数据治理框架下可信地工作"。对于需要严肃对待数据安全与口径一致性的团队,它值得关注。
